Resumir contenido con:



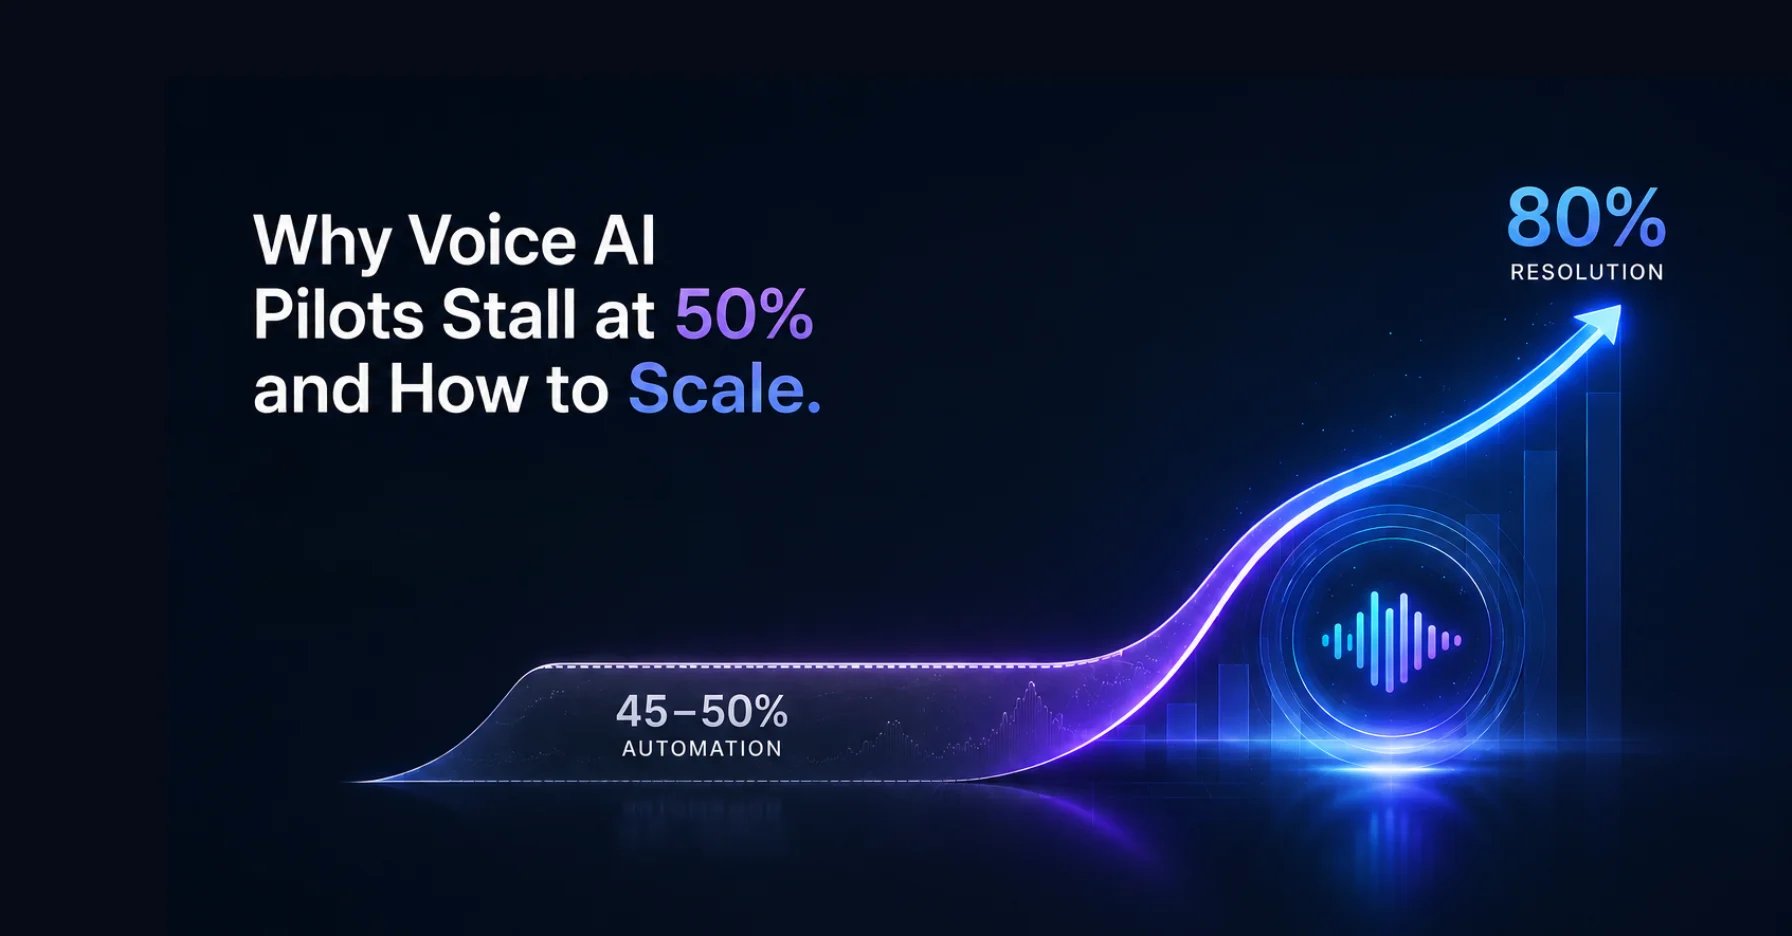
Por qué los pilotos de IA de voz se estancan en el 50% y cómo escalar hasta el 80% de automatización
Tu piloto de IA de voz lleva tres meses en funcionamiento y resuelve automáticamente alrededor del 45% de las llamadas entrantes. Parece una cifra aceptable, pero se ha estancado. Lo que la mayoría de las organizaciones pasa por alto es que el problema rara vez reside en el modelo de IA en sí. Todo se reduce a cinco cuellos de botella concretos en la infraestructura, la gestión del conocimiento y el diseño de las escalaciones. Esta guía detalla por qué los pilotos de IA de voz se bloquean en la zona del 40 al 50 por ciento y qué palancas permiten llevar las tasas de automatización al 80% y más allá.
Los datos del sector de 2026 ofrecen una imagen clara: el 80% de las empresas planea integrar IA de voz antes de fin de año, el mercado global crecerá de 2400 millones de dólares (2024) a una proyección de 47 500 millones para 2034, y los despliegues en producción han aumentado un 340% interanual en más de 500 organizaciones. Sin embargo, el 60% de los despliegues de IA de voz fracasan en los 90 días posteriores al lanzamiento en producción, no porque la tecnología no funcione, sino porque la transición del piloto a la escala se subestima sistemáticamente.
La trampa del 50%: por qué tu piloto se estanca
Cuando un asistente telefónico con IA gestiona la mitad de todas las llamadas, parece un progreso. En realidad, esa cifra marca un punto de inflexión típico donde cinco cuellos de botella chocan simultáneamente:
1. Alucinaciones por modelos sin base de conocimiento. Sin una base de conocimiento estructurada, el modelo de lenguaje genera respuestas que suenan convincentes pero que son simplemente erróneas. Los LLM sin base muestran una tasa de alucinación del 15 al 30%; con la base adecuada, esta cae por debajo del 5%. La base de conocimiento no es una función opcional, es el cimiento de una automatización fiable.
2. Falta de integración con el backend. Si el agente de voz no puede acceder a tu CRM, calendario o sistema de gestión de pedidos en tiempo real, cada llamada que supere las preguntas frecuentes terminará en una transferencia. Una clínica dental en Múnich que utiliza Famulor solo puede automatizar las reservas de citas si el agente tiene acceso directo al calendario; sin esa conexión, la tasa de resolución se mantiene en el 40%.
3. Clasificación incorrecta de los tipos de llamada. No todas las llamadas son aptas para la automatización. Las consultas sencillas como saldos de cuenta (tasa de resolución del 75-90%) o restablecimiento de contraseñas (80-95%) funcionan de maravilla. Las quejas complejas, sin embargo, solo alcanzan el 10-25%. Tratar todos los tipos de llamada por igual reduce el promedio.
4. Transferencias en frío sin contexto. Cuando el agente de IA transfiere una llamada a un humano sin proporcionar un resumen de la conversación, el cliente tiene que empezar de cero. Esto destruye las puntuaciones CSAT y genera nuevas llamadas. Las transferencias estructuradas con transcripciones de la conversación no son algo opcional, son esenciales para la satisfacción del cliente.
5. La brecha entre la demo y la producción. En el entorno de demostración, el agente responde en 730 milisegundos. Bajo carga, con 500 llamadas simultáneas, la latencia aumenta a 1400-3400 ms, un descenso del 92 al 365%. Cada 100 ms por encima de los 800 ms aumenta la tasa de abandono en aproximadamente un 2,5%. Lo que convenció a las partes interesadas en la demo falla en el mundo real debido a la infraestructura.
Tasas de resolución por tipo de llamada: qué es realmente automatizable
Antes de escalar, necesitas una imagen realista de qué tipos de llamadas pueden alcanzar qué tasas de automatización. Estos puntos de referencia se basan en datos de más de 500 organizaciones:
| Tipo de llamada | Tasa de automatización | Prioridad de escalado |
|---|---|---|
| Restablecimiento de contraseña / acceso a cuenta | 80–95% | Empezar de inmediato |
| Consultas de saldo de cuenta | 75–90% | Empezar de inmediato |
| Estado del pedido / seguimiento | 70–85% | Fase 1 |
| Reserva de citas | 65–80% | Fase 1 |
| Preguntas frecuentes / políticas | 55–70% | Fase 2 |
| Disputas de facturación | 40–60% | Fase 2 (con backend) |
| Resolución de problemas técnicos | 35–55% | Fase 3 |
| Quejas complejas | 10–25% | Recomendado humano |
Los promedios combinados del sector para llamadas aptas para el Nivel 1 se sitúan en el 45-60%. El comercio minorista y electrónico alcanza el 55-75%, los servicios financieros el 50-70%, la atención sanitaria el 40-60% y las empresas SaaS el 45-65%. La clave es empezar con tipos de llamadas sencillos y de gran volumen e ir ampliando gradualmente.
El plan de 5 pasos: del piloto del 50% a la producción del 80%
Paso 1: Define métricas de referencia. Antes de optimizar, mide el statu quo: tiempo medio de gestión por tipo de llamada, coste por llamada, tasa de resolución y CSAT. Sin una base, no sabrás si los cambios funcionan. Plataformas como Famulor ofrecen paneles de KPI integrados que capturan automáticamente estas métricas y las desglosan por tipo de llamada.
Paso 2: Crea una base de conocimiento estructurada. La mayor palanca contra las alucinaciones es una base de conocimiento bien mantenida y actualizada. Importa documentos de preguntas frecuentes, información de productos y guías de procesos. Actualiza semanalmente: los equipos que refrescan su contenido cada semana logran una eficacia un 22% mayor al tercer mes en comparación con los que lo hacen mensualmente.
Paso 3: Prioriza las integraciones de backend. Conecta tu agente de voz a los sistemas necesarios: CRM para datos de clientes, calendarios para reservas, ERP para el estado de pedidos. Famulor ofrece más de 300 integraciones en una plataforma sin código, por lo que conectar con HubSpot, Salesforce, Pipedrive o software específico del sector no requiere recursos de desarrollo.
Paso 4: Diseña la escalación antes del entrenamiento de la IA. Define tu protocolo de escalación antes de entrenar al agente. Para cada tipo de llamada, debe quedar claro: ¿Cuándo transfiere el agente? ¿A quién? ¿Con qué contexto? La plataforma omnicanal de Famulor transmite resúmenes estructurados de la conversación a los agentes humanos, ya sea por teléfono, WhatsApp o chat en vivo, para que el cliente nunca tenga que empezar de cero.
Paso 5: Escala por fases. Empieza con un único tipo de llamada de alto volumen y bien estructurado (estado de pedidos, reservas de citas). Espera un rendimiento inferior en las semanas 1 a 4 y mide los resultados entre los días 30 y 90. Solo cuando un tipo de llamada alcance su tasa objetivo, activa el siguiente.
Errores comunes que arruinan el éxito del escalado
Automatizar todo a la vez. Activar todos los tipos de llamada el primer día produce una tasa global baja y erosiona la confianza de las partes interesadas. Empieza con tipos de llamada que prometan tasas de resolución superiores al 80%.
Ignorar la latencia. Por debajo de los 500 ms de tiempo de respuesta, la conversación parece natural. Por encima de los 800 ms, se vuelve incómoda. Por encima de los 1200 ms, los usuarios cuelgan. Prueba bajo una carga realista, no en un entorno de demo vacío. La infraestructura de Famulor está diseñada para una latencia inferior a 500 ms, incluso con grandes volúmenes de llamadas simultáneas.
No realizar un mantenimiento regular de los prompts. Los modelos de lenguaje se desvían con el tiempo. Después de 2-3 meses, la eficacia disminuye entre un 10 y un 20%; después de 4-6 meses, entre un 15 y un 30%. Utiliza el editor de prompts y las herramientas de evaluación de llamadas de Famulor para detectar desviaciones a tiempo y corregir el rumbo.
No probar la precisión del STT en entornos reales. En una oficina silenciosa, el reconocimiento de voz (STT) alcanza un 95% de precisión. En una calle concurrida, cae al 65-75%; en una obra, al 55-68%. Elige un proveedor de STT probado en condiciones reales e implementa la supresión de ruido.
Observabilidad: por qué la mayoría de los equipos detectan los problemas demasiado tarde
Un cuello de botella que a menudo se pasa por alto es la ausencia de monitorización en tiempo real. Muchos equipos solo notan que su agente de voz no funciona bien cuando las tasas de conversión ya han caído. Sin un panel que muestre la latencia, las tasas de resolución, las tasas de alucinación y los motivos de escalación en tiempo real, los problemas pasan desapercibidos durante semanas.
Una monitorización robusta cubre al menos ocho métricas clave: latencia media (p50 y p95), tasa de resolución por tipo de llamada, tasa de alucinación, tasa de escalación, CSAT por canal, precisión del STT, tiempo medio de gestión y tasa de abandono. Los equipos que revisan manualmente entre el 5 y el 10% de las llamadas diariamente detectan la desviación del modelo dos o tres semanas antes que los equipos que solo observan los agregados.
Famulor integra estas métricas directamente en su panel y ofrece reglas de alerta automática: si la tasa de resolución de cualquier tipo de llamada cae más de 10 puntos porcentuales, o la latencia media supera los 600 ms, recibes una notificación. Esto te permite corregir el rumbo antes de que los clientes noten la degradación.
Seguimiento de instrucciones: el problema oculto de calidad
Investigaciones recientes de Coval y Pipecat revelan un problema sutil: los modelos de lenguaje siguen las instrucciones de forma fiable en los tres primeros turnos de conversación, pero en el turno 20, la precisión del seguimiento de instrucciones cae drásticamente. Esto significa que un agente que funciona perfectamente en una demo corta se sale del guion en una llamada real de 10 minutos.
Las causas son variadas: desviación del prompt en ventanas de contexto largas, conflictos entre el contenido de la base de conocimiento y las reglas del prompt del sistema, y falta de mecanismos de refuerzo para las directrices básicas de conversación. La solución reside en una jerarquía clara: el prompt del sistema define el comportamiento, la base de conocimiento proporciona los hechos y las reglas de respaldo explícitas capturan situaciones desconocidas.
El editor de prompts de Famulor con evaluación de llamadas integrada hace visible este problema: puedes buscar en las transcripciones los momentos en que el agente se desvió de sus instrucciones y ajustar el prompt del sistema en consecuencia. La combinación de análisis semanal de transcripciones e iteración de prompts es la forma más eficaz de mantener la calidad a lo largo de los meses.
El papel de la omnicanalidad: por qué centrarse solo en el teléfono es insuficiente
Una tendencia de 2026 merece especial atención: los despliegues de IA de voz más exitosos no operan de forma aislada en el canal telefónico, sino que integran capacidades omnicanal. Cuando un usuario tiene una pregunta compleja que se responde mejor por escrito (una lista de precios, instrucciones o un documento), el agente de voz puede cambiar sin problemas a WhatsApp o chat en vivo y enviar la información por ahí.
Esta capacidad de cambio de canal eleva las tasas de resolución efectiva entre 10 y 15 puntos porcentuales, porque las llamadas que de otro modo contarían como "no resueltas" (el cliente necesita confirmación por escrito) se completan a través del canal secundario. La comunicación saliente proactiva, como las confirmaciones de citas por WhatsApp tras una reserva telefónica, reduce el volumen de llamadas entrantes entre un 15 y un 25% adicional.
Ejemplos del sector: escalado en la práctica
Clínica dental Dr. Meier, Düsseldorf (3 salas de tratamiento, 8 empleados). Fase 1: Automatización de reservas de citas y recordatorios: tasa de resolución del 72% tras 6 semanas. Fase 2: Se añadieron consultas de recetas y enrutamiento de emergencias: tasa global del 68%. Tiempo ahorrado: 14 horas por semana en recepción.
Proveedor de servicios públicos municipal, Schwäbisch Hall (120 000 clientes). Desafío: picos masivos de llamadas durante los ciclos de facturación y reportes de averías. Fase 1: Automatización de lecturas de contadores y consultas de saldo (82% de resolución). Fase 2: Reportes de averías con integración CRM (58%). Resultado: 40% menos de tiempo de espera para los clientes transferidos a agentes humanos.
Empresa de comercio electrónico BikeParts24 (45 empleados, 8000 pedidos/mes). Consultas sobre el estado de pedidos automatizadas mediante Famulor AI outbound e inbound. Tasa de resolución: 78% para estado de pedidos, 65% para inicio de devoluciones. Coste por llamada resuelta reducido de 4,80 € a 1,20 €.
La economía: qué aporta el escalado
Los puntos de referencia muestran cifras claras de ROI para los despliegues de IA de voz a escala:
| Métrica | Valor medio |
|---|---|
| Reducción del tiempo de gestión | 35–55% |
| Puntuación CSAT | 82–88 / 100 |
| Coste por resolución | 2,50 $–8,00 $ |
| Plazo de despliegue | 6–16 semanas |
Para una empresa con 5000 llamadas entrantes al mes y un coste medio de 8 $ por llamada, escalar del 45% al 75% de automatización significa 1500 llamadas automatizadas adicionalmente × (8 $ − 1,80 $ de coste de automatización) = 9300 $ de ahorro mensual, o aproximadamente 112 000 $ al año.
Con la transparente tarificación por minuto de Famulor a partir de 0,05 $ por minuto, puedes calcular esto con precisión para tu propio volumen de llamadas:
Calcula tu ROI automatizando llamadas
Descubre cuánto podrías ahorrar al usar voice agents con IA.
Resultado ROI
ROI 0%
Sin tarjeta de crédito
Conclusión: el escalado es un problema operativo, no técnico
La tecnología para alcanzar el 80% de automatización ya existe. Lo que falta es el enfoque sistemático: medir las líneas base, priorizar los tipos de llamada, mantener la base de conocimiento, integrar backends, diseñar la escalación y escalar por fases. Famulor proporciona la plataforma todo en uno con las herramientas exactas que hacen posible este proceso: paneles de KPI integrados, integraciones sin código, escalación estructurada en todos los canales y un editor de prompts con evaluación de llamadas integrada.
Tu próximo paso: reserva una demo en vivo y comprueba cómo Famulor configura tu tipo de llamada específico como piloto en 30 minutos, incluyendo la importación de la base de conocimiento y la integración del calendario.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.
Agente IA de demo
Representante de Famulor
Preguntas frecuentes
¿Por qué mi piloto de IA de voz se estanca en el 40-50% de automatización?
Las causas más comunes son la falta de una base de conocimiento (tasa de alucinación del 15-30% sin ella), la ausencia de integración con el backend para el acceso a datos en tiempo real y escalaciones no estructuradas sin transferencia de contexto.
¿Con qué tipos de llamada es mejor empezar?
Los restablecimientos de contraseña (tasa de resolución del 80-95%), las consultas de saldo de cuenta (75-90%) y las consultas de estado de pedidos (70-85%) son puntos de partida ideales porque son de gran volumen y están bien estructurados.
¿Cuánto tiempo se tarda en escalar del 50% al 80% de automatización?
Con un enfoque por fases y un mantenimiento estructurado de la base de conocimiento, es realista lograrlo en 60-90 días. Mide el rendimiento entre los días 30 y 90, no en las primeras cuatro semanas.
¿Cuánto cuesta un asistente telefónico con IA en comparación con un agente humano?
El coste por llamada resuelta es de 2,50 $ a 8,00 $ para la IA de voz frente a los 12 $ a 25 $ de los agentes humanos. Famulor cobra desde 0,05 $ por minuto con una tarificación transparente.
¿Cómo evito que mi agente de voz alucine?
Una base de conocimiento estructurada reduce la tasa de alucinación del 15-30% a menos del 5%. Añade límites explícitos de "no lo sé" para temas no cubiertos en la base de conocimiento.
¿Qué latencia es aceptable para conversaciones naturales?
Por debajo de 500 ms parece natural. Por encima de 800 ms, la tasa de abandono aumenta un 2,5% por cada 100 ms adicionales. Prueba siempre bajo carga de producción realista, no en un entorno de demo.
¿Funciona la IA de voz en entornos ruidosos?
La precisión del STT cae del 95% (silencio) al 65-75% (calle) o 55-68% (obra). La supresión de ruido y un proveedor de STT robusto son críticos para el despliegue en el mundo real.
¿Cómo mido el ROI de mi proyecto de IA de voz?
Captura métricas previas al lanzamiento: coste por llamada, tiempo medio de gestión y CSAT. Compara después de 90 días. La reducción típica del tiempo de gestión es del 35-55%, con un coste por resolución que cae a 2,50 $-8,00 $.
¿Qué ocurre cuando el agente de IA no puede resolver una llamada?
Un agente bien configurado transfiere la llamada con un resumen estructurado de la conversación a un agente humano. La plataforma omnicanal de Famulor admite esta transferencia por teléfono, WhatsApp y chat en vivo.
¿Vale la pena la IA de voz para pequeñas empresas con pocas llamadas?
Sí, el ROI se vuelve positivo alrededor de las 200 llamadas al mes cuando se automatiza el tipo de llamada adecuado. Famulor ofrece una tarificación flexible por minuto sin compromiso mínimo.
Autor en Famulor