Inhoud samenvatten met:



PII-redactie voor AI-voice-agents: AVG-veilige transcripten, opnames en logs
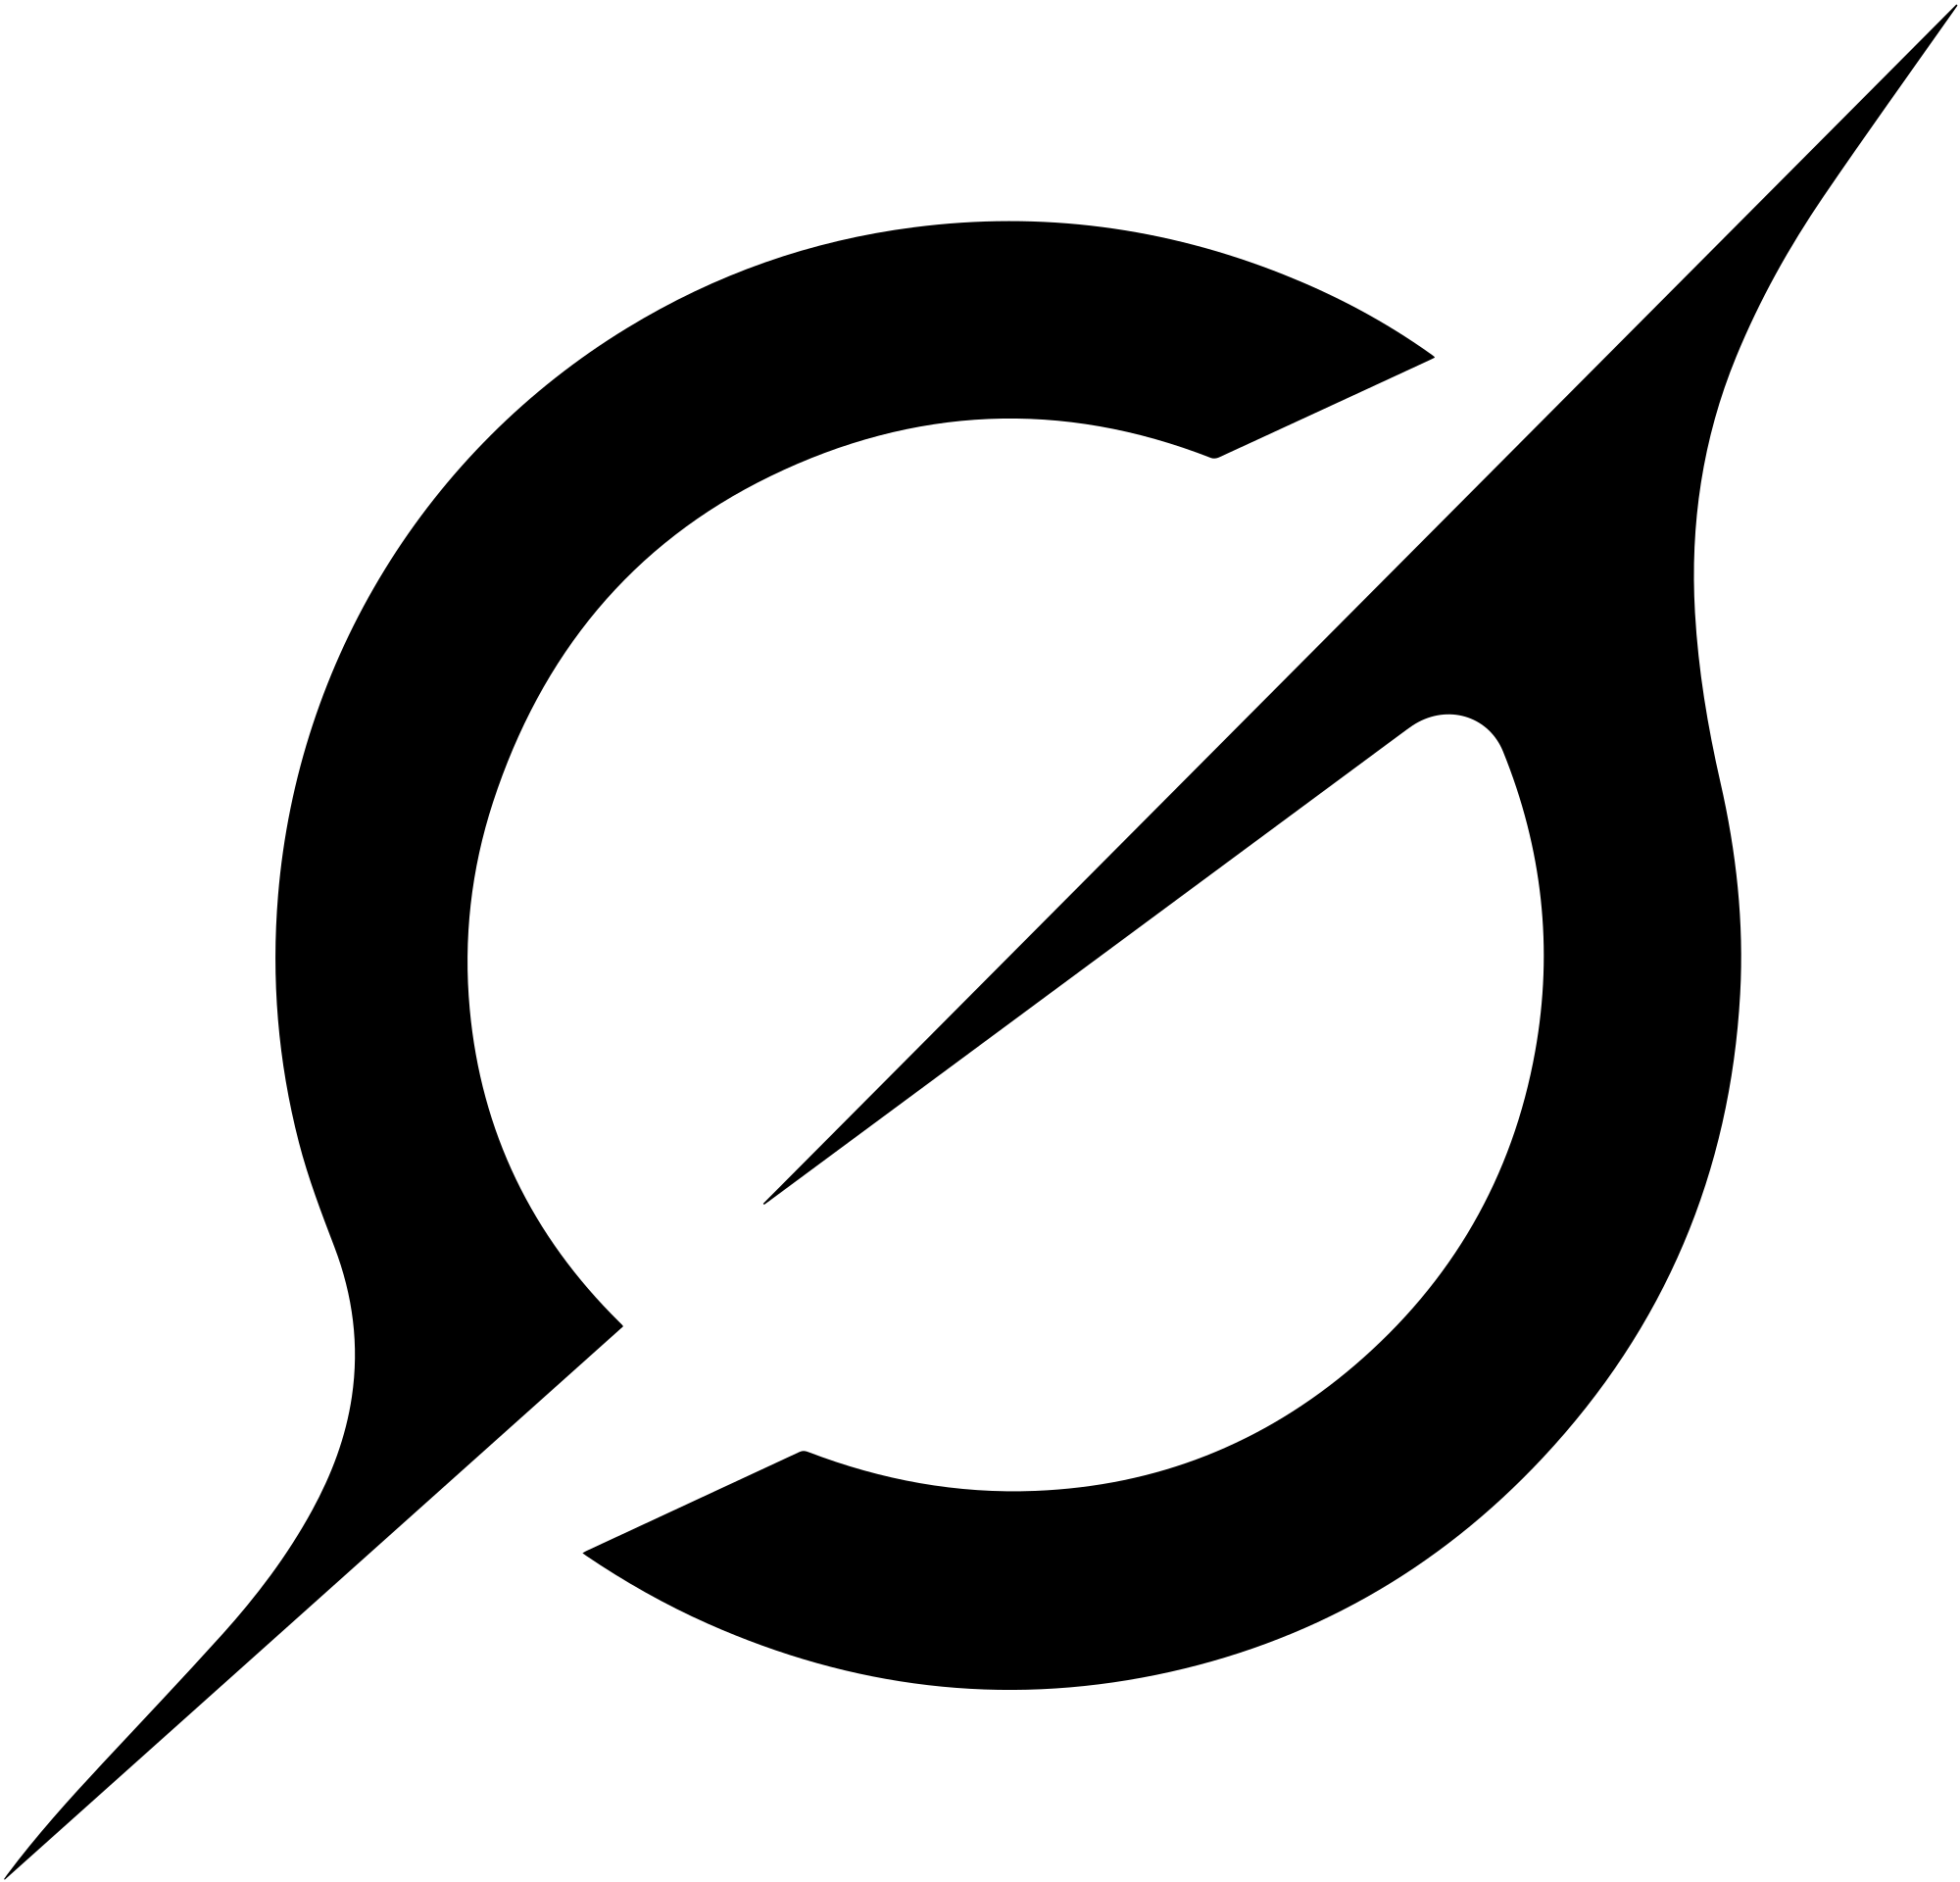
Het korte antwoord eerst: je hoeft niet te kiezen tussen inzichtelijkheid en gegevensbescherming. Persoonsgegevens kunnen automatisch uit transcripten, audio-opnames, traces en logs worden verwijderd voordat er ook maar iets permanent wordt opgeslagen. De analytische laag blijft behouden, de ruwe waarden niet.
Dit bereik je via drie hefbomen: een redactiefase tijdens de gegevensinvoer, een korte en gedocumenteerde bewaartermijn, en een solide juridische basis inclusief een melding aan het begin van het gesprek. Met Famulor configureer je bewaartermijnen, toestemmingsmodi en geheugengedrag per account — zonder dat je het vermogen verliest om je gesprekken te analyseren.
De aanleiding voor dit artikel: op 20 augustus 2026 lanceerde LiveKit PII-redactie voor zijn Agent Observability-product en legde in detail uit waarom gesproken gesprekken anders moeten worden behandeld dan formuliergegevens. De mechanismen die zij beschrijven vormen een nuttig referentiemodel, ongeacht welk platform jouw telefoon-agents aanstuurt.
Waarom gesproken gesprekken het lastigste PII-probleem zijn
In een webformulier staat het telefoonnummer in een veld genaamd phone. In een gesprek staat het nergens. Het komt naar voren over meerdere beurten, met correcties, gespelde letters en verduidelijkende vragen. Dat is precies waar klassieke benaderingen falen.
LiveKit noemt drie patronen die constant opduiken in telefoongesprekken en die patroonherkenning omzeilen: mensen spellen dingen hardop uit, ze splitsen een enkele waarde over meerdere beurten, en ze corrigeren zichzelf midden in een zin. Een reguliere expressie voor een kaartnummer werkt niet als de cijfers verspreid zijn over vier uitingen en een ervan wordt ingetrokken.
Een tweede praktisch voorbeeld: de beller zegt "Smith — nee, met een Y, dus S van Sierra, M, Y, T, H". Een woordenboekzoekopdracht op achternamen vindt op zijn best het eerste token. De uitgespelde rest blijft in platte tekst staan, en dus in je opslag.
Ten derde: automatische spraakherkenning produceert geen perfect betrouwbare tijdstempels op woordniveau. Iedereen die denkt dat hij individuele woorden chirurgisch uit een audiobestand kan knippen, overschat de precisie van huidige STT-modellen. LiveKit trekt de conservatieve conclusie en verwijdert de gehele gespreksbeurt uit de opname in plaats van woordvensters bij te snijden. In plaats van de oorspronkelijke spraak wordt een zachte toon afgespeeld.
De vier lagen waar persoonsgegevens zich ophopen
Een veelgemaakte fout bij privacyontwerpen voor AI-telefonie: alleen het transcript krijgt aandacht. In werkelijkheid worden persoonsgegevens op minstens vier plekken gecreëerd, en voor elk daarvan is een besluit nodig.
| Laag | Typische inhoud | Aanbevolen maatregel | Risico bij negeren |
|---|---|---|---|
| Transcript | Naam, adres, geboortedatum, rekeningnummer | Vervangen door getypeerde markers, omliggende context leesbaar houden | Full-text doorzoekbare ruwe data voor maandenlang |
| Audio-opname | Stem plus elk gesproken detail | Betreffende beurten volledig verwijderen, of helemaal niet opnemen | Biometrische identificator en inhoud in één bestand |
| Traces en logs | Toolparameters, payloads, debugvelden | Gevoelige velden verwijderen in plaats van maskeren | PII lekt stilletjes naar monitoringsystemen |
| Downstream-systemen | CRM-records, webhook-bodies, automatiseringsruns | Veldmapping definiëren, alleen doorgeven wat nodig is | Openbaarmaking aan derden zonder juridische basis |
De derde rij is wat teams onderschatten. Wanneer je agent midden in een gesprek een functie aanroept — een voorraadcheck, een afspraak boeken — komen de parameters die hij doorgeeft meestal ongefilterd in de log terecht. Hoe je die parameters definieert en beperkt, wordt behandeld in de documentatie over tools en functies.
Redactiebenaderingen vergeleken
Er zijn drie gangbare manieren om persoonsgegevens uit gespreksverslagen te strippen. Ze verschillen sterk in recall, inspanning en controleerbaarheid.
| Criterium | Reguliere expressies | NER-model | LLM in gesprekscontext |
|---|---|---|---|
| Detecteert gestructureerde patronen | Goed | Goed | Goed |
| Detecteert uitgespelde waarden | Nee | Zelden | Ja |
| Detecteert waarden gesplitst over beurten | Nee | Beperkt | Ja |
| Verwerkt zelfcorrecties | Nee | Nee | Ja |
| Latentie en kosten | Zeer laag | Laag | Hoger, maar kan asynchroon draaien |
| Onderhoudsinspanning | Hoog, regels verouderen | Gemiddeld, vereist hertraining | Laag |
| Foutmodus | Mist varianten | Mist context | Kan over-redacteren |
De eerlijke beoordeling: op LLM gebaseerde redactie is niet foutloos, en het neigt eerder naar over-redactie dan naar onder-redactie. Voor een compliance-controle is dat de juiste richting om in te falen. Het pragmatische compromis waar de meeste teams op uitkomen, is om gestructureerde formaten te blijven vangen met regels en een modelgebaseerde pass over de gesprekscontext toe te voegen.
De implementatie van LiveKit dekt 41 PII-typen verdeeld over tien groepen: namen, contactgegevens, demografische gegevens, inloggegevens, netwerk-id's, organisaties, financiële gegevens, locaties, kalenderdata en overheids-id's. Die groepering dient tevens als een werkbare checklist voor je eigen ontwerp, ongeacht welke leverancier je gebruikt.
Wat het juridisch kader daadwerkelijk vereist
Voor AI-telefonie is gegevensbescherming geen bijzaak — het bepaalt de architectuur. Vier vereisten sturen het ontwerp.
Dataminimalisatie. Artikel 5 van de AVG vereist dat je alleen verwerkt wat het doel vereist. Als je gesprekken analyseert om je agent te verbeteren, heb je de gespreksstroom nodig — niet de bankgegevens van de beller. Dat is precies wat redactie oplevert: het scheidt het analytisch waardevolle deel van het juridisch risicovolle deel.
Opslagbeperking. Een bewaartermijn moet worden gedefinieerd, gerechtvaardigd en technisch worden afgedwongen. LiveKit verwijdert observability-data automatisch na 30 dagen. Of 30, 60 of 90 dagen bij jouw situatie past, hangt af van je doel — wat telt is dat de termijn in je verwerkingsregister staat en dat het systeem deze daadwerkelijk toepast.
Transparantie aan het begin van het gesprek. De beller moet weten dat hij met een AI-systeem spreekt en of het gesprek wordt opgenomen. Dat hoort in de begroeting thuis, niet in de kleine lettertjes. Hoe je die bewoordingen goed verankert, wordt beschreven in de documentatie over de systeemprompt.
Verwerkersovereenkomsten en verwerkingslocatie. Elke dienst in je keten — telefonie, spraakherkenning, taalmodel, spraaksynthese, opslag — verwerkt potentieel persoonsgegevens. Je hebt met elk daarvan een verwerkersovereenkomst nodig en duidelijkheid over waar de verwerking plaatsvindt. Die keten is de echte reden waarom Europese operators aandringen op EU-hosting.
Een veelvoorkomend misverstand: dat nul-dataretentie bij de modelprovider redactie vervangt. Dat is niet zo. Nul-dataretentie betekent dat de modelprovider jouw inhoud niet bewaart. Het zegt niets over wat er in jouw observability-store, jouw CRM en jouw logs terechtkomt. De twee maatregelen vullen elkaar aan; de een vervangt de ander niet.
Wat observability kost — en wat het oplevert
De economische kant wordt zelden goed doorgerekend. Observability zonder privacyontwerp is geen besparing, het is een uitgestelde factuur. Drie kostenposten staan tegenover elkaar.
Ten eerste: operaties. Opslag voor transcripten en opnames is goedkoop; redactie zelf kost rekenkracht. Beide vallen in de categorie van fracties van een cent per gespreksminuut en zijn verwaarloosbaar naast telefonie- en modelkosten. Een overzicht van de kosten per minuut staat op de prijspagina.
Ten tweede: de winst. Teams die gesprekken kunnen analyseren, vinden de punten waar bellers afhaken, waar de agent onjuist doorverbindt, of waar een tool-aanroep faalt. In de praktijk zijn dat de procentpunten van het voltooiingspercentage die bepalen of een project zichzelf terugbetaalt. Zonder observability optimaliseer je blind.
Ten derde: het risico. Een opslag vol ongeredacteerde gespreksdata is een probleem bij inzage- en verwijderverzoeken, een meldingsprobleem na een incident, en in het ergste geval een boete. De kosten zijn zeldzaam maar onbegrensd — precies het profiel waartegen je je verzekert.
Weeg beide kanten tegen elkaar af voordat je besluit of je opname en analyse überhaupt inschakelt:
Bereken je ROI met geautomatiseerde gesprekken
Ontdek hoeveel je per maand bespaart via AI voice agents.
ROI Resultaat
ROI 0%
Geen creditcard nodig
Dit implementeren op Famulor: stap voor stap
De volgende volgorde heeft zich bewezen in uitrolprojecten. Niets hiervan vereist engineering-resources.
- Definieer het doel. Schrijf in één zin op waarom je transcripten analyseert — kwaliteitsborging, prompt-optimalisatie, bewijsverplichtingen. Geen doel betekent geen juridische basis en geen zinnige bewaartermijn.
- Configureer retentie. Stel de bewaartermijn voor opnames en transcripten in op de kortste waarde die nog steeds je doel dient. Automatische verwijdering is veel betrouwbaarder dan elk proces dat afhangt van het geheugen van een persoon.
- Kies de toestemmingsmodus. Bepaal of en hoe toestemming voor opname wordt vastgelegd, en veranker de melding in het openingsbericht van de assistent.
- Beperk de datavelden. Controleer elke functie die je agent midden in een gesprek aanroept op zijn parameters. Geef waar mogelijk een zaakreferentie door in plaats van een volledig klantrecord.
- Beheer het gespreksgeheugen. Als je agent terugkerende bellers moet herkennen, beslis dan bewust welke kenmerken worden opgeslagen — en zorg ervoor dat een verwijderverzoek het item ook echt verwijdert.
- Bepaal wat het platform verlaat. Data verlaat het platform via integraties en webhooks. Definieer per bestemming welke velden worden doorgegeven in plaats van het volledige gespreksverslag door te sturen.
- Testen in plaats van hopen. Voer testgesprekken waarin je bewust een naam, adres, geboortedatum en betalingsgegeven noemt — één keer in één keer, één keer uitgespeld, één keer met een correctie. Inspecteer daarna transcript, opname en log. Hoe je dit systematisch opzet, wordt behandeld onder testen.
- Documenteer het. Leg doel, retentie, de betrokken diensten en de toegepaste controles vast in je verwerkingsregister. De inspanning is eenmalig; het voordeel blijkt bij de eerste audit.
Best practices en veelgemaakte fouten
Redigeer voor opslag, niet erna. Als ruwe waarden eerst de opslag bereiken en later worden overschreven, hebben ze in de tussentijd bestaan — in back-ups, in replica's, in zoekindexen. LiveKit lost dit op met een upstream-invoer-service die redactie uitvoert voordat artefacten de eigenlijke opslag bereiken. Pas hetzelfde principe toe op je eigen keten.
Behoud de context, verwijder de waarde. Een transcript waar elke tweede regel ontbreekt, is nutteloos voor optimalisatie. Een transcript met markers zoals [phone_number] of [address] blijft leesbaar en laat tegelijkertijd zien wat er is verwijderd. Getypeerde markers laten je zelfs analyseren op welke punten in een gesprek gevoelige gegevens doorgaans verschijnen.
Beslis apart over opname en transcript. Voor veel use-cases is het geredigeerde transcript volledig voldoende. Het audiobestand bevat daarnaast de stem als biometrische identificator en is daarom het veel gevoeligere bezit. Vraag per use-case of je de opname echt nodig hebt.
Vergeet de andere kanalen niet. Als je telefoon-agent onderdeel is van een omnichannel-opstelling, verschijnen dezelfde gegevens in chat, in de webwidget en in messenger-threads. Een ontwerp dat alleen telefonie dekt, is onvolledig. Dit is vooral belangrijk voor opstellingen rondom een AI-callcenter dat meerdere kanalen beslaat.
Controleer je eigen analyseroutines. Het voeden van geredigeerde transcripten in een volgend model voor samenvattingen creëert een nieuwe verwerkingsactiviteit. Deze moet net als elke andere worden gedocumenteerd.
De meest gemaakte fout in de praktijk is echter niet technisch. Teams schakelen opname uit onzekerheid volledig uit, verliezen elke weg naar verbetering, en vragen zich zes maanden later af waarom het afhaakpercentage niet is veranderd. De keuze is niet "alles opslaan" versus "niets opslaan" — het is "het juiste opslaan".
Drie voorbeelden uit de industrie
Een tandartspraktijk die 80 patiëntcontacten per dag afhandelt. Gesprekken bevatten namen, geboortedata, verzekeringsnummers en vaak symptomen — gezondheidsgegevens onder Artikel 9 AVG. De juiste configuratie hier is meestal: geen audio-opname, geredigeerd transcript met een korte bewaartermijn, afspraak boeken via een functie die alleen een zaakreferentie en een tijdslot doorgeeft. De praktijk behoudt het vermogen om te verifiëren of de agent planningsverzoeken correct begrijpt.
Een makelaarskantoor met 30 actieve listings en 15 eerste aanvragen per dag. De motivatie verschilt: de agent kwalificeert prospects voor. Namen, budgetcijfers en financieringsstatus zijn zeer gevoelig, maar het gesprekspatroon is het eigenlijke object van optimalisatie. Geredigeerde transcripten zijn volledig voldoende om te zien bij welke vraag prospects afhaken.
Een belastingkantoor tijdens het aangifteseizoen. Een AI-agent neemt terugbelverzoeken en documentvragen aan. Klantgegevens en belastingnummers moeten zonder uitzondering worden geredigeerd, en beroepsgeheim scherpt de eisen verder aan. Tegelijkertijd is weten welke vragen terugkeren echt geld waard — het laat zien wat er in het volgende klantbulletin moet staan.
In alle drie de gevallen is de beslissing dezelfde: niet of je analyseert, maar waarvandaan je analyseert. Als je industrietoepassingen wilt vergelijken, zijn voorbeelden verzameld onder industrieën.
Conclusie
Gegevensbescherming en observability zijn niet in strijd bij AI-telefonie — ze hebben simpelweg de juiste volgorde van operaties nodig. Redigeer persoonsgegevens voordat ze worden opgeslagen. Stel een korte, technisch afgedwongen bewaartermijn in. Beperk wat je functies en webhooks naar buiten sturen. En test het resultaat met gesprekken die bewust dingen uitspellen en zichzelf corrigeren.
De industrie beweegt duidelijk deze kant op: leveranciers leveren redactie nu als standaardmogelijkheid in plaats van als add-on. Voor Europese operators voegt de verwerkingslocatie een tweede dimensie toe — daarom is EU-hosting op Famulor de standaardinstelling in plaats van een betaalde extra.
Concrete volgende stap: maak een testassistent, voer vijf gesprekken met bewust verspreide persoonsgegevens, en inspecteer daarna transcript, opname en log. Een half uur vertelt je waar je keten lekt. Je kunt direct beginnen met de no-code voice agent.
Probeer onze AI-assistent
Ervaar hoe natuurlijk onze AI-telefoonassistent klinkt.
Vul je gegevens in en ontvang binnen enkele seconden een oproep van onze AI-agent.
De agent is getraind om over Famulor-diensten te praten en afspraken te maken.
Demo AI-agent
Famulor medewerker
FAQ
Wat is PII-redactie voor AI-voice-agents?
PII-redactie is het automatisch verwijderen van persoonsgegevens uit transcripten, audio-opnames en logs van een telefoon-agent. Gedetecteerde waarden worden vervangen door getypeerde markers voordat de gegevens permanent worden opgeslagen.
Is een reguliere expressie genoeg om transcripten te redigeren?
Nee. In een gesprek worden waarden uitgespeld, gesplitst over beurten en midden in de zin gecorrigeerd. Patroongebaseerde methoden missen precies die gevallen en zouden contextbewuste detectie alleen moeten aanvullen, nooit vervangen.
Waarom wordt de hele beurt uit een audio-opname verwijderd?
Omdat spraakherkenningsmodellen geen perfect betrouwbare tijdstempels op woordniveau produceren. Een precieze snede zou fragmenten van de gevoelige waarde kunnen achterlaten. De hele beurt verwijderen is de veilige optie.
Hoe lang mag ik gespreksopnames bewaren?
Zo lang als je gedocumenteerde doel vereist. In de praktijk loopt de retentie voor kwaliteitsborging doorgaans tussen de 30 en 90 dagen. Wat telt is dat de termijn gerechtvaardigd, gedocumenteerd en automatisch door het systeem wordt afgedwongen.
Vervangt nul-dataretentie redactie?
Nee. Nul-dataretentie bepaalt alleen of de modelprovider jouw inhoud bewaart. Je eigen transcripten, logs en CRM-records blijven onaangetast. De twee controles vullen elkaar aan.
Moet ik bellers vertellen dat ze met een AI spreken?
Ja. De melding over het AI-systeem, en over opname waar van toepassing, hoort aan het begin van het gesprek. Veranker dit in het openingsbericht van de assistent in plaats van in documenten achteraf.
Kan ik gesprekken nog steeds analyseren als alles is geredigeerd?
Ja. Alleen de persoonlijke waarden worden verwijderd, niet de gespreksstructuur. Afhaakpunten, onjuiste doorverbindingen en mislukte tool-aanroepen blijven volledig zichtbaar en meetbaar.
Wat gebeurt er als een beller om verwijdering verzoekt?
Je moet elke kopie verwijderen — transcript, opname, gespreksgeheugen en records in downstream-systemen. Dat is precies waarom het beperken van wat je doorstuurt naar systemen van derden vanaf dag één loont.
Geldt dit ook voor chat en WhatsApp?
Ja. Dezelfde vereisten gelden voor elk kanaal waarop je agent met klanten praat. Een privacyontwerp dat alleen telefonie dekt, laat in een omnichannel-opstelling de helft van de data onbeheerd achter.
Auteur bij Famulor