Résumer le contenu avec:



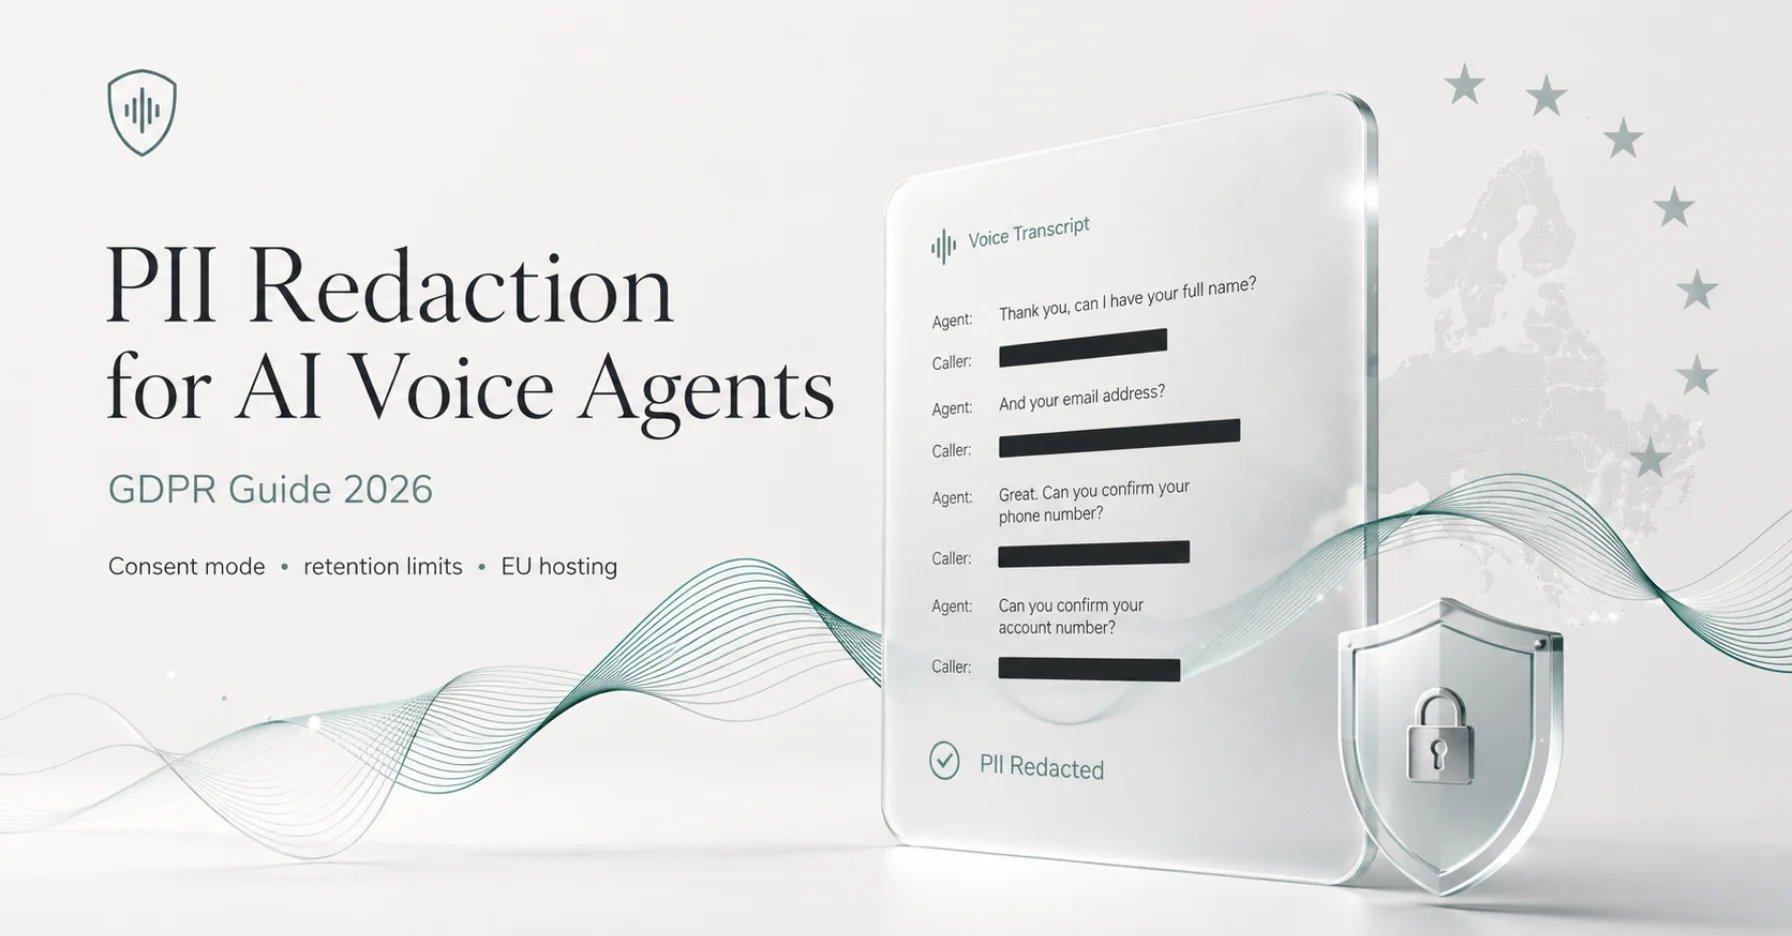
Masquage des données personnelles pour les agents vocaux IA : transcriptions, enregistrements et logs conformes au RGPD
Réponse courte : vous n'avez pas à choisir entre observabilité et protection des données. Les données personnelles peuvent être masquées automatiquement dans les transcriptions, les enregistrements audio, les traces et les logs avant que quoi que ce soit ne soit stocké de manière permanente. La couche analytique est préservée, les valeurs brutes ne le sont pas.
Pour y parvenir, trois leviers sont nécessaires : une étape de masquage lors de l'ingestion, une période de rétention courte et documentée, et une base légale claire incluant une information dès le début de l'appel. Avec Famulor, vous configurez la rétention, le mode de consentement et le comportement de la mémoire par compte, sans renoncer à la capacité d'analyser vos appels.
Le déclencheur de cet article : le 20 août 2026, LiveKit a lancé le masquage des données personnelles (PII Redaction) pour son produit d'observabilité des agents et a expliqué en détail pourquoi les conversations orales doivent être traitées différemment des données de formulaires. Les mécanismes qu'ils décrivent constituent un modèle de référence utile, quelle que soit la plateforme qui exécute vos agents téléphoniques.
Pourquoi les conversations orales sont le problème de données personnelles le plus complexe
Dans un formulaire web, le numéro de téléphone se trouve dans un champ nommé phone. Lors d'un appel, il n'est nulle part. Il émerge au fil de plusieurs échanges, avec des corrections, des lettres épelées et des questions de clarification. C'est précisément là que les approches classiques échouent.
LiveKit identifie trois modèles qui apparaissent constamment dans les conversations téléphoniques et qui mettent en échec la reconnaissance de formes : les gens épellent les choses à voix haute, ils divisent une seule valeur sur plusieurs tours de parole, et ils se corrigent en cours de phrase. Une expression régulière pour un numéro de carte bancaire ne se déclenchera pas si les chiffres sont répartis sur quatre énoncés et que l'un d'eux est rétracté.
Second exemple pratique : l'appelant dit "Smith — non, avec un Y, donc S comme Sierra, M, Y, T, H". Une recherche par dictionnaire sur les noms de famille ne trouve au mieux que le premier jeton. Le reste épelé demeure en texte clair, et donc dans votre stockage.
Troisième point : la reconnaissance automatique de la parole ne produit pas d'horodatages au niveau du mot parfaitement fiables. Quiconque pense pouvoir découper chirurgicalement des mots individuels dans un fichier audio surestime la précision des modèles STT actuels. LiveKit tire la conclusion conservatrice et supprime l'intégralité du tour de parole de l'enregistrement au lieu de rogner des fenêtres de mots. Une tonalité douce est jouée à la place de la parole originale.
Les quatre couches où s'accumulent les données personnelles
Une erreur courante dans la conception de la confidentialité pour la téléphonie IA : seule la transcription reçoit de l'attention. En réalité, les données personnelles sont créées à au moins quatre endroits, et chacun nécessite sa propre décision.
| Couche | Contenu typique | Mesure recommandée | Risque si ignoré |
|---|---|---|---|
| Transcription | Nom, adresse, date de naissance, numéro de compte | Remplacer par des marqueurs typés, garder le contexte lisible | Données brutes consultables en texte intégral pendant des mois |
| Enregistrement audio | Voix plus chaque détail énoncé | Supprimer entièrement les tours de parole concernés, ou ne pas enregistrer du tout | Identifiant biométrique et contenu dans un seul fichier |
| Traces et logs | Paramètres d'outils, charges utiles, champs de débogage | Supprimer les champs sensibles plutôt que de les masquer | Données personnelles se propageant silencieusement dans les systèmes de surveillance |
| Systèmes en aval | Enregistrements CRM, corps de webhooks, exécutions d'automatisation | Définir le mappage des champs, ne transmettre que ce qui est nécessaire | Divulgation à des tiers sans base légale |
La troisième ligne est celle que les équipes sous-estiment. Lorsque votre agent appelle une fonction en pleine conversation — une vérification de stock, une prise de rendez-vous — les paramètres qu'il transmet atterrissent généralement sans filtrage dans le log. La manière de définir et de contraindre ces paramètres est couverte dans la documentation sur les outils et fonctions.
Comparaison des approches de masquage
Il existe trois méthodes courantes pour extraire les données personnelles des enregistrements de conversation. Elles diffèrent nettement en termes de rappel, d'effort et d'auditabilité.
| Critère | Expressions régulières | Modèle NER | LLM dans le contexte de la conversation |
|---|---|---|---|
| Détecte les modèles structurés | Bon | Bon | Bon |
| Détecte les valeurs épelées | Non | Rarement | Oui |
| Détecte les valeurs divisées sur plusieurs tours | Non | Limité | Oui |
| Gère les auto-corrections | Non | Non | Oui |
| Latence et coût | Très faible | Faible | Plus élevé, mais peut s'exécuter de manière asynchrone |
| Effort de maintenance | Élevé, les règles deviennent obsolètes | Moyen, nécessite un réentraînement | Faible |
| Mode de défaillance | Manque des variantes | Manque de contexte | Peut masquer excessivement |
L'évaluation honnête : le masquage basé sur LLM n'est pas sans erreur, et il a tendance à masquer excessivement plutôt qu'insuffisamment. Pour un contrôle de conformité, c'est la bonne direction pour échouer. Le compromis pragmatique sur lequel la plupart des équipes tombent est de continuer à capturer les formats structurés avec des règles et d'ajouter une passe basée sur un modèle sur le contexte conversationnel.
L'implémentation de LiveKit couvre 41 types de données personnelles répartis en dix groupes : noms, coordonnées, données démographiques, identifiants, identifiants réseau, organisations, données financières, lieux, dates de calendrier et identifiants gouvernementaux. Ce regroupement sert également de liste de contrôle exploitable pour votre propre conception, quel que soit le fournisseur que vous utilisez.
Ce que le cadre juridique exige réellement
Pour la téléphonie IA, la protection des données n'est pas une réflexion après coup, elle détermine l'architecture. Quatre exigences guident la conception.
Minimisation des données. L'article 5 du RGPD exige que vous ne traitiez que ce que la finalité exige. Si vous analysez les appels pour améliorer votre agent, vous avez besoin du flux conversationnel, pas des coordonnées bancaires de l'appelant. C'est précisément ce que le masquage permet : il sépare la partie analytiquement précieuse de la partie juridiquement risquée.
Limitation de la conservation. Une période de rétention doit être définie, justifiée et techniquement appliquée. LiveKit supprime automatiquement les données d'observabilité après 30 jours. Que 30, 60 ou 90 jours conviennent à votre cas dépend de votre objectif — ce qui compte, c'est que la période apparaisse dans votre registre des activités de traitement et que le système l'applique réellement.
Transparence au début de l'appel. L'appelant doit apprendre qu'il parle à un système d'IA et si l'appel est enregistré. Cela doit figurer dans le message d'accueil, pas dans les petits caractères. La manière d'ancrer correctement cette formulation est décrite dans la documentation sur le system prompt.
Accords de traitement et lieu de traitement. Chaque service de votre chaîne — téléphonie, reconnaissance vocale, modèle linguistique, synthèse vocale, stockage — traite potentiellement des données personnelles. Vous avez besoin d'un accord de traitement des données avec chacun d'eux et d'une clarté sur l'endroit où le traitement a lieu. Cette chaîne est la vraie raison pour laquelle les opérateurs européens insistent sur l'hébergement dans l'UE.
Une idée fausse fréquente : que l'absence de rétention des données chez le fournisseur de modèle remplace le masquage. Ce n'est pas le cas. L'absence de rétention signifie que le fournisseur de modèle ne conserve pas votre contenu. Cela ne dit rien sur ce qui finit dans votre magasin d'observabilité, votre CRM et vos logs. Les deux mesures se complètent ; aucune ne remplace l'autre.
Ce que coûte l'observabilité — et ce qu'elle permet d'économiser
L'économie est rarement analysée correctement. L'observabilité sans conception de confidentialité n'est pas une économie, c'est une facture différée. Trois blocs de coûts s'opposent.
Premièrement, les opérations. Le stockage des transcriptions et des enregistrements est bon marché ; le masquage lui-même coûte en puissance de calcul. Les deux se situent dans la fourchette de fractions de centime par minute de conversation et sont négligeables par rapport aux coûts de téléphonie et de modèle. Une ventilation des coûts par minute se trouve sur la page de tarification.
Deuxièmement, le bénéfice. Les équipes qui peuvent analyser les appels trouvent les points où les appelants abandonnent, où l'agent transfère incorrectement, ou où un appel d'outil échoue. En pratique, ce sont les points de pourcentage du taux de complétion qui décident si un projet est rentable. Sans observabilité, vous optimisez à l'aveugle.
Troisièmement, le risque. Un magasin rempli de données de conversation non masquées est un problème de demande d'accès et d'effacement, un problème de notification après un incident, et dans le pire des cas, une amende. Le coût est rare mais illimité — exactement le profil contre lequel vous vous assurez.
Pesez les deux côtés avant de décider si vous devez activer l'enregistrement et l'analyse :
Estimez votre ROI en automatisant vos appels
Voyez combien vous pourriez économiser chaque mois grâce aux voice agents IA.
Résultat ROI
ROI 0%
Sans carte bancaire
Mise en œuvre sur Famulor : étape par étape
La séquence suivante a fait ses preuves dans les projets de déploiement. Rien de tout cela ne nécessite de ressources d'ingénierie.
- Définir l'objectif. Écrivez en une phrase pourquoi vous analysez les transcriptions — assurance qualité, optimisation des prompts, obligations probatoires. Pas d'objectif signifie pas de base légale et pas de période de rétention sensée.
- Configurer la rétention. Définissez la période de rétention des enregistrements et des transcriptions à la valeur la plus courte qui sert encore votre objectif. La suppression automatique est bien plus fiable que tout processus dépendant de la mémoire d'une personne.
- Choisir le mode de consentement. Décidez si et comment le consentement à l'enregistrement est capturé, et ancrez la divulgation dans le message d'ouverture de l'assistant.
- Contraindre les champs de données. Examinez chaque fonction que votre agent appelle en pleine conversation pour ses paramètres. Transmettez une référence de dossier au lieu d'un dossier client complet dans la mesure du possible.
- Contrôler la mémoire conversationnelle. Si votre agent doit reconnaître les appelants récurrents, décidez délibérément quels attributs sont stockés — et assurez-vous qu'une demande d'effacement supprime réellement l'entrée.
- Délimiter ce qui quitte la plateforme. Les données sortent par des intégrations et des webhooks. Définissez par destination quels champs sont transmis au lieu de transférer l'intégralité de l'enregistrement de la conversation.
- Tester au lieu d'espérer. Effectuez des appels de test dans lesquels vous énoncez délibérément un nom, une adresse, une date de naissance et un détail de paiement — une fois d'un seul trait, une fois épelé, une fois avec une correction. Inspectez ensuite la transcription, l'enregistrement et le log. La manière de configurer cela systématiquement est couverte sous testing.
- Documenter. Enregistrez l'objectif, la rétention, les services impliqués et les contrôles appliqués dans votre registre des activités de traitement. L'effort est ponctuel ; le bénéfice apparaît lors du premier audit.
Bonnes pratiques et erreurs courantes
Masquer avant de stocker, pas après. Si les valeurs brutes atteignent le stockage en premier et sont écrasées plus tard, elles ont existé entre-temps — dans les sauvegardes, dans les répliques, dans les index de recherche. LiveKit résout cela avec un service d'ingestion en amont qui exécute le masquage avant que les artefacts n'atteignent le magasin réel. Appliquez le même principe à votre propre chaîne.
Garder le contexte, supprimer la valeur. Une transcription avec une ligne sur deux manquante est inutile pour l'optimisation. Une transcription avec des marqueurs tels que [phone_number] ou [address] reste lisible et montre simultanément ce qui a été supprimé. Les marqueurs typés vous permettent même d'analyser à quels points d'une conversation les données sensibles apparaissent généralement.
Décider séparément de l'enregistrement et de la transcription. Pour de nombreux cas d'utilisation, la transcription masquée est tout à fait suffisante. Le fichier audio contient en outre la voix en tant qu'identifiant biométrique et est donc l'actif bien plus sensible. Demandez-vous par cas d'utilisation si vous avez réellement besoin de l'enregistrement.
Ne pas oublier les autres canaux. Si votre agent téléphonique fait partie d'une configuration omnicanale, les mêmes données apparaissent dans le chat, dans le widget web et dans les fils de messagerie. Une conception qui ne couvre que la téléphonie est incomplète. Cela compte particulièrement pour les configurations construites autour d'un centre d'appels IA couvrant plusieurs canaux.
Auditer vos propres routines d'analyse. Alimenter un modèle supplémentaire avec des transcriptions masquées pour la synthèse crée une nouvelle activité de traitement. Elle doit être documentée comme toute autre.
L'erreur la plus courante en pratique, cependant, n'est pas technique. Les équipes désactivent complètement l'enregistrement par incertitude, perdent toute voie d'amélioration, et se demandent six mois plus tard pourquoi le taux d'abandon n'a pas bougé. Le choix n'est pas "tout stocker" versus "ne rien stocker" — c'est "stocker la bonne chose".
Trois exemples industriels
Un cabinet dentaire gérant 80 contacts patients par jour. Les appels font apparaître des noms, des dates de naissance, des numéros d'assurance et fréquemment des symptômes — données de santé selon l'article 9 du RGPD. La configuration correcte ici est généralement : pas d'enregistrement audio, transcription masquée avec une courte période de rétention, prise de rendez-vous via une fonction qui transmet uniquement une référence de dossier et un créneau horaire. Le cabinet garde la capacité de vérifier que l'agent comprend correctement les demandes de planification.
Une agence immobilière avec 30 annonces actives et 15 premières demandes par jour. La motivation diffère : l'agent pré-qualifie les prospects. Les noms, les chiffres de budget et le statut de financement sont très sensibles, mais le modèle conversationnel est l'objet réel de l'optimisation. Les transcriptions masquées sont tout à fait suffisantes pour voir quelle question fait abandonner les prospects.
Un cabinet fiscal pendant la saison des déclarations. Un agent IA prend les demandes de rappel et les requêtes de documents. Les données client et les numéros fiscaux doivent être masqués sans exception, et le secret professionnel renforce encore les exigences. En même temps, savoir quelles questions reviennent vaut de l'argent réel — cela montre ce qui doit figurer dans le prochain bulletin client.
Dans les trois cas, la décision est la même : non pas s'il faut analyser, mais à partir de quoi analyser. Si vous souhaitez comparer les adéquations industrielles, des exemples sont collectés sous industries.
Conclusion
La protection des données et l'observabilité ne sont pas en conflit dans la téléphonie IA — elles ont simplement besoin du bon ordre des opérations. Masquez les données personnelles avant qu'elles ne soient stockées. Définissez une période de rétention courte et techniquement appliquée. Contraignez ce que vos fonctions et webhooks transmettent vers l'extérieur. Et testez le résultat avec des appels qui épellent délibérément les choses et se corrigent eux-mêmes.
L'industrie évolue clairement dans ce sens : les fournisseurs proposent désormais le masquage comme une capacité standard plutôt que comme un produit complémentaire. Pour les opérateurs européens, le lieu de traitement ajoute une seconde dimension — c'est pourquoi l'hébergement dans l'UE sur Famulor est le paramètre par défaut plutôt qu'un extra payant.
Prochaine étape concrète : créez un assistant de test, effectuez cinq appels avec des détails personnels délibérément dispersés, puis inspectez la transcription, l'enregistrement et le log. Une demi-heure vous dira où votre chaîne fuit. Vous pouvez commencer directement avec l'agent vocal sans code.
Essayez notre Assistant IA
Découvrez à quel point notre assistant téléphonique IA sonne naturel.
Entrez vos coordonnées et recevez un appel de notre agent IA en quelques secondes.
L'agent est formé pour parler des services Famulor et prendre des rendez-vous.
Agent IA de démo
Représentant Famulor
FAQ
Qu'est-ce que le masquage des données personnelles pour les agents vocaux IA ?
Le masquage des données personnelles est la suppression automatique des données personnelles des transcriptions, enregistrements audio et logs d'un agent téléphonique. Les valeurs détectées sont remplacées par des marqueurs typés avant que les données ne soient stockées de manière permanente.
Une expression régulière suffit-elle pour masquer les transcriptions ?
Non. Lors d'un appel, les valeurs sont épelées, divisées sur plusieurs tours et corrigées en milieu de phrase. Les méthodes basées sur des modèles manquent précisément ces cas et ne devraient compléter la détection contextuelle que sans jamais la remplacer.
Pourquoi le tour de parole entier est-il supprimé d'un enregistrement audio ?
Parce que les modèles de reconnaissance vocale ne produisent pas d'horodatages au niveau du mot parfaitement fiables. Une coupe précise pourrait laisser des fragments de la valeur sensible derrière elle. Supprimer le tour de parole entier est l'option sûre.
Combien de temps puis-je conserver les enregistrements d'appels ?
Aussi longtemps que votre objectif documenté l'exige. En pratique, la rétention pour l'assurance qualité dure généralement entre 30 et 90 jours. Ce qui compte, c'est que la période soit justifiée, documentée et appliquée automatiquement par le système.
L'absence de rétention des données remplace-t-elle le masquage ?
Non. L'absence de rétention des données régit uniquement si le fournisseur de modèle conserve votre contenu. Vos propres transcriptions, logs et enregistrements CRM ne sont pas affectés. Les deux contrôles se complètent.
Dois-je dire aux appelants qu'ils parlent à une IA ?
Oui. La divulgation concernant le système d'IA, et l'enregistrement le cas échéant, doit se faire au début de l'appel. Ancrez-la dans le message d'ouverture de l'assistant plutôt que dans des documents en aval.
Puis-je toujours analyser les appels si tout est masqué ?
Oui. Seules les valeurs personnelles sont supprimées, pas la structure conversationnelle. Les points d'abandon, les transferts incorrects et les appels d'outils échoués restent entièrement visibles et mesurables.
Que se passe-t-il lorsqu'un appelant demande l'effacement ?
Vous devez supprimer chaque copie — transcription, enregistrement, mémoire conversationnelle et enregistrements dans les systèmes en aval. C'est exactement pourquoi limiter ce que vous transférez aux systèmes tiers est rentable dès le premier jour.
Cela s'applique-t-il aussi au chat et à WhatsApp ?
Oui. Les mêmes exigences s'appliquent à chaque canal sur lequel votre agent parle aux clients. Une conception de confidentialité couvrant uniquement la téléphonie laisse la moitié des données sans gouvernance dans une configuration omnicanale.
Rédacteur chez Famulor