Inhoud samenvatten met:




Geheugen voor Voice AI-agents: Herken elke terugkerende beller
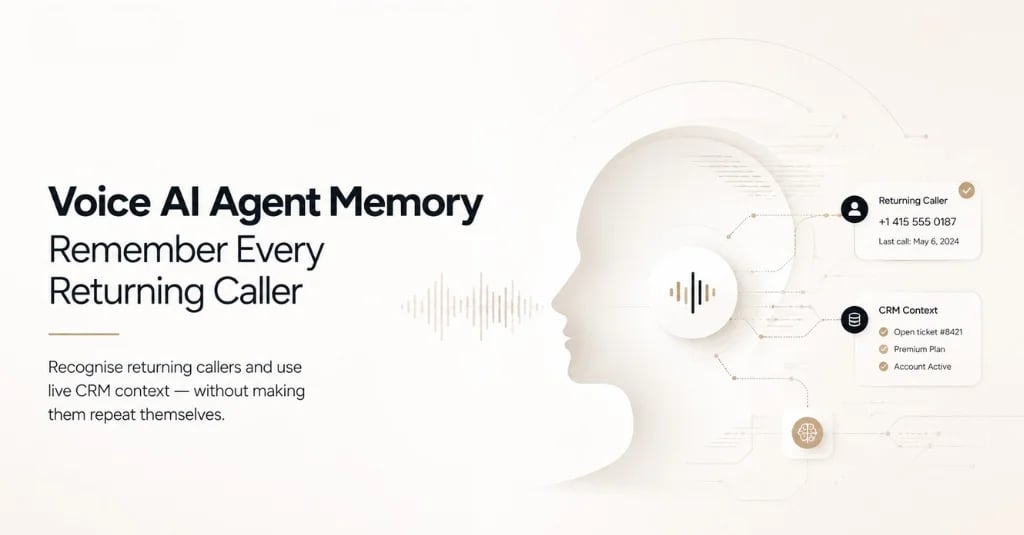
Een voice AI-agent met geheugen herkent terugkerende bellers en gebruikt hun geschiedenis in het gesprek, zonder dat de beller zichzelf opnieuw hoeft uit te leggen. In 2026 is het werkbare antwoord voor telefonie niet een geheugenlaag die alles opslaat. Het antwoord is: een stabiele identiteit via het telefoonnummer, feiten uit een gecureerde kennisbank en een live blik in het CRM tijdens het gesprek. Scheid die drie en je krijgt personalisatie zonder de foutgevoeligheid die generieke geheugensystemen vaak onbetrouwbaar maakt.
Geheugen aan de telefoon is een ander probleem dan geheugen in een chat. Dat is geen mening, maar de conclusie van onderzoek naar AI-geheugen. Het AI Agent Memory Report 2026 van Mem0 stelt dat voice-agents een geheugenprobleem hebben dat kwalitatief verschilt van dat van tekst-agents: de gebruiker kan niet terugscrollen, geen context uit een vorige sessie kopiëren en de agent niet handmatig herinneren aan eerdere gesprekken. Als de agent het niet onthoudt, is de frictie direct en overduidelijk. Dit artikel bespreekt welke soorten geheugen er bestaan, welke problemen aantoonbaar onopgelost zijn en hoe Famulor de oplosbare onderdelen vandaag de dag in productie brengt.
Wat "geheugen" voor voice-agents werkelijk betekent
De term wordt nogal losjes gebruikt. In de praktijk dekt het vier verschillende zaken die technisch weinig met elkaar gemeen hebben:
- Contextvenster: Wat de agent vasthoudt tijdens het live gesprek. Dat is geen geheugen, maar werkgeheugen; het is weg zodra de beller ophangt.
- Episodisch geheugen: Wat er is gebeurd. "De heer Berger belde op 3 juli over een factuur."
- Semantisch geheugen: Wat er bekend is. "De heer Berger is een bestaande klant met het L-abonnement."
- Procedureel geheugen: Hoe dingen moeten worden afgehandeld. "Route factuurvragen boven de 500 euro altijd naar de boekhouding."
Het geheugenrapport noemt episodisch, semantisch en procedureel expliciet als de drie typen die productie-agents nodig hebben, en merkt op dat tooling voor de derde categorie nog in de kinderschoenen staat. Voor telefonie is dit onderscheid doorslaggevend, omdat de drie typen elk een eigen opslaglocatie verdienen. Procedurele kennis hoort thuis in de Flow Builder en de prompt, niet in een vectordatabase waar je het probabilistisch uit moet vissen. Semantische kennis over je bedrijf hoort in de kennisbank. En episodische kennis over een specifieke beller staat bijna altijd al in je CRM; die hoef je niet te dupliceren, die moet je bevragen.
Die classificatie is de hele truc. De meeste projecten voor voice-agentgeheugen falen omdat ze alle vier de typen in één systeem proppen.
Waarom telefonie de moeilijkste casus voor geheugen is
In een chat kan de gebruiker achteraf context toevoegen. Ze scrollen omhoog, plakken een ordernummer of corrigeren de bot. Aan de telefoon bestaan die vangnetten niet. Dit leidt tot drie harde randvoorwaarden.
Latentie is niet onderhandelbaar. Een geheugenopzoeking die het antwoord blokkeert, is direct hoorbaar tijdens een gesprek. Het rapport noemt dit de meest voorkomende fout in productie en merkt op dat Mem0 in versie 1.0.0 asynchrone geheugenschrijfacties de standaard heeft gemaakt. Dat lost het schrijven op. Lezen blijft echter in het kritieke pad: zet een semantische zoekopdracht over een vectorstore vóór je eerste antwoord en je betaalt de prijs in de vorm van dode stilte.
Verkeerd geheugen is erger dan geen geheugen. Als de agent zegt "je belde vorige week over je contract" en dat klopt niet, dan is het gesprek beschadigd. In een chat lees je er overheen. Aan de telefoon is het een breuk in het contact.
Er is geen eenduidige login-identiteit. Een webgebruiker is geauthenticeerd. Een beller is een telefoonnummer, met alle ambiguïteit van dien: afgeschermde nummers, gedeelde lijnen, gezinsleden op dezelfde vaste lijn, mensen die wisselen tussen mobiel en vast.
Wat ons bij het werkelijk interessante punt brengt: dat identiteitsprobleem wordt in het onderzoek als onopgelost beschouwd.
De openstaande problemen en wat ze betekenen voor je beslissing
Het rapport is ongebruikelijk openhartig over wat er nog openstaat. Drie punten raken telefonie direct.
Identiteitsresolutie over sessies heen. Het geheugenmodel gaat uit van een stabiele user_id. Anonieme sessies, gebruikers met meerdere apparaten en gemengde auth-flows doorbreken die aanname. Of twee interacties van dezelfde persoon kwamen, is volgens het rapport "een onopgelost identiteitsprobleem in de geheugenlaag."
Veroudering van geheugen (staleness). Een veel opgevraagd geheugen over de werkgever van een gebruiker is accuraat, totdat diegene van baan wisselt; op dat moment wordt het vol overtuiging foutief. Decay (verval) helpt bij geheugen met een lage relevantie, maar veroudering bij geheugen met een hoge relevantie wordt in het rapport omschreven als "een moeilijker, openstaand probleem."
Privacy en toestemmingsarchitectuur. Wie mag opgeslagen geheugen inzien? Hoe lang wordt het bewaard? Hoe verwijdert een gebruiker het? Het rapport noemt dit expliciet beslissingen op applicatieniveau; het geheugensysteem zelf geeft hier geen antwoord op. Voor elke gereguleerde of Europese implementatie is dit de kern, aangezien AVG-rechten voor inzage en verwijdering geen standaardonderdelen zijn van de roadmap.
De praktische consequentie: een leverancier die je "geheugen" verkoopt als een kant-en-klare functie, verkoopt je een probleem dat in de literatuur als openstaand wordt genoteerd. De duurzame architectuur omzeilt deze drie punten in plaats van ze te negeren.
Het pragmatische pad: scheid identiteit, feiten en live data
Famulor lost personalisatie niet op via een speculatieve geheugenlaag, maar via drie heldere bouwstenen.
1. Het telefoonnummer als stabiele identiteit. Wat op het web lastig is, is relatief eenvoudig aan de telefoon: caller ID komt mee met het gesprek. Het is geen perfecte identificatie van een persoon, maar wel een uitstekende sleutel voor een record. Het rapport wijst terloops op precies dit patroon: in de ElevenLabs-integratie is de USER_ID die geheugens afbakent afgeleid van de identiteit van de geauthenticeerde gebruiker in de aanroepende applicatie, niet gegenereerd door het geheugensysteem zelf, waardoor isolatie gekoppeld blijft aan auth op applicatieniveau. Vertaald naar telefonie: jouw CRM is eigenaar van de identiteit, niet de voice-agent.
2. Feiten in de kennisbank. Openingstijden, prijscategorieën, retourtermijnen, verantwoordelijkheden; dat is semantische kennis. Deze hoort thuis in de kennisbank en wordt opgehaald via RAG. Cruciaal is dat je dit op één plek beheert, het niet stilletjes veroudert op de achtergrond en je het kunt auditen. Dat is het echte antwoord op veroudering: geen decay-logica, maar een gecureerde bron.
3. Bevraag de bellersgeschiedenis live in plaats van deze op te slaan. Dit is de kern. In plaats van een kopie van de klantgeschiedenis in de agent te bewaren, haalt Famulor deze tijdens het gesprek op uit het systeem waar de data al leeft, via mid-call tools of de MCP-connector. De agent vraagt wanneer nodig: "Is er een openstaande case voor dit nummer?" Het antwoord is per definitie actueel.
Dit elimineert veroudering volledig; een live query kan niet verouderen. Het lost grotendeels het toestemmingsprobleem op, omdat er geen tweede kopie van persoonsgegevens wordt aangemaakt. En het maakt verwijderen triviaal: verwijder het record in het CRM en het is weg. Niets om na te jagen in een vectorstore.
Na het gesprek sluit post-call analyse de cirkel en schrijft het resultaat, de intentie en de volgende stap terug, via een van de 300+ integraties. Het bronsysteem blijft van jou.
Vergelijking: geheugenlaag vs. live lookup
| Criterium | Toegewijde geheugenlaag | Live lookup (Famulor-aanpak) |
|---|---|---|
| Versheid | Snapshot; veroudering is een open probleem volgens rapport | Altijd actueel, bron is het bronsysteem |
| Identiteit | Vereist stabiele user_id; onopgelost volgens rapport | Telefoonnummer als sleutel voor CRM |
| Leeslatentie | Semantisch zoeken in het kritieke pad | Gerichte lookup, alleen wanneer nodig |
| AVG-verwijdering | Tweede kopie moet ook worden verwijderd | Eén record, één verwijdering |
| Vals geheugen | Mogelijk, en klinkt overtuigend | Uitgesloten; er wordt niets gegokt |
| Ongestructureerde context | Sterk: voorkeuren, toon, nuance | Beperkt tot wat gestructureerd bestaat |
| Operationele overhead | Vectorstore, embeddings, reranking | Bestaande API, geen nieuwe stack |
Eerlijk is eerlijk: een echte geheugenlaag heeft één kracht die de live lookup niet heeft. Ongestructureerde voorkeuren — "bel me nooit voor de middag", "raakt geïrriteerd door vervolgvragen" — staan in geen enkel CRM-veld. Als je die nuance nodig hebt, is een geheugensysteem onvermijdelijk. Maar het rapport toont ook de kosten: een vectorstore kiezen uit 20 opties, reranking als tweede pass, metadata-filtering, timestamp-migratie. Voor de grote meerderheid van telefonie-usecases is de live lookup de betere deal; de feiten die ertoe doen zijn al gestructureerd.
Implementatie stap voor stap
Stap 1 — Bepaal wat je echt nodig hebt. Schrijf de vijf meest voorkomende redenen op waarom terugkerende bellers contact opnemen. Vraag je voor elk af: is de benodigde informatie al gestructureerd in het CRM? Bijna altijd is het antwoord ja: casusstatus, laatste afspraak, openstaande factuur. Dan heb je geen geheugensysteem nodig, maar een lookup.
Stap 2 — Definieer identiteitsresolutie. Specificeer wat er gebeurt bij een match, geen match en multi-match. Multi-match is de casus die ertoe doet: twee records op dezelfde vaste lijn is de dagelijkse realiteit. Laat de agent verifiëren ("spreek ik met de heer of mevrouw Berger?") in plaats van gokken. Bij een afgeschermd nummer draait de standaardflow zonder personalisatie.
Stap 3 — Koppel de lookup-tool. Definieer een mid-call tool die het telefoonnummer neemt en een compact resultaat teruggeeft: naam, status, openstaande case. Houd de payload klein. Een JSON-blob van 40 velden helpt het model niet, het leidt het af.
Stap 4 — Veranker het gedrag in de prompt. Spel uit hoe je met het lookup-resultaat omgaat: bij een match, begroet bij naam en breng de openstaande case proactief ter sprake. Bij geen match, begin neutraal. Claim nooit dat je iets onthoudt als de tool niets heeft teruggegeven.
Stap 5 — Stel escalatieregels in. Wanneer de lookup een kritieke status naar boven haalt (openstaande klacht, opzeggingsbericht), route het gesprek dan naar een mens via een doorverbinding. Herkenning is niet hetzelfde als volledige automatisering.
Stap 6 — Schrijf terug en meet. Post-call analyse schrijft het resultaat terug. Meet vervolgens het enige getal dat ertoe doet: daalt de gespreksduur voor terugkerende bellers zonder dat het afhaakpercentage stijgt?
Best practices en veelgemaakte fouten
Breng alleen ter sprake wat je kunt bewijzen. De agent mag zeggen: "Ik zie een openstaande case met betrekking tot uw factuur." Het mag niet zeggen: "u leek de vorige keer ontevreden." Het eerste is een dataveld; het tweede is een interpretatie.
Doseer de personalisatie. Een agent die uit eigen beweging drie details uit de geschiedenis opnoemt, klinkt opdringerig. Eén detail dat het gesprek verkort, klinkt competent. Minder is hier meer.
Plaats de lookup niet vóór de begroeting. Dit is de meest gemaakte fout wat betreft latentie. Begroet eerst, query parallel. Je eerste lettergreep achter een API-call plaatsen gooit precies datgene weg wat voice AI snel laat voelen; filler-audio kan de wachttijd natuurlijk overbruggen wanneer een query langer duurt.
Houd rekening met tegenspraak. Beller zegt A, CRM zegt B. Regel: de mens wint altijd. De agent noteert de discrepantie in plaats van in discussie te gaan.
Ontwerp vanaf dag één voor inzage en verwijdering. Als een beller vraagt wat er is opgeslagen, moet je een antwoord hebben. Met de live lookup is het simpel: wat is opgeslagen is wat in het CRM staat, plus het gesprekslogboek. Die eenvoud is precies waarom we geen tweede kopie aanmaken. De contractuele kant wordt afgehandeld via de verwerkersovereenkomst.
Industrie-voorbeelden
Becker Tandartspraktijk, 60 medewerkers. Een patiënt belt om een controle te verzetten. De lookup op het nummer van de beller geeft terug: afspraak 24 juli, 09:30, mondhygiëne. De agent begroet bij naam, noemt de afspraak en biedt drie alternatieven. Zonder herkenning begint hetzelfde gesprek met "mag ik uw naam en over welke afspraak gaat het?"; 40 seconden die niemand nodig heeft. De episodische kennis werd nooit opgeslagen; het kwam live uit de praktijksoftware.
Süd Auto Group, 3 locaties. Een klant belt over een serviceafspraak. De lookup toont: voertuig sinds gisteren in de werkplaats, onderdeel besteld, levering vrijdag. De agent geeft precies dat door. Een opgeslagen geheugen uit het vorige gesprek had de status van twee dagen geleden bevat; een schoolvoorbeeld van een fout door veroudering.
Meier Vastgoedbeheer, 4.200 eenheden. Een huurder meldt opnieuw een verwarmingsstoring. De lookup toont een openstaande case met een gepland bezoek van een aannemer. De agent noemt de datum en, bij een herhaalde melding van dezelfde storing, draagt het gesprek over aan een casemanager; de escalatieregel wordt geactiveerd omdat de status in het systeem leeft.
Het patroon is overal identiek: de waardevolle context is al gestructureerd. Het hoeft niet onthouden te worden, het moet bevraagd worden.
Bereken je ROI met geautomatiseerde gesprekken
Ontdek hoeveel je per maand bespaart via AI voice agents.
ROI Resultaat
ROI 0%
Geen creditcard nodig
Conclusie
Voor voice-agents is "geheugen" het verkeerde woord voor het juiste doel. Het doel is: de beller moet zichzelf niet hoeven uit te leggen. In 2026 loopt de weg daarheen niet via een geheugenlaag waarvan de kernproblemen (identiteit over sessies heen, veroudering, toestemmingsarchitectuur) in de literatuur zelf als openstaand worden genoteerd. Het loopt via een heldere scheiding: het telefoonnummer levert de identiteit, de kennisbank levert de feiten, het CRM levert de geschiedenis; live, op het moment van het gesprek.
Famulor is precies daarvoor gebouwd. Mid-call tools en de MCP-connector halen context uit het systeem waar deze al wordt beheerd. De kennisbank houdt feiten gecureerd. Post-call analyse schrijft terug. Geen tweede datastore, geen vectordatabase, geen verwijderingsbeleid voor een kopie die niemand nodig had.
De concrete volgende stap: neem de meest voorkomende reden waarom je vaste bellers contact opnemen, koppel één lookup-tool op basis van het telefoonnummer en meet de gespreksduur gedurende twee weken. Dat is een middag werk en het beantwoordt de vraag of je überhaupt ooit een geheugenlaag nodig zult hebben. In de meeste gevallen is het antwoord nee.
Probeer onze AI-assistent
Ervaar hoe natuurlijk onze AI-telefoonassistent klinkt.
Vul je gegevens in en ontvang binnen enkele seconden een oproep van onze AI-agent.
De agent is getraind om over Famulor-diensten te praten en afspraken te maken.

Demo AI-agent
Famulor medewerker
FAQ
Kan een AI-telefoonagent eerdere gesprekken onthouden?
Ja. In de praktijk wordt de geschiedenis niet in de agent opgeslagen, maar live bevraagd uit het CRM met behulp van het telefoonnummer. Het resultaat is identiek voor de beller en altijd actueel.
Waarom is geheugen lastiger voor voice-agents dan voor chat?
Omdat de beller niet terug kan scrollen of achteraf context kan toevoegen. Het Mem0-rapport 2026 noemt dit een kwalitatief ander probleem: als de agent het vergeet, is de frictie direct.
Wat is geheugenveroudering (staleness)?
Opgeslagen informatie die ooit correct was en onjuist wordt wanneer de realiteit verandert; een baanwissel bijvoorbeeld. Volgens het Mem0-rapport is veroudering bij geheugen met een hoge relevantie een openstaand probleem. Live queries voorkomen dit.
Identificeert Famulor bellers op telefoonnummer?
Ja. Caller ID fungeert als de sleutel voor een lookup via een mid-call tool of MCP-connector. Bij een afgeschermd nummer gaat het gesprek door zonder personalisatie.
Is bellersherkenning AVG-compliant?
Dat kan. De live lookup heeft een voordeel omdat er geen tweede kopie van persoonsgegevens wordt aangemaakt: inzage en verwijdering blijven op één plek. De details worden geregeld via de verwerkersovereenkomst.
Vertraagt een geheugen-lookup het gesprek?
Alleen als de volgorde verkeerd is. Schrijfacties lopen asynchroon. De lookup hoort parallel aan de begroeting, niet ervoor; dan is het onmerkbaar in het gesprek.
Wat hoort in de kennisbank versus het CRM?
De kennisbank bevat algemene feiten zoals openingstijden, prijzen en procedures. Het CRM bevat alles wat beller-specifiek is: cases, afspraken en facturen.
Wanneer heb ik echt een geheugenlaag nodig?
Wanneer je wilt handelen op basis van ongestructureerde voorkeuren over vele gesprekken heen die in geen enkel CRM-veld staan. Voor de meeste telefonie-usecases zijn de relevante feiten al gestructureerd.

Auteur bij Famulor