Résumer le contenu avec:




Mémoire des agents vocaux IA : reconnaître chaque appelant récurrent
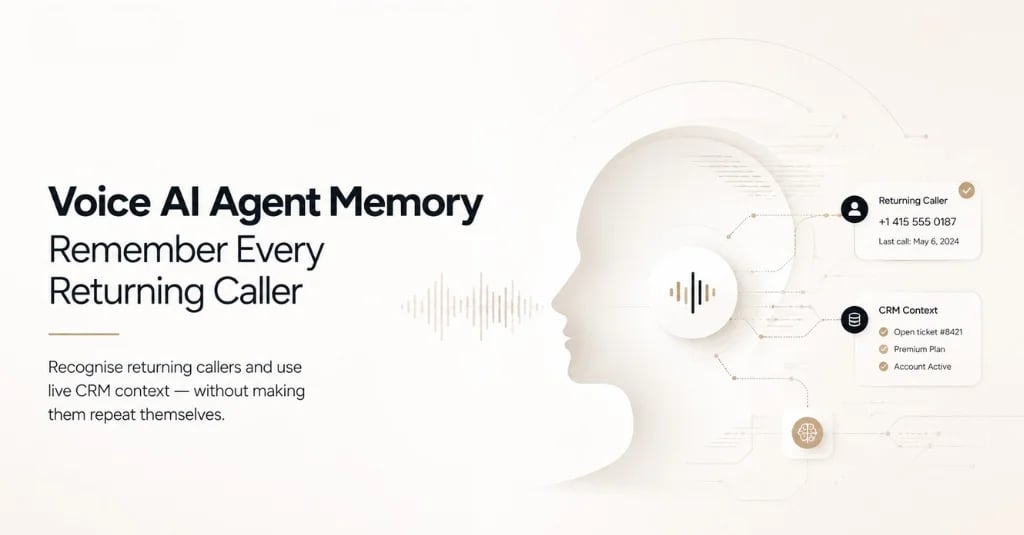
Un agent vocal doté d'une mémoire reconnaît les appelants récurrents et utilise leur historique au cours de la conversation, évitant ainsi à l'interlocuteur de se répéter. En 2026, la solution viable pour la téléphonie n'est pas une « couche de mémoire qui stocke tout ». Il s'agit plutôt d'une identité stable via le numéro de téléphone, de faits issus d'une base de connaissances structurée et d'une consultation en temps réel du CRM pendant l'appel. Séparez ces trois éléments et vous obtiendrez une personnalisation sans les modes de défaillance qui nuisent aux systèmes de mémoire génériques.
La mémoire au téléphone est un problème différent de la mémoire par chat. Ce n'est pas une opinion, c'est le constat même des recherches sur la mémoire. Le AI Agent Memory Report 2026 de Mem0 indique que les agents vocaux font face à un problème de mémoire « qualitativement différent » de celui des agents textuels : l'utilisateur ne peut pas faire défiler l'historique, ne peut pas copier-coller du contexte d'une session précédente et ne peut pas rappeler manuellement à l'agent les conversations passées. Si l'agent ne se souvient pas, la friction est immédiate et évidente. Cet article détaille les types de mémoire existants, les problèmes non résolus et la manière dont Famulor met en production les parties exploitables dès aujourd'hui.
Ce que signifie réellement la « mémoire » pour les agents vocaux
Le terme est utilisé de manière vague. En pratique, il recouvre quatre concepts techniques distincts :
- Fenêtre de contexte : Ce que l'agent retient pendant l'appel en cours. Ce n'est pas de la mémoire, mais du stockage de travail, qui disparaît une fois l'appel terminé.
- Mémoire épisodique : Ce qui s'est passé. « M. Berger a appelé le 3 juillet au sujet d'une facture. »
- Mémoire sémantique : Ce qui est connu. « M. Berger est un client existant avec un forfait L. »
- Mémoire procédurale : Comment les choses doivent être faites. « Toujours transférer les questions de facturation supérieures à 500 euros au service comptabilité. »
Le rapport sur la mémoire liste explicitement l'épisodique, le sémantique et le procédural comme les trois types nécessaires aux agents en production, tout en notant que les outils pour le troisième sont encore au stade préliminaire. Pour la téléphonie, cette distinction est décisive, car ces trois types méritent des emplacements de stockage totalement différents. Les connaissances procédurales appartiennent au Flow Builder et au prompt, et non à une base de données vectorielle dans laquelle il faudrait les repêcher de manière probabiliste. Les connaissances sémantiques sur votre entreprise appartiennent à la base de connaissances. Quant aux connaissances épisodiques sur un appelant spécifique, elles résident presque toujours déjà dans votre CRM : il n'est pas nécessaire de les dupliquer, il faut les interroger.
Cette classification est toute l'astuce. La plupart des projets de mémoire pour agents vocaux échouent parce qu'ils mélangent ces quatre éléments dans un seul système.
Pourquoi la téléphonie est le cas le plus complexe pour la mémoire
Par chat, l'utilisateur peut fournir du contexte après coup. Il peut remonter l'historique, coller un numéro de commande, corriger le bot. Au téléphone, aucune de ces solutions de repli n'existe. Trois contraintes majeures en découlent.
La latence n'est pas négociable. Une recherche en mémoire qui bloque la réponse est directement audible lors d'un appel. Le rapport identifie cela comme l'erreur la plus courante en production et note que Mem0 a rendu les écritures asynchrones par défaut dans la version 1.0.0. Cela résout les écritures. Les lectures restent sur le chemin critique : si vous placez une recherche sémantique sur une base vectorielle avant votre première réponse, vous le paierez par des silences gênants.
Une mauvaise mémoire est pire que l'absence de mémoire. Si l'agent dit « vous avez appelé la semaine dernière au sujet de votre contrat » alors que c'est faux, la conversation est compromise. Par chat, on passe outre. Au téléphone, c'est une rupture.
Il n'y a pas d'identité de connexion claire. Un utilisateur web est authentifié. Un appelant est un numéro de téléphone, avec toute l'ambiguïté que cela comporte : numéros masqués, lignes partagées, membres d'une même famille sur la même ligne fixe, personnes alternant entre mobile et téléphone fixe.
Ce qui nous amène au point réellement intéressant : ce problème d'identité est considéré comme non résolu par la recherche.
Les problèmes ouverts et ce qu'ils impliquent pour vos décisions
Le rapport est inhabituellement franc sur ce qui reste à résoudre. Trois points touchent directement la téléphonie.
Résolution d'identité inter-sessions. Le modèle de mémoire suppose un user_id stable. Les sessions anonymes, les utilisateurs multi-appareils et les flux d'authentification mixtes brisent cette hypothèse. Déterminer si deux interactions proviennent de la même personne est, selon les termes du rapport, « un problème d'identité non résolu au niveau de la couche mémoire ».
Obsolescence de la mémoire. Une mémoire fréquemment consultée sur l'employeur d'un utilisateur est exacte, jusqu'à ce qu'il change de travail, moment où elle devient fausse avec assurance. La dégradation gère les mémoires de faible pertinence ; l'obsolescence des mémoires de haute pertinence est décrite dans le rapport comme « un problème plus difficile et non résolu ».
Architecture de confidentialité et de consentement. Qui peut inspecter les mémoires stockées ? Combien de temps sont-elles conservées ? Comment un utilisateur peut-il les supprimer ? Le rapport qualifie explicitement ces points de décisions au niveau de l'application : le système de mémoire n'y répond pas. Pour tout déploiement réglementé ou européen, c'est le point crucial, car les droits d'accès et de suppression du RGPD ne sont pas des éléments prévus dans les feuilles de route.
La conséquence pratique : un fournisseur qui vous vend une « mémoire » comme une fonctionnalité finie vous vend un problème que la littérature liste comme ouvert. L'architecture durable contourne ces trois points plutôt que de les ignorer.
La voie pragmatique : séparer identité, faits et données en direct
Famulor résout la personnalisation non pas par une couche de mémoire spéculative, mais par trois blocs de construction clairs.
1. Le numéro de téléphone comme identité stable. Ce qui est difficile sur le web est relativement simple au téléphone : l'identification de l'appelant arrive avec l'appel. Ce n'est pas un identifiant de personne parfait, mais c'est une excellente clé pour un enregistrement. Le rapport souligne ce modèle en passant : dans l'intégration ElevenLabs, le USER_ID qui définit les mémoires est dérivé de l'identité de l'utilisateur authentifié dans l'application appelante, et non généré par le système de mémoire, gardant l'isolation liée à l'authentification au niveau de l'application. Traduit en téléphonie : votre CRM possède l'identité, pas l'agent vocal.
2. Les faits dans la base de connaissances. Horaires d'ouverture, niveaux de tarification, délais de retour, responsabilités : ce sont des connaissances sémantiques. Elles appartiennent à la base de connaissances et sont récupérées via RAG. Surtout, vous les maintenez à un seul endroit, elles ne se dégradent pas silencieusement en arrière-plan et vous pouvez les auditer. C'est la vraie réponse à l'obsolescence : non pas une logique de dégradation, mais une source organisée.
3. Interroger l'historique de l'appelant en direct au lieu de le stocker. C'est le cœur du sujet. Plutôt que de conserver une copie de l'historique client dans l'agent, Famulor le récupère en pleine conversation depuis le système où il réside déjà, via des outils en cours d'appel ou le connecteur MCP. L'agent demande, si nécessaire : « Y a-t-il un dossier ouvert pour ce numéro ? » La réponse est actuelle par définition.
Cela élimine totalement l'obsolescence : une requête en direct ne peut pas être obsolète. Cela résout en grande partie le problème du consentement, car aucune seconde copie de données personnelles n'est créée. Et cela rend la suppression triviale : supprimez l'enregistrement dans le CRM et il disparaît. Rien à traquer dans une base vectorielle.
Après l'appel, l'analyse post-appel boucle le processus et réécrit le résultat, l'intention et l'étape suivante via l'une des 300+ intégrations. Le système d'enregistrement reste le vôtre.
Comparaison : couche de mémoire vs recherche en direct
| Critère | Couche de mémoire dédiée | Recherche en direct (approche Famulor) |
|---|---|---|
| Fraîcheur | Instantané ; obsolescence problème ouvert selon le rapport | Toujours à jour, la source est le système d'enregistrement |
| Identité | Nécessite un user_id stable ; non résolu selon le rapport | Numéro de téléphone comme clé vers le CRM |
| Latence de lecture | Recherche sémantique sur le chemin critique | Recherche ciblée, uniquement quand nécessaire |
| Suppression RGPD | La seconde copie doit aussi être supprimée | Un enregistrement, une suppression |
| Fausse mémoire | Possible, et semble convaincant | Exclu : rien n'est deviné |
| Contexte non structuré | Fort : préférences, ton, nuance | Limité à ce qui existe de manière structurée |
| Frais opérationnels | Base vectorielle, embeddings, reranking | API existante, pas de nouvelle pile |
Pour être juste : une vraie couche de mémoire a une force que la recherche en direct n'a pas. Les préférences non structurées (« ne m'appelez jamais avant midi », « s'irrite des questions de suivi ») ne vivent dans aucun champ CRM. Si vous avez besoin de cette nuance, un système de mémoire est inévitable. Mais le rapport montre aussi le coût : une base vectorielle choisie parmi 20 options, le reranking comme seconde passe, le filtrage des métadonnées, la migration des horodatages. Pour la grande majorité des cas d'usage en téléphonie, la recherche en direct est le meilleur compromis : les faits qui comptent sont déjà structurés.
Mise en œuvre étape par étape
Étape 1 : Décidez de ce dont vous avez réellement besoin. Notez les cinq raisons les plus courantes pour lesquelles les appelants récurrents vous contactent. Pour chacune, demandez-vous : les informations requises sont-elles déjà structurées dans le CRM ? Presque toujours, la réponse est oui : statut du dossier, dernier rendez-vous, facture impayée. Dans ce cas, vous n'avez pas besoin d'un système de mémoire, vous avez besoin d'une recherche.
Étape 2 : Définissez la résolution d'identité. Spécifiez ce qui se passe en cas de correspondance, d'absence de correspondance et de correspondance multiple. La correspondance multiple est le cas qui compte : deux dossiers sur la même ligne fixe sont une réalité quotidienne. Faites vérifier l'agent (« suis-je en ligne avec M. ou Mme Berger ? ») plutôt que de deviner. Sur un numéro masqué, le flux standard s'exécute sans personnalisation.
Étape 3 : Connectez l'outil de recherche. Définissez un outil en cours d'appel qui prend le numéro de téléphone et renvoie un résultat compact : nom, statut, dossier ouvert. Gardez la charge utile légère. Un blob JSON de 40 champs n'aide pas le modèle, il le distrait.
Étape 4 : Ancrez le comportement dans le prompt. Précisez comment gérer le résultat de la recherche : en cas de correspondance, saluez par le nom et soulevez le dossier ouvert de manière proactive. En l'absence de correspondance, commencez de manière neutre. Ne prétendez jamais vous souvenir quand l'outil n'a rien renvoyé.
Étape 5 : Définissez les règles d'escalade. Lorsque la recherche fait apparaître un statut critique (plainte ouverte, avis d'annulation), transférez l'appel à un humain. La reconnaissance n'est pas la même chose que l'automatisation complète.
Étape 6 : Réécrivez et mesurez. L'analyse post-appel réécrit le résultat. Ensuite, mesurez le seul chiffre qui compte : le temps de traitement pour les appelants récurrents diminue-t-il sans que le taux d'abandon n'augmente ?
Bonnes pratiques et erreurs courantes
Ne soulevez que ce que vous pouvez prouver. L'agent peut dire : « Je vois un dossier ouvert concernant votre facture. » Il ne doit pas dire : « vous sembliez mécontent la dernière fois. » Le premier est un champ de données ; le second est une interprétation.
Dosez la personnalisation. Un agent qui propose trois détails de l'historique semble intrusif. Un détail qui raccourcit l'appel semble compétent. Moins, c'est mieux ici.
Ne placez pas la recherche avant la salutation. C'est l'erreur de latence la plus courante. Saluez d'abord, interrogez en parallèle. Placer votre première syllabe derrière un appel API gâche exactement ce qui rend l'IA vocale rapide, et l'audio de remplissage peut combler l'attente naturellement lorsqu'une requête prend du temps.
Prévoyez la contradiction. L'appelant dit A, le CRM dit B. Règle : l'humain gagne toujours. L'agent note la divergence au lieu de discuter.
Concevez pour l'accès et la suppression dès le premier jour. Si un appelant demande ce qui est stocké, vous avez besoin d'une réponse. Avec la recherche en direct, c'est simple : ce qui est stocké est ce qui est dans le CRM, plus le journal d'appels. Cette simplicité est précisément la raison pour laquelle nous ne créons pas de seconde copie. L'aspect contractuel est géré par l'accord de traitement des données.
Exemples industriels
Cabinet dentaire Becker, 60 employés. Un patient appelle pour déplacer un contrôle. La recherche sur le numéro de l'appelant renvoie : rendez-vous le 24 juillet, 09:30, hygiène. L'agent salue par le nom, indique le rendez-vous et propose trois alternatives. Sans reconnaissance, le même appel commence par « puis-je avoir votre nom et de quel rendez-vous s'agit-il ? » : 40 secondes dont personne n'a besoin. La connaissance épisodique n'a jamais été stockée ; elle provenait en direct du logiciel du cabinet.
Süd Auto Group, 3 sites. Un client appelle pour une réservation de service. La recherche montre : véhicule à l'atelier depuis hier, pièce commandée, livraison vendredi. L'agent relaie exactement cela. Une mémoire stockée de l'appel précédent aurait conservé le statut d'il y a deux jours : une erreur classique d'obsolescence.
Gestion immobilière Meier, 4 200 unités. Un locataire signale à nouveau une panne de chauffage. La recherche montre un dossier ouvert avec une visite d'entrepreneur prévue. L'agent indique la date et, en cas de signalement répété de la même panne, transfère à un gestionnaire de dossier : la règle d'escalade se déclenche car le statut vit dans le système.
Le modèle est identique partout : le contexte précieux est déjà structuré. Il n'a pas besoin d'être mémorisé, il a besoin d'être interrogé.
Estimez votre ROI en automatisant vos appels
Voyez combien vous pourriez économiser chaque mois grâce aux voice agents IA.
Résultat ROI
ROI 0%
Sans carte bancaire
Conclusion
Pour les agents vocaux, « mémoire » est le mauvais mot pour le bon objectif. L'objectif est : l'appelant ne devrait pas avoir à se justifier. En 2026, le chemin pour y parvenir ne passe pas par une couche de mémoire dont les problèmes fondamentaux (identité inter-sessions, obsolescence, architecture de consentement) sont listés comme ouverts par la littérature elle-même. Il passe par une séparation claire : le numéro de téléphone fournit l'identité, la base de connaissances fournit les faits, le CRM fournit l'historique, en direct, au moment de l'appel.
Famulor est conçu exactement pour cela. Les outils en cours d'appel et le connecteur MCP récupèrent le contexte depuis le système où il est déjà maintenu. La base de connaissances garde les faits organisés. L'analyse post-appel réécrit les données. Pas de second magasin de données, pas de base de données vectorielle, pas de politique de suppression pour une copie dont personne n'avait besoin.
L'étape concrète suivante : prenez la raison la plus courante pour laquelle vos habitués appellent, connectez un outil de recherche basé sur le numéro de téléphone et mesurez le temps de traitement pendant deux semaines. C'est une après-midi de travail, et cela répond à la question de savoir si vous aurez jamais besoin d'une couche de mémoire. Dans la plupart des cas, la réponse est non.
Essayez notre Assistant IA
Découvrez à quel point notre assistant téléphonique IA sonne naturel.
Entrez vos coordonnées et recevez un appel de notre agent IA en quelques secondes.
L'agent est formé pour parler des services Famulor et prendre des rendez-vous.

Agent IA de démo
Représentant Famulor
FAQ
Un agent téléphonique IA peut-il se souvenir des appels précédents ?
Oui. En pratique, l'historique n'est pas stocké dans l'agent mais interrogé en direct depuis le CRM en utilisant le numéro de téléphone. Le résultat est identique pour l'appelant et toujours à jour.
Pourquoi la mémoire est-elle plus difficile pour les agents vocaux que pour le chat ?
Parce que l'appelant ne peut pas faire défiler l'historique ou fournir du contexte après coup. Le rapport Mem0 2026 qualifie cela de problème qualitativement différent : si l'agent oublie, la friction est immédiate.
Qu'est-ce que l'obsolescence de la mémoire ?
Des informations stockées qui étaient autrefois correctes et deviennent fausses lorsque la réalité change, comme un changement d'emploi. Selon le rapport Mem0, l'obsolescence dans les mémoires de haute pertinence est un problème ouvert. Les requêtes en direct l'évitent.
Famulor identifie-t-il les appelants par numéro de téléphone ?
Oui. L'identification de l'appelant agit comme la clé pour une recherche via un outil en cours d'appel ou un connecteur MCP. Sur un numéro masqué, l'appel se poursuit sans personnalisation.
La reconnaissance de l'appelant est-elle conforme au RGPD ?
Elle peut l'être. La recherche en direct a un avantage car aucune seconde copie de données personnelles n'est créée : l'accès et la suppression restent au même endroit. Les spécificités sont régies par l'accord de traitement des données.
Une recherche en mémoire ralentit-elle la conversation ?
Seulement si elle est mal séquencée. Les écritures s'exécutent de manière asynchrone. La recherche doit être parallèle à la salutation, pas avant : elle est alors imperceptible dans l'appel.
Qu'est-ce qui appartient à la base de connaissances par rapport au CRM ?
La base de connaissances contient des faits généraux tels que les horaires d'ouverture, les tarifs et les procédures. Le CRM contient tout ce qui est spécifique à l'appelant : dossiers, rendez-vous et factures.
Quand ai-je réellement besoin d'une couche de mémoire ?
Lorsque vous souhaitez agir sur des préférences non structurées à travers de nombreuses conversations qui ne vivent dans aucun champ CRM. Pour la plupart des cas d'usage en téléphonie, les faits pertinents sont déjà structurés.

Rédacteur chez Famulor