Inhoud samenvatten met:



Duitse versus Engelse Voice AI: wat onze benchmark laat zien
Het korte antwoord: Duits maakt je voice-agent niet trager. In onze benchmark van 13 oktober 2026 doorstonden alle negen pipeline-stacks de vier testtaken in zowel het Duits als het Engels. Zeven van de negen bevestigden zelfs iets sneller in het Duits.
De echte verschillen zitten elders. Slechts 15 van de 23 spraakherkenningsmodellen begrijpen Duits. De ranglijst van de beste modellen verschilt per taal. En na een Duitse onderbreking werd de agent later stil dan na een Engelse. Dit artikel hanteert dezelfde meetmethoden als onze Voice AI Benchmark oktober 2026 en splitst de resultaten uit per taal. Je krijgt de cijfers per taal, de beperkingen van de steekproef en een plan voor je eigen Duitse acceptatietest.
Termen en testopzet
Elk cijfer hieronder heeft een nauwkeurige definitie en duidelijke grenzen.
Bevestigingstijd
We meten de tijd vanaf het einde van de uiting van de beller tot de eerste hoorbare audio van de agent nadat de ontvangstbevestiging van de testtool is binnengekomen. Netwerk, tool-aanroep en het vervolg van het antwoord zijn allemaal inbegrepen. Het is een proxy voor "de beller hoort de bevestiging", niet een tijdstempel van het eerste betekenisvolle woord.
Woordfoutpercentage (WER)
Het woordfoutpercentage telt alle substituties, verwijderingen en toevoegingen en deelt deze door het aantal referentiewoorden. We gebruiken micro-WER over het gehele corpus. Het Duitse corpus bevat 161 referentiewoorden, het Engelse 124. Een enkele fout verschuift het Duitse resultaat daarom met 0,62 procentpunt en het Engelse met 0,81. Zie voor de basis onze woordenlijst over speech-to-text.
Tijd tot stilte
Voor de onderbrekingstest praat de beller door een lang, lopend antwoord heen. We meten vanaf het begin van de onderbreking tot het eerste stille audioframe van de agent. Of de agent daarna het juiste, korte antwoord geeft, wordt apart gecontroleerd.
Hoe de test verliep
Alle gesprekken verliepen via echte WebRTC-rooms in productie, met een worker in de EU en LiveKit Agents 1.8.6. Er waren geen telefoongesprekken via het telefoonnetwerk en geen echte klantgegevens. Elke taal en configuratie kreeg vier fictieve taken: een vraag over retourneren, een afspraakbevestiging, een prijsvraag en een routerfout. Daarna volgde een onderbreking met herstel.
De pipeline-stacks gebruikten altijd hetzelfde taalmodel (Gemma 4 31B IT) en dezelfde spraakherkenning (Soniox STT v5). Alleen de voice-provider veranderde. Spraakherkenning had een eigen test met acht FLEURS-fragmenten per taal, in totaal 136,7 seconden aan voorgelezen spraak.
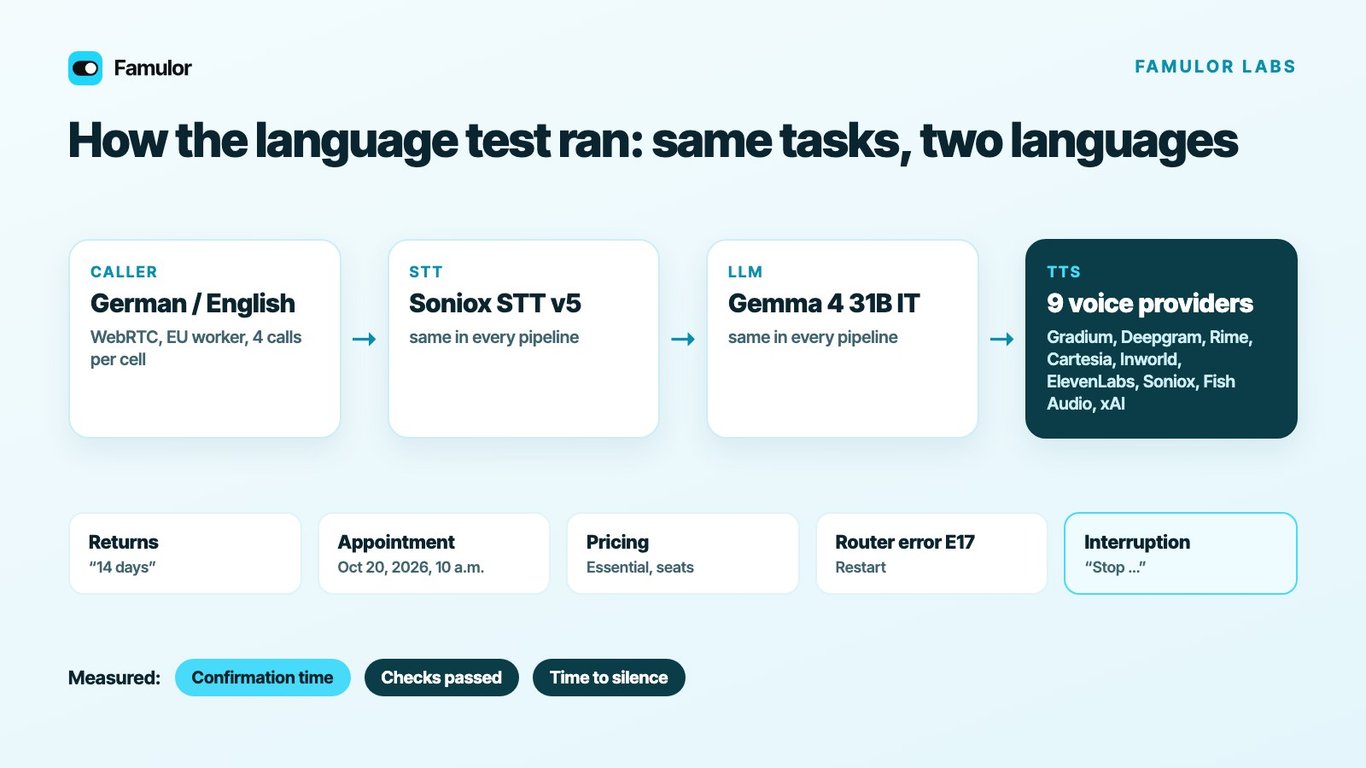
Testopzet: identieke taken in beide talen, alleen de stem verandert per pipeline.
Latentie: kost Duits tijd?
Nee, althans niet in deze steekproef. Over alle negen pipeline-stacks heen was de mediane bevestigingstijd 1249 ms in het Duits en 1308 ms in het Engels. Zeven stacks waren sneller in het Duits, twee marginaal trager.
Rime had het grootste verschil: 1232 ms in het Duits versus 1469 ms in het Engels. Bij ElevenLabs (plus 10 ms) en xAI (plus 27 ms) was het Duits marginaal trager. Met vier gesprekken vallen dergelijke verschillen binnen de marge van toeval. De volledige waarden, inclusief het traagste gesprek:
| Voice-provider | DE P50 ms | EN P50 ms | Verschil ms | DE P95 ms | EN P95 ms |
|---|---|---|---|---|---|
| Gradium | 1128 | 1209 | −81 | 1205 | 1272 |
| Deepgram | 1178 | 1308 | −130 | 1201 | 1425 |
| Rime | 1232 | 1469 | −237 | 1430 | 1499 |
| Cartesia | 1239 | 1292 | −53 | 1319 | 1371 |
| Inworld | 1249 | 1269 | −20 | 1318 | 1392 |
| ElevenLabs | 1257 | 1247 | +10 | 1318 | 1326 |
| Soniox | 1400 | 1487 | −87 | 1478 | 1616 |
| Fish Audio | 1481 | 1539 | −58 | 1590 | 1610 |
| xAI | 1582 | 1555 | +27 | 3054 | 1664 |
Eén uitschieter: het traagste Duitse gesprek met xAI duurde 3054 ms. Eén enkel gesprek, geen patroon, en precies wat meer testgesprekken zouden opvangen. Alle negen stacks doorstonden alle vier de taken in beide talen.
Voor je planning betekent dit: je hebt geen extra latentiebuffer nodig voor het Duits. Plan je budget zoals je dat voor het Engels zou doen en meet daarna met je eigen zinnen.
Native spraakmodellen: een ander beeld
Native audiomodellen verwerken spraak zonder een aparte stap voor spraakherkenning. Voor hen zag de taalvergelijking er anders uit. De half-cascade-varianten van GPT Realtime 2 en 2.1 doorstonden alle vier de taken in het Duits en drie van de vier in het Engels.
| Configuratie | DE controles | DE P50 ms | EN controles | EN P50 ms |
|---|---|---|---|---|
| Half-Cascade GPT Realtime 2 | 4/4 | 1940 | 3/4 | 2444 |
| Half-Cascade GPT Realtime 2.1 | 4/4 | 1780 | 3/4 | 1990 |
| Half-Cascade GPT Realtime 2.1 Mini | 3/4 | 2260 | 3/4 | 1899 |
| Realtime GPT Realtime 2 | 3/4 | 2954 | 3/4 | 2476 |
| Realtime GPT Realtime 2.1 | 4/4 | 2658 | 4/4 | 2616 |
| Realtime GPT Realtime 2.1 Mini | 3/4 | 2157 | 3/4 | 3026 |
Samen doorstonden de zes native configuraties 21 van de 24 controles in het Duits en 19 van de 24 in het Engels. De mediaan lag in beide talen ruwweg tussen de 1,8 en 3 seconden, ruim boven de pipeline-stacks. De Mini-varianten hadden in beide talen lange uitschieters: 9358 ms in het Duits en 12913 ms in het Engels voor Realtime 2.1 Mini.
De Gemini Live-varianten en GPT Realtime Mini voltooiden het testprotocol in deze run in geen van beide talen. We hebben GPT Live 1 niet beoordeeld omdat de transcripties onvolledig waren. Beide zijn daarom weggelaten uit de taalvergelijking.
Spraakherkenning: wie begrijpt Duits het best?
Hier komt het belangrijkste verschil voor Duitse gesprekken naar voren. Het model dat leidt in het Engels is niet automatisch het beste voor het Duits. De vergelijking toont elk model dat het volledige corpus in beide talen heeft voltooid.
Drie observaties vallen op. ElevenLabs Scribe v2 Realtime leidde in het Duits (0,62%, één enkele fout) en stond op de vijfde plaats in het Engels. Google Gemini 3.5 Transcribe Live bereikte 1,24% in het Duits en 7,26% in het Engels. De AssemblyAI U3-familie bleef in beide talen bij de drie beste waarden.
Dat de Duitse waarden bijna overal lager zijn, betekent niet dat Duits makkelijker te herkennen is. De fragmenten verschillen, het Duitse corpus heeft alleen mannelijke sprekers en een enkele fout is 0,62 procentpunt waard. Lees het resultaat als een ranglijst binnen één taal, niet als een vergelijking tussen talen.
| STT-model | Duitse WER | Engelse WER | Status |
|---|---|---|---|
| ElevenLabs Scribe v2 Realtime | 0.62% | 3.23% | beide compleet |
| Google Gemini 3.5 Transcribe Live | 1.24% | 7.26% | beide compleet |
| AssemblyAI U3 RT Pro | 1.86% | 2.42% | beide compleet |
| AssemblyAI Universal 3.5 Pro | 1.86% | 2.42% | beide compleet |
| AssemblyAI Universal 3.6 Pro | 1.86% | 2.42% | beide compleet |
| Speechmatics Linden-1 | 2.48% | 8.06% | beide compleet |
| Soniox STT v5 | 3.73% | 8.06% | beide compleet |
| xAI STT 1 | 3.73% | niet beoordeeld | EN slechts 6 van 8 fragmenten |
| xAI STT 2 | 3.73% | niet beoordeeld | EN slechts 6 van 8 fragmenten |
| Deepgram Nova-3 | 4.35% | 11.29% | beide compleet |
| Deepgram Flux General Multi | 6.21% | 9.68% | beide compleet |
| Deepgram Nova-2 | 7.45% | 16.13% | beide compleet |
| Cartesia Ink Whisper | 8.07% | niet beoordeeld | EN slechts 6 van 8 fragmenten |
| Gladia Solaria-1 | niet beoordeeld | niet beoordeeld | stream vroegtijdig gesloten |
| AssemblyAI Universal Streaming Multilingual | niet beoordeeld | niet beoordeeld | dubbele eindresultaten |
Onvolledige runs tellen nooit als nul fouten. Ze worden apart vermeld.
Deze modellen begrijpen alleen Engels
Acht van de 23 STT-modellen in de catalogus zijn uitsluitend Engelstalig. Voor een Duitstalige of tweetalige agent vallen deze af, ongeacht hoe goed ze presteren in het Engels:
- Cartesia Ink-2 (2,42% in het Engels, sterk, maar geen Duits)
- Deepgram Flux General EN (6,45%)
- Deepgram Nova-3 Pharma (12,90%)
- Deepgram Nova-2 Conversational AI (13,71%)
- Deepgram Nova-2 Medical, Nova-2 Phonecall en Nova-3 Medical (elk 14,52%)
- AssemblyAI Universal Streaming (niet beoordeeld, dubbele eindresultaten)
28 van de 29 stemmodellen werkten in de test ook in het Duits; alleen Deepgram Flux TTS werkte uitsluitend in het Engels. We hebben alle 33 taalmodellen in beide talen getest. Hun taalvaardigheid kan echter niet op basis van deze test worden vergeleken, omdat de taken per taal verschilden in moeilijkheidsgraad. Kijk op Duits bij Famulor om te zien welke talen Famulor ondersteunt.
Onderbrekingen: Duits heeft meer tijd nodig om stil te vallen
Dit was het duidelijkste taalverschil in de hele test. De beller vroeg om een gedetailleerde uitleg en onderbrak vervolgens met: "Stopp. Ich brauche nur den ersten Schritt, bitte ganz kurz." In het Engels was de zin: "Stop. I only need the first step, please keep it brief."
Gemiddeld viel de agent 1451 ms na een Duitse onderbreking stil en 848 ms na een Engelse. Deepgram vormde de uitzondering met 56 ms in het Duits. Belangrijk is dat de agent in alle 18 pipeline-cellen daarna de herstelcheck doorstond en kort de eerste stap benoemde. De onderbreking werkte dus wel, het duurde in het Duits alleen langer.
We kunnen de oorzaak niet vaststellen op basis van één onderbreking per cel. Aannemelijke factoren zijn de lengte van Duitse woorden, de herkenning van het eerste woord en het moment waarop de agent de input als een onderbreking behandelt. Wat voor jou in de praktijk telt: test onderbrekingen expliciet in het Duits. Een agent die in het Engels direct stopt, doet dat niet per se in het Duits.
Implementatie: zo test je jouw agent in het Duits
De bovenstaande cijfers zijn een startpunt. Bepaal je eigen koers met je eigen gesprekken:
- Stel de talen in. Bepaal of je agent alleen Duits, alleen Engels of beide spreekt. Bij twee talen vallen de acht Engelstalige spraakherkenningsmodellen af.
- Kies spraakherkenning op basis van het Duitse resultaat. Begin met een shortlist van ElevenLabs Scribe v2 Realtime, Gemini 3.5 Transcribe Live, de AssemblyAI U3-familie en Speechmatics Linden-1. Test deze vervolgens met je eigen telefoonopnames, inclusief dialecten en achtergrondruis.
- Kies een stem per taal. Gebruik een moedertaal-Duitse stem voor het Duits, niet de Engelse stem in de Duitse modus. In de stemmenbibliotheek kun je stemmen filteren op taal en ernaar luisteren.
- Vertaal testgevallen, kopieer ze niet zomaar. Duitse bellers zeggen datums anders: "am zwanzigsten Oktober um zehn Uhr". Voeg voluit geschreven getallen, umlauten in namen, samengestelde woorden en de formele of informele aanspreekvorm toe aan je tests.
- Test onderbrekingen in het Duits. Probeer "Stopp", "Moment mal" en "Nein, warte" midden in een lang antwoord. Meet wanneer de agent stilvalt en of hij daarna het juiste korte antwoord geeft.
- Meet en rapporteer per taal. Evalueer P50 en P95 afzonderlijk per taal. Een gemengd gemiddelde maskeert precies de verschillen die jouw bellers opmerken.
- Onderbouw het met meer gesprekken. Vier gesprekken geven een richting aan. Voor een release heb je veel meer gesprekken per taal nodig, verspreid over verschillende tijdstippen van de dag.
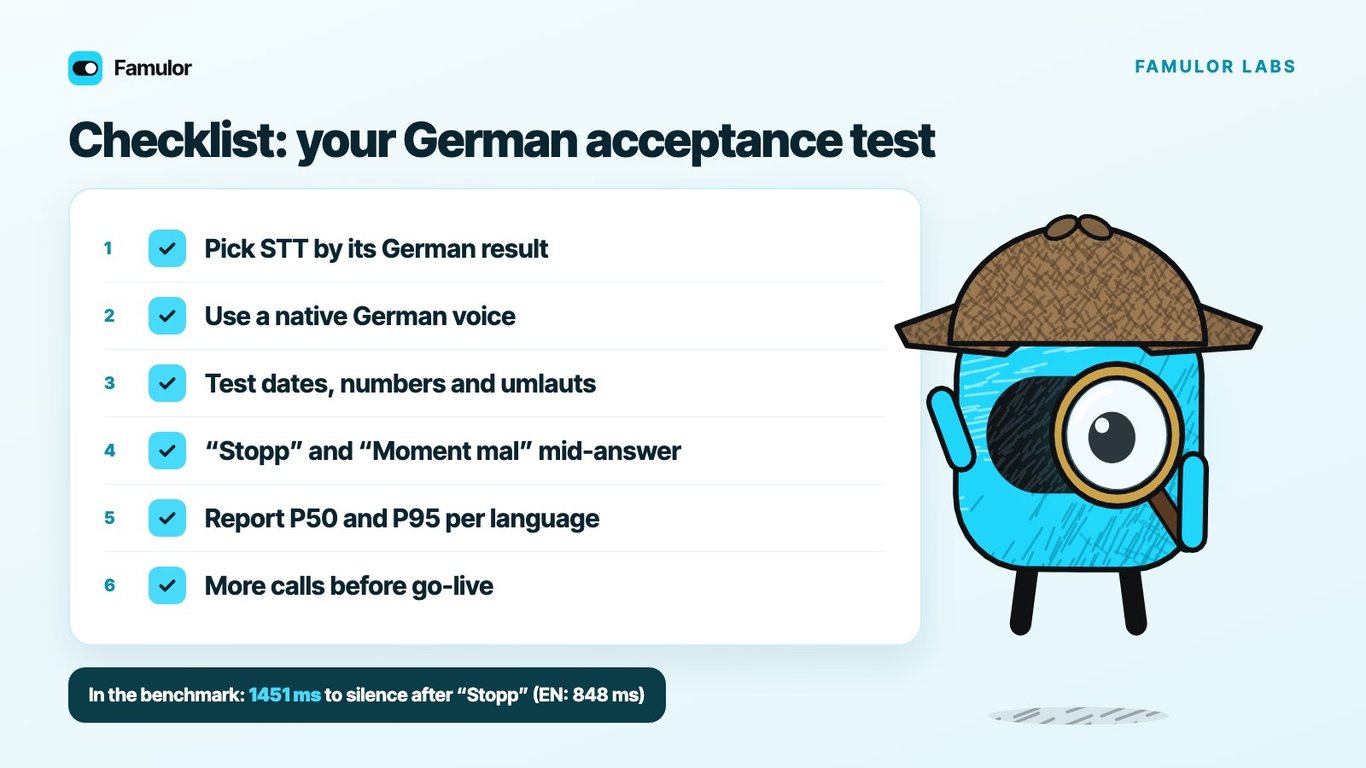
Checklist voor je Duitse acceptatietest.
Best practices en veelgemaakte fouten
Veelgemaakte fouten
- De Engelse ranglijst kopiëren. Cartesia Ink-2 behoort tot de beste modellen in het Engels, maar begrijpt geen Duits. Gemini 3.5 Transcribe Live stond zevende in het Engels en tweede in het Duits. Controleer de Duitse ranglijst apart.
- Een Engelstalig model in een tweetalige agent. Acht modellen begrijpen geen Duits. Een test vangt dat direct op, live verkeer pas bij de eerste Duitse beller.
- Een latency-buffer toevoegen voor het Duits in plaats van meten. In deze test was het Duits niet trager. Een standaardtoeslag kost je zonder reden gesprekskwaliteit.
- Getallen en datums niet testen. Voluit geschreven datums en prijzen zijn langer en foutgevoeliger in het Duits. Ze horen in elk testgeval thuis.
Best practices
- Onderhoud de uitspraak. Productnamen, straatnamen en technische termen hebben vaak hulp nodig. Onze gids voor een aangepast uitspraakwoordenboek laat zien hoe.
- Korte antwoorden. Korte zinnen maken onderbrekingen minder pijnlijk en verkorten de tijd tot het eerste antwoord.
- Aparte rapporten per taal. Zo zie je direct wanneer een modelupdate slechts één taal verslechtert.
- Test regelmatig opnieuw. Providers wijzigen modellen en routes. Een resultaat van oktober 2026 kan er in december anders uitzien.
Industrievoorbeelden
Tandartspraktijk in München
Een patiënt belt en bevestigt "Dinsdag de twintigste om twee uur 's middags". De agent moet datum en tijd exact herkennen en de afspraak bevestigen zonder dubbele boeking. In de benchmark doorstond elke pipeline-stack de afspraakbevestiging in het Duits. Voor de praktijk is het herkennen van namen met umlauten ook belangrijk, dus "Müller" of "Größer" horen in de test.
Onlineshop met klanten in Duitsland en het VK
Klanten vragen naar de retourtermijn, in het Duits of Engels. Een tweetalige agent met spraakherkenning die beide talen aankan, loont hier. Het antwoord "14 dagen" kwam voor elke pipeline-stack in beide talen correct naar voren. Wat telt is een stem die in beide talen natuurlijk klinkt.
IT-dienstverlener met een hotline
Een klant meldt routerfout E17 en de agent start een lange walkthrough. Na twee zinnen zegt de klant "Stop, alleen de eerste stap". De benchmark testte precies dit scenario. Plan hier korte antwoordstappen zodat een Duitse onderbreking snel effect heeft.
Bereken je ROI met geautomatiseerde gesprekken
Ontdek hoeveel je per maand bespaart via AI voice agents.
ROI Resultaat
ROI 0%
Geen creditcard nodig
Conclusie
Duits is geen rem op voice-AI. In onze benchmark waren de pipeline-stacks in het Duits net zo betrouwbaar en gemiddeld zelfs iets sneller dan in het Engels. De beslissingen die er echt toe doen zijn spraakherkenning en onderbrekingen: kies een STT-model op basis van het Duitse resultaat, niet op basis van de Engelse ranglijst, en test onderbrekingen expliciet in het Duits.
Met Famulor kies je zelf spraakherkenning, taalmodel en stem per agent en kun je testgesprekken in beide talen direct vergelijken. Je vindt alle ondersteunde talen onder Talen. Volgende stap: boek een demo en hoor je agent in het Duits.
Probeer onze AI-assistent
Ervaar hoe natuurlijk onze AI-telefoonassistent klinkt.
Vul je gegevens in en ontvang binnen enkele seconden een oproep van onze AI-agent.
De agent is getraind om over Famulor-diensten te praten en afspraken te maken.
Demo AI-agent
Famulor medewerker
FAQ
Is voice-AI trager in het Duits dan in het Engels?
Niet in onze benchmark. Over negen pipeline-stacks was de mediane bevestigingstijd 1249 ms in het Duits en 1308 ms in het Engels, met vier gesprekken per taal en stack.
Welk STT-model herkent Duits het best?
In ons korte corpus leidde ElevenLabs Scribe v2 Realtime met een woordfoutpercentage van 0,62%, voor Gemini 3.5 Transcribe Live (1,24%) en de AssemblyAI U3-familie (1,86%). Test de shortlist met je eigen telefoonopnames.
Is Duits makkelijker te herkennen dan Engels?
Dat kan deze test niet zeggen. De clips verschillen, het Duitse corpus heeft alleen mannelijke sprekers en één fout is 0,62 procentpunt waard. Vergelijk modellen alleen binnen één taal.
Ondersteunen alle modellen Duits?
Nee. 15 van de 23 STT-modellen en 28 van de 29 stemmodellen werkten in het Duits. Alle 33 taalmodellen zijn in beide talen getest. Acht STT-modellen begrijpen alleen Engels.
Hoe test ik onderbrekingen in het Duits?
Onderbreek de agent midden in een lang antwoord met "Stopp" of "Moment mal". Meet de tijd tot de stilte en controleer of het volgende antwoord kort en correct is. In de benchmark duurde dit gemiddeld 1451 ms in het Duits.
Zijn native spraakmodellen de betere keuze voor het Duits?
Niet automatisch voor korte servicetaken. Native configuraties hadden medianen van ongeveer 1,8 tot 3 seconden, pipelines ongeveer 1,1 tot 1,6 seconden. De half-cascade varianten van GPT Realtime 2 en 2.1 doorstonden echter wel alle vier de taken in het Duits.
Hoe actueel zijn deze resultaten?
We hebben gemeten op 13 oktober 2026. Providers wijzigen voortdurend modellen en routes. Gebruik de cijfers als startpunt en test opnieuw voordat je live gaat.
Kan ik de test met Famulor nabootsen?
Ja. In Famulor kies je per agent spraakherkenning, taalmodel en stem, voer je testgesprekken in het Duits en Engels uit en vergelijk je de gesprekken in de gesprekshistorie.
Bronnen en methode
Alle cijfers zijn afkomstig uit de Famulor Labs-benchmark van 13 oktober 2026: 44 taal- en configuratiecellen in productie-WebRTC-rooms, LiveKit Agents 1.8.6, EU-worker, plus 304 menselijke spraakverzoeken aan STT-modellen. Het spraakcorpus is afkomstig uit de FLEURS-dataset (CC BY 4.0). De volledige tabellen voor alle modellen vind je in de Voice AI Benchmark oktober 2026.
Auteur bij Famulor