Resumir contenido con:



IA de voz en alemán frente a inglés: lo que revela nuestro benchmark
Respuesta corta: el alemán no hace que tu agente de voz sea más lento. En nuestro benchmark del 13 de octubre de 2026, las nueve arquitecturas de canalización superaron las cuatro tareas de prueba tanto en alemán como en inglés. Siete de las nueve incluso confirmaron resultados ligeramente más rápidos en alemán.
Las diferencias reales residen en otros aspectos. Solo 15 de los 23 modelos de reconocimiento de voz entienden alemán. La clasificación de los mejores modelos cambia según el idioma. Y, tras una interrupción en alemán, el agente tardó más en quedar en silencio que tras una en inglés. Este artículo toma las mismas mediciones que nuestro Voice AI Benchmark de octubre de 2026 y las desglosa por idioma. Obtendrás las cifras por idioma, los límites de la muestra y un plan para realizar tu propia prueba de aceptación en alemán.
Términos y configuración de la prueba
Cada cifra a continuación tiene una definición precisa y límites claros.
Tiempo de confirmación
Medimos el tiempo desde el final de la expresión del interlocutor hasta el primer audio audible del agente una vez que se ha recibido la confirmación de la herramienta de prueba. La red, la llamada a la herramienta y la respuesta continua están incluidas. Es un indicador de "el interlocutor escucha la confirmación", no una marca de tiempo de la primera palabra significativa.
Tasa de error de palabras (WER)
La tasa de error de palabras cuenta todas las sustituciones, eliminaciones e inserciones y las divide por el número de palabras de referencia. Utilizamos micro WER en todo el corpus. El corpus en alemán tiene 161 palabras de referencia, el inglés 124. Por tanto, un solo error desplaza el resultado en alemán en 0,62 puntos porcentuales y el inglés en 0,81. Para conocer los conceptos básicos, consulta nuestra entrada del glosario sobre speech-to-text.
Tiempo hasta el silencio
Para la prueba de interrupción, el interlocutor habla durante una respuesta larga y en curso. Medimos desde el inicio de la interrupción hasta el primer fotograma de audio silencioso del agente. Si el agente da después la respuesta correcta y breve, se comprueba por separado.
Cómo se realizó la prueba
Todas las llamadas se ejecutaron a través de salas WebRTC reales en producción, con un trabajador en la UE y LiveKit Agents 1.8.6. No hubo llamadas a través de redes telefónicas ni datos reales de clientes. Cada idioma y configuración recibió cuatro tareas ficticias: una pregunta sobre devoluciones, una confirmación de cita, una pregunta sobre precios y un error de router. A continuación, se produjo una interrupción con recuperación.
Las arquitecturas de canalización utilizaron siempre el mismo modelo de lenguaje (Gemma 4 31B IT) y el mismo reconocimiento de voz (Soniox STT v5). Solo cambió el proveedor de voz. El reconocimiento de voz tuvo su propia prueba con ocho clips FLEURS por idioma, un total de 136,7 segundos de voz leída.
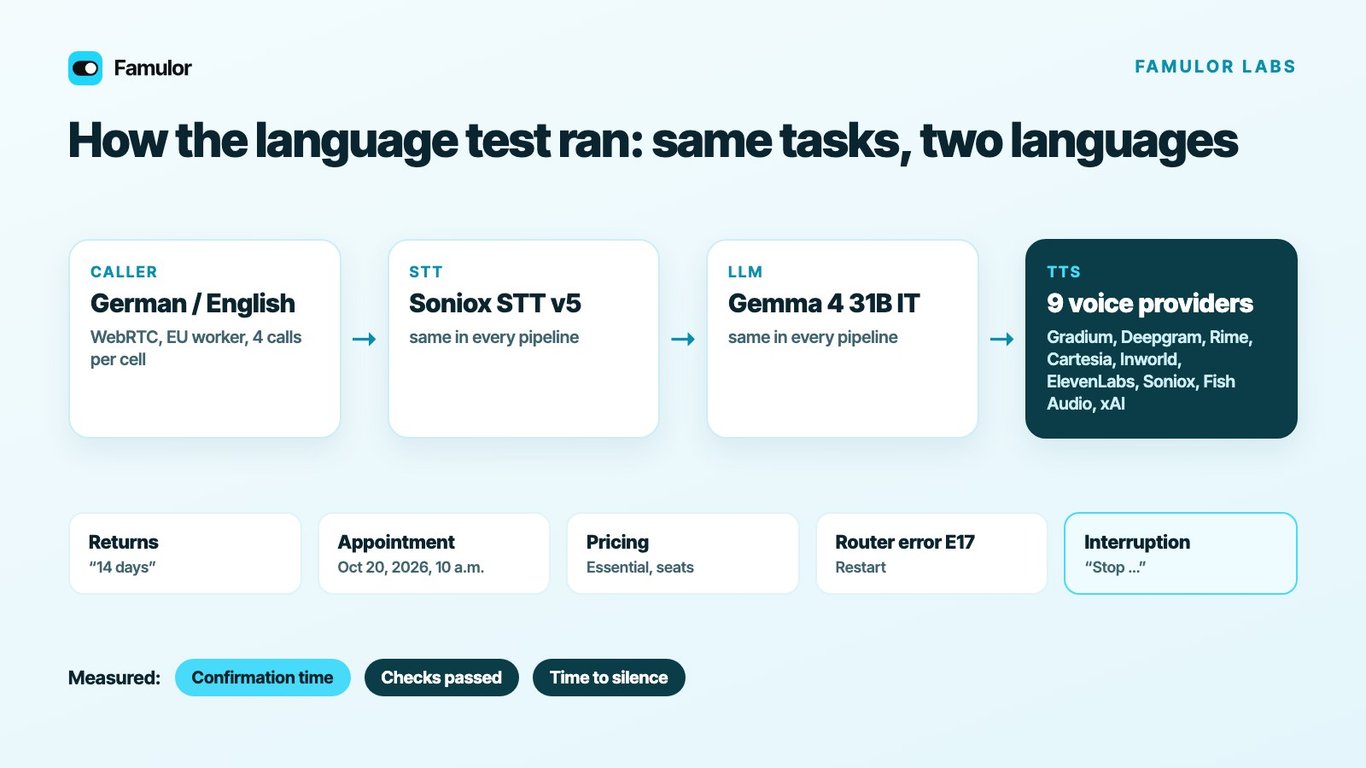
Configuración de la prueba: tareas idénticas en ambos idiomas, solo cambia la voz por canalización.
Latencia: ¿cuesta tiempo el alemán?
No, al menos no en esta muestra. En las nueve arquitecturas de canalización, el tiempo medio de confirmación fue de 1249 ms en alemán y 1308 ms en inglés. Siete arquitecturas fueron más rápidas en alemán, dos ligeramente más lentas.
Rime tuvo la mayor diferencia: 1232 ms en alemán frente a 1469 ms en inglés. Con ElevenLabs (más 10 ms) y xAI (más 27 ms), el alemán fue ligeramente más lento. Con cuatro llamadas, diferencias como estas entran dentro de lo aleatorio. Los valores completos, incluida la llamada más lenta:
| Proveedor de voz | P50 DE ms | P50 EN ms | Diferencia ms | P95 DE ms | P95 EN ms |
|---|---|---|---|---|---|
| Gradium | 1128 | 1209 | −81 | 1205 | 1272 |
| Deepgram | 1178 | 1308 | −130 | 1201 | 1425 |
| Rime | 1232 | 1469 | −237 | 1430 | 1499 |
| Cartesia | 1239 | 1292 | −53 | 1319 | 1371 |
| Inworld | 1249 | 1269 | −20 | 1318 | 1392 |
| ElevenLabs | 1257 | 1247 | +10 | 1318 | 1326 |
| Soniox | 1400 | 1487 | −87 | 1478 | 1616 |
| Fish Audio | 1481 | 1539 | −58 | 1590 | 1610 |
| xAI | 1582 | 1555 | +27 | 3054 | 1664 |
Un valor atípico: la llamada en alemán más lenta con xAI tardó 3054 ms. Una sola llamada, no un patrón, y exactamente lo que detectan más llamadas de prueba. Las nueve arquitecturas superaron las cuatro tareas en ambos idiomas.
Para tu planificación, esto significa: no necesitas un búfer de latencia adicional para el alemán. Planifica tu presupuesto como lo harías para el inglés y luego mide con tus propias frases.
Modelos de voz nativos: un panorama diferente
Los modelos de audio nativos procesan la voz sin un paso de reconocimiento de voz independiente. Para ellos, la comparación de idiomas fue diferente. Las variantes de media cascada de GPT Realtime 2 y 2.1 superaron las cuatro tareas en alemán y tres de cuatro en inglés.
| Configuración | Comprobaciones DE | P50 DE ms | Comprobaciones EN | P50 EN ms |
|---|---|---|---|---|
| Media cascada GPT Realtime 2 | 4/4 | 1940 | 3/4 | 2444 |
| Media cascada GPT Realtime 2.1 | 4/4 | 1780 | 3/4 | 1990 |
| Media cascada GPT Realtime 2.1 Mini | 3/4 | 2260 | 3/4 | 1899 |
| Realtime GPT Realtime 2 | 3/4 | 2954 | 3/4 | 2476 |
| Realtime GPT Realtime 2.1 | 4/4 | 2658 | 4/4 | 2616 |
| Realtime GPT Realtime 2.1 Mini | 3/4 | 2157 | 3/4 | 3026 |
En conjunto, las seis configuraciones nativas superaron 21 de 24 comprobaciones en alemán y 19 de 24 en inglés. La mediana se situó aproximadamente entre 1,8 y 3 segundos en ambos idiomas, muy por encima de las arquitecturas de canalización. Las variantes Mini tuvieron valores atípicos largos en ambos idiomas: 9358 ms en alemán y 12913 ms en inglés para Realtime 2.1 Mini.
Las variantes Gemini Live y GPT Realtime Mini no completaron el protocolo de prueba en ninguno de los dos idiomas en esta ejecución. No calificamos GPT Live 1 porque sus transcripciones estaban incompletas. Por tanto, ambos quedan fuera de la comparación de idiomas.
Reconocimiento de voz: ¿quién entiende mejor el alemán?
Aquí es donde aparece la diferencia más importante para las llamadas en alemán. El modelo que lidera en inglés no es automáticamente el mejor para el alemán. La comparación muestra todos los modelos que completaron el corpus completo en ambos idiomas.
Destacan tres observaciones. ElevenLabs Scribe v2 Realtime lideró en alemán (0,62%, un solo error) y ocupó el quinto lugar en inglés. Google Gemini 3.5 Transcribe Live alcanzó el 1,24% en alemán y el 7,26% en inglés. La familia AssemblyAI U3 se mantuvo entre los tres mejores valores en ambos idiomas.
Que los valores en alemán sean más bajos en casi todas partes no significa que el alemán sea más fácil de reconocer. Los clips son diferentes, el corpus en alemán tiene solo hablantes masculinos y un solo error equivale a 0,62 puntos porcentuales. Lee el resultado como una clasificación dentro de un idioma, no como una comparación entre idiomas.
| Modelo STT | WER alemán | WER inglés | Estado |
|---|---|---|---|
| ElevenLabs Scribe v2 Realtime | 0.62% | 3.23% | ambos completos |
| Google Gemini 3.5 Transcribe Live | 1.24% | 7.26% | ambos completos |
| AssemblyAI U3 RT Pro | 1.86% | 2.42% | ambos completos |
| AssemblyAI Universal 3.5 Pro | 1.86% | 2.42% | ambos completos |
| AssemblyAI Universal 3.6 Pro | 1.86% | 2.42% | ambos completos |
| Speechmatics Linden-1 | 2.48% | 8.06% | ambos completos |
| Soniox STT v5 | 3.73% | 8.06% | ambos completos |
| xAI STT 1 | 3.73% | no calificado | Solo EN 6 de 8 clips |
| xAI STT 2 | 3.73% | no calificado | Solo EN 6 de 8 clips |
| Deepgram Nova-3 | 4.35% | 11.29% | ambos completos |
| Deepgram Flux General Multi | 6.21% | 9.68% | ambos completos |
| Deepgram Nova-2 | 7.45% | 16.13% | ambos completos |
| Cartesia Ink Whisper | 8.07% | no calificado | Solo EN 6 de 8 clips |
| Gladia Solaria-1 | no calificado | no calificado | flujo cerrado prematuramente |
| AssemblyAI Universal Streaming Multilingual | no calificado | no calificado | resultados finales duplicados |
Las ejecuciones incompletas nunca cuentan como cero errores. Se enumeran por separado.
Estos modelos solo entienden inglés
Ocho de los 23 modelos STT del catálogo son exclusivamente para inglés. Para un agente que hable alemán o sea bilingüe, quedan descartados, independientemente de su rendimiento en inglés:
- Cartesia Ink-2 (2,42% en inglés, potente, pero sin alemán)
- Deepgram Flux General EN (6,45%)
- Deepgram Nova-3 Pharma (12,90%)
- Deepgram Nova-2 Conversational AI (13,71%)
- Deepgram Nova-2 Medical, Nova-2 Phonecall y Nova-3 Medical (14,52% cada uno)
- AssemblyAI Universal Streaming (no evaluado, resultados finales duplicados)
28 de los 29 modelos de voz también funcionaron en alemán en la prueba; solo Deepgram Flux TTS funcionó únicamente en inglés. Probamos los 33 modelos de lenguaje en ambos idiomas. Sin embargo, su calidad lingüística no puede compararse a partir de esta prueba, ya que la dificultad de las tareas variaba según el idioma. Para ver qué idiomas cubre Famulor, visita Alemán en Famulor.
Interrupciones: el alemán tarda más en silenciarse
Esta fue la diferencia lingüística más clara de toda la prueba. El interlocutor pidió una explicación detallada y luego interrumpió diciendo: "Stopp. Ich brauche nur den ersten Schritt, bitte ganz kurz". En inglés, la frase fue: "Stop. I only need the first step, please keep it brief".
Como mediana, el agente guardó silencio 1451 ms después de una interrupción en alemán y 848 ms después de una en inglés. Deepgram fue la excepción con 56 ms en alemán. Es importante destacar que, en las 18 celdas de pipeline, el agente superó la prueba de recuperación y nombró brevemente el primer paso. Por tanto, la interrupción funcionó, solo que tardó más en alemán.
No podemos determinar la causa con una sola interrupción por celda. Factores plausibles son la longitud de las palabras en alemán, el reconocimiento de la primera palabra y el momento en que el agente procesa la entrada como una interrupción. Lo que te importa en la práctica es: prueba las interrupciones en alemán explícitamente. Un agente que se detiene al instante en inglés no tiene por qué hacerlo en alemán.
Implementación: cómo probar tu agente en alemán
Las cifras anteriores son un punto de partida. Decide basándote en tus propias llamadas:
- Configura los idiomas. Decide si tu agente hablará solo alemán, solo inglés o ambos. Con dos idiomas, los ocho modelos de reconocimiento de voz exclusivos para inglés quedan descartados.
- Elige el reconocimiento de voz según su resultado en alemán. Empieza con una lista corta de ElevenLabs Scribe v2 Realtime, Gemini 3.5 Transcribe Live, la familia AssemblyAI U3 y Speechmatics Linden-1. Luego pruébalos con tus propias grabaciones telefónicas, incluyendo dialectos y ruido de fondo.
- Elige una voz por idioma. Usa una voz nativa alemana para el alemán, no la voz inglesa en modo alemán. En la biblioteca de voces puedes filtrar las voces por idioma y escucharlas.
- Traduce los casos de prueba, no te limites a copiarlos. Los interlocutores alemanes dicen las fechas de forma distinta: "am zwanzigsten Oktober um zehn Uhr". Añade números escritos, diéresis en los nombres, palabras compuestas y la forma de tratamiento formal o informal a tus pruebas.
- Prueba las interrupciones en alemán. Prueba con "Stopp", "Moment mal" y "Nein, warte" en medio de una respuesta larga. Mide cuándo se silencia el agente y si luego da la respuesta corta correcta.
- Mide e informa por idioma. Evalúa P50 y P95 por separado para cada idioma. Un promedio mixto oculta precisamente las diferencias que notan tus interlocutores.
- Refuérzalo con más llamadas. Cuatro llamadas muestran una tendencia. Para un lanzamiento necesitas muchas más llamadas por idioma, distribuidas en diferentes momentos del día.
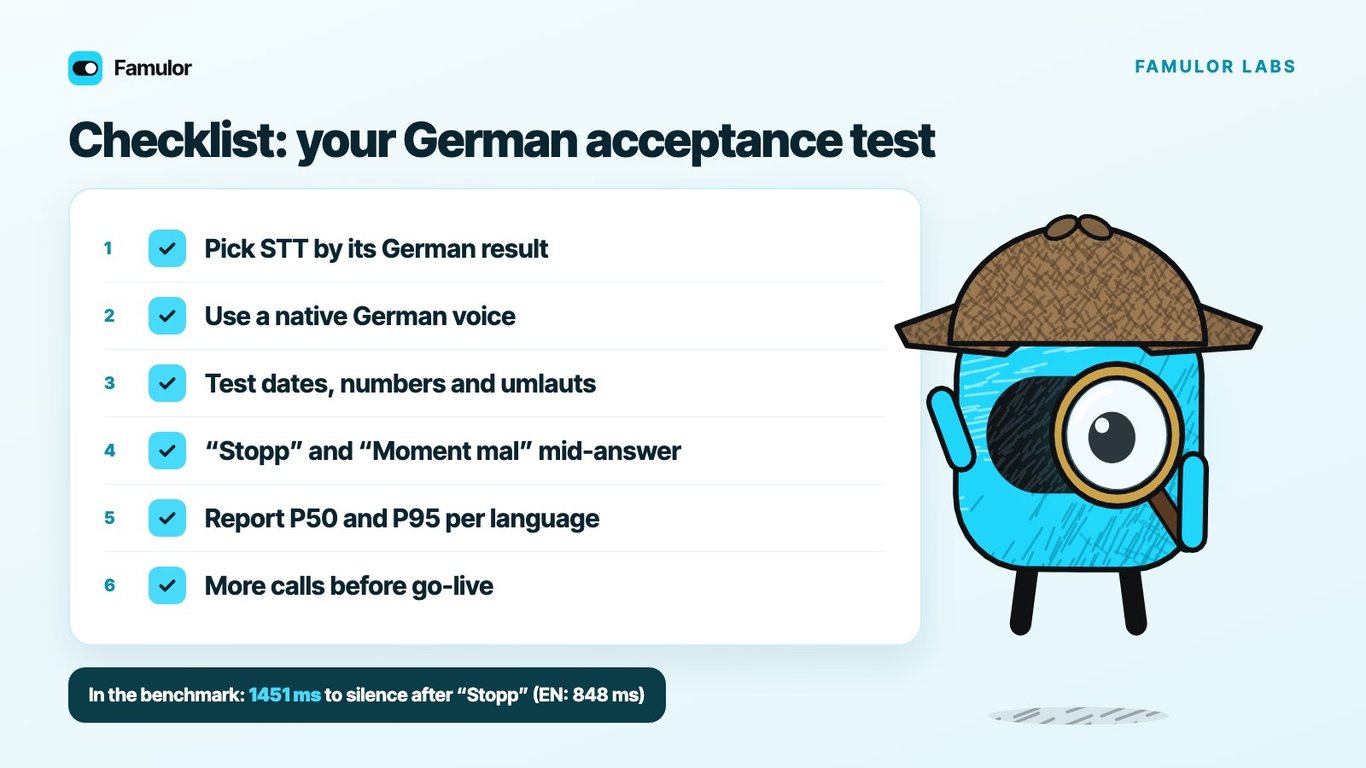
Lista de verificación para tu prueba de aceptación en alemán.
Mejores prácticas y errores comunes
Errores comunes
- Copiar el ranking en inglés. Cartesia Ink-2 es uno de los mejores modelos en inglés, pero no entiende alemán. Gemini 3.5 Transcribe Live ocupó el séptimo lugar en inglés y el segundo en alemán. Comprueba el ranking alemán por separado.
- Un modelo exclusivo para inglés en un agente bilingüe. Ocho modelos no entienden alemán. Una prueba lo detecta de inmediato; en el tráfico real, solo te darás cuenta con el primer interlocutor alemán.
- Añadir un búfer de latencia para el alemán en lugar de medirlo. En esta prueba, el alemán no fue más lento. Un recargo fijo te cuesta calidad de conversación sin motivo.
- No probar números y fechas. Las fechas y precios escritos son más largos y propensos a errores en alemán. Deben incluirse en cada caso de prueba.
Mejores prácticas
- Mantén la pronunciación. Los nombres de productos, calles y términos técnicos a menudo necesitan ayuda. Nuestra guía sobre un diccionario de pronunciación personalizado muestra cómo hacerlo.
- Respuestas cortas. Las frases cortas hacen que las interrupciones sean menos molestas y reducen el tiempo hasta la primera respuesta.
- Informes separados por idioma. De este modo, verás enseguida cuando una actualización del modelo empeora solo un idioma.
- Vuelve a probar regularmente. Los proveedores cambian los modelos y las rutas. Un resultado de octubre de 2026 puede ser distinto en diciembre.
Ejemplos de la industria
Consulta dental en Múnich
Un paciente llama y confirma: "Martes veinte a las dos de la tarde". El agente debe reconocer la fecha y la hora con exactitud y confirmar la cita sin duplicar la reserva. En el benchmark, cada stack de pipeline superó la confirmación de cita en alemán. Para la consulta, reconocer nombres con diéresis también es importante, así que "Müller" o "Größer" deben estar en la prueba.
Tienda online con clientes en Alemania y el Reino Unido
Los clientes preguntan por el plazo de devolución, en alemán o inglés. Un agente bilingüe con reconocimiento de voz que maneje ambos idiomas compensa aquí. La respuesta "14 días" salió correctamente para cada stack de pipeline en ambos idiomas. Lo que importa es una voz que suene natural en ambos.
Proveedor de servicios informáticos con línea de atención al cliente
Un cliente informa de un error E17 en el router y el agente comienza una larga explicación paso a paso. Tras dos frases, el cliente dice: "Stop, solo el primer paso". El benchmark probó exactamente este escenario. Planifica pasos de respuesta cortos aquí para que una interrupción en alemán surta efecto rápidamente.
Calcula tu ROI automatizando llamadas
Descubre cuánto podrías ahorrar al usar voice agents con IA.
Resultado ROI
ROI 0%
Sin tarjeta de crédito
Conclusión
El alemán no es un freno para la IA de voz. En nuestro benchmark, los stacks de pipeline fueron igual de fiables en alemán y, como mediana, incluso ligeramente más rápidos que en inglés. Las decisiones que realmente cuentan son el reconocimiento de voz y las interrupciones: elige un modelo STT por su resultado en alemán, no por el ranking en inglés, y prueba las interrupciones explícitamente en alemán.
Con Famulor eliges tú mismo el reconocimiento de voz, el modelo de lenguaje y la voz por agente, y puedes comparar llamadas de prueba en ambos idiomas directamente. Encontrarás todos los idiomas compatibles en Idiomas. Siguiente paso: reserva una demo y escucha a tu agente en alemán.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.
Agente IA de demo
Representante de Famulor
Preguntas frecuentes
¿Es la IA de voz más lenta en alemán que en inglés?
No en nuestro benchmark. En nueve stacks de pipeline, el tiempo medio de confirmación fue de 1249 ms en alemán y 1308 ms en inglés, con cuatro llamadas por idioma y stack.
¿Qué modelo STT reconoce mejor el alemán?
En nuestro corpus breve, ElevenLabs Scribe v2 Realtime lideró con una tasa de error de palabra del 0,62%, por delante de Gemini 3.5 Transcribe Live (1,24%) y la familia AssemblyAI U3 (1,86%). Prueba la lista corta con tus propias grabaciones telefónicas.
¿Es el alemán más fácil de reconocer que el inglés?
Esta prueba no puede determinarlo. Los clips difieren, el corpus alemán solo tiene hablantes masculinos y un error equivale a 0,62 puntos porcentuales. Compara modelos solo dentro de un mismo idioma.
¿Admiten todos los modelos el alemán?
No. 15 de los 23 modelos STT y 28 de los 29 modelos de voz funcionaron en alemán. Los 33 modelos de lenguaje se probaron en ambos idiomas. Ocho modelos STT solo entienden inglés.
¿Cómo pruebo las interrupciones en alemán?
Interrumpe al agente en medio de una respuesta larga con "Stopp" o "Moment mal". Mide el tiempo hasta el silencio y comprueba que la siguiente respuesta sea corta y correcta. En el benchmark, esto tomó una mediana de 1451 ms en alemán.
¿Son los modelos de voz nativos la mejor opción para el alemán?
No automáticamente para tareas de servicio breves. Las configuraciones nativas tuvieron medianas de entre 1,8 y 3 segundos, mientras que los pipelines estuvieron entre 1,1 y 1,6 segundos. Sin embargo, las variantes half-cascade de GPT Realtime 2 y 2.1 sí superaron las cuatro tareas en alemán.
¿Qué tan actuales son estos resultados?
Medimos el 13 de octubre de 2026. Los proveedores cambian los modelos y las rutas constantemente. Usa las cifras como punto de partida y vuelve a probar antes de salir a producción.
¿Puedo reconstruir la prueba con Famulor?
Sí. En Famulor eliges el reconocimiento de voz, el modelo de lenguaje y la voz por agente, ejecutas llamadas de prueba en alemán e inglés y comparas las conversaciones en el historial de llamadas.
Fuentes y método
Todas las cifras provienen del benchmark de Famulor Labs del 13 de octubre de 2026: 44 celdas de configuración y lenguaje en salas WebRTC de producción, LiveKit Agents 1.8.6, trabajador de la UE, más 304 solicitudes de voz humana a modelos STT. El corpus de voz proviene del conjunto de datos FLEURS (CC BY 4.0). Encontrarás las tablas completas de todos los modelos en el Voice AI Benchmark October 2026.
Autor en Famulor