Inhalt zusammenfassen mit:



Voice AI auf Deutsch vs. Englisch: Was der Benchmark zeigt
Kurze Antwort: Deutsch macht deinen Voice Agent nicht langsamer. In unserem Benchmark vom 13. Oktober 2026 haben alle neun Pipeline-Stacks die vier Testaufgaben auf Deutsch und auf Englisch bestanden. Sieben von neun haben auf Deutsch sogar etwas schneller bestätigt.
Die echten Unterschiede liegen woanders. Nur 15 von 23 Spracherkennungsmodellen verstehen Deutsch. Die Rangliste der besten Modelle ändert sich je Sprache. Und nach einer deutschen Unterbrechung wurde der Agent später still als nach einer englischen. Dieser Artikel wertet dieselben Messungen wie unser Voice-AI-Benchmark Oktober 2026 neu aus, diesmal getrennt nach Sprache. Du bekommst die Zahlen je Sprache, die Grenzen der Stichprobe und einen Plan für deinen eigenen Abnahmetest auf Deutsch.
Begriffe und Testaufbau
Jede Zahl unten hat eine genaue Definition und klare Grenzen.
Bestätigungszeit
Wir messen die Zeit vom Ende der Anruferäußerung bis zum ersten hörbaren Audio des Agents, nachdem die Quittung des Test-Tools eingegangen ist. Netzwerk, Tool-Aufruf und Fortsetzung der Antwort stecken darin. Das ist ein Näherungswert für „der Anrufer hört die Bestätigung", kein Zeitstempel des ersten sinnvollen Wortes.
Wortfehlerrate (WER)
Die Wortfehlerrate zählt alle Ersetzungen, Auslassungen und Einfügungen und teilt sie durch die Zahl der Referenzwörter. Wir nutzen die Micro-WER über den ganzen Korpus. Der deutsche Korpus hat 161 Referenzwörter, der englische 124. Ein einziger Fehler verschiebt das deutsche Ergebnis also um 0,62 Prozentpunkte und das englische um 0,81. Mehr zur Technik dahinter findest du im Glossar unter Speech-to-Text.
Zeit bis zur Stille
Für den Unterbrechungstest spricht der Anrufer in eine laufende, lange Antwort hinein. Wir messen vom Beginn der Unterbrechung bis zum ersten stillen Audioframe des Agents. Ob der Agent danach die richtige, kurze Antwort gibt, prüfen wir getrennt.
So lief der Test
Alle Anrufe liefen über echte WebRTC-Räume in der Produktion, mit einem Worker in der EU und LiveKit Agents 1.8.6. Es gab keine Telefonnetz-Anrufe und keine echten Kundendaten. Pro Sprache und Konfiguration gab es vier fiktive Aufgaben: eine Rückgabefrage, eine Terminbestätigung, eine Preisfrage und einen Routerfehler. Danach folgte eine Unterbrechung mit Wiederaufnahme.
Die Pipeline-Stacks nutzten immer dasselbe Sprachmodell (Gemma 4 31B IT) und dieselbe Spracherkennung (Soniox STT v5). Nur der Sprachanbieter für die Stimme wechselte. Für die Spracherkennung gab es einen eigenen Test mit acht FLEURS-Clips pro Sprache, zusammen 136,7 Sekunden vorgelesene Sprache.
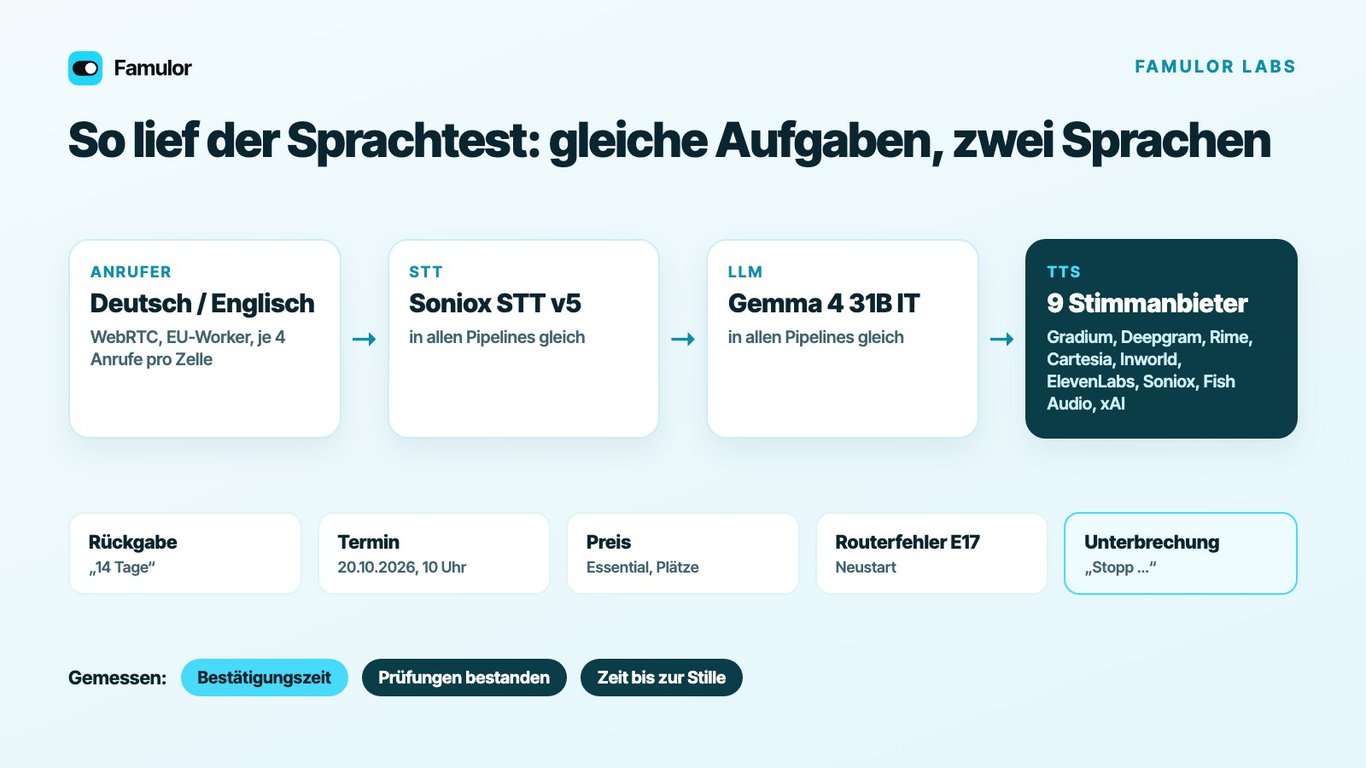
Testaufbau: identische Aufgaben in beiden Sprachen, nur die Stimme wechselt je Pipeline.
Latenz: Kostet Deutsch Zeit?
Nein, jedenfalls nicht in dieser Stichprobe. Über alle neun Pipeline-Stacks lag der Median der Bestätigungszeit auf Deutsch bei 1249 ms und auf Englisch bei 1308 ms. Sieben Stacks waren auf Deutsch schneller, zwei minimal langsamer.
Die größte Lücke hatte Rime: 1232 ms auf Deutsch gegenüber 1469 ms auf Englisch. Bei ElevenLabs (plus 10 ms) und xAI (plus 27 ms) war Deutsch minimal langsamer. Solche Abstände liegen bei vier Anrufen im Bereich des Zufalls. Die vollständigen Werte inklusive des langsamsten Anrufs:
| Stimmanbieter | DE P50 ms | EN P50 ms | Differenz ms | DE P95 ms | EN P95 ms |
|---|---|---|---|---|---|
| Gradium | 1128 | 1209 | −81 | 1205 | 1272 |
| Deepgram | 1178 | 1308 | −130 | 1201 | 1425 |
| Rime | 1232 | 1469 | −237 | 1430 | 1499 |
| Cartesia | 1239 | 1292 | −53 | 1319 | 1371 |
| Inworld | 1249 | 1269 | −20 | 1318 | 1392 |
| ElevenLabs | 1257 | 1247 | +10 | 1318 | 1326 |
| Soniox | 1400 | 1487 | −87 | 1478 | 1616 |
| Fish Audio | 1481 | 1539 | −58 | 1590 | 1610 |
| xAI | 1582 | 1555 | +27 | 3054 | 1664 |
Ein Ausreißer: Der langsamste deutsche Anruf mit xAI dauerte 3054 ms. Ein einzelner Anruf, kein Muster, und genau das fangen mehr Testanrufe ab. Alle neun Stacks haben alle vier Aufgaben in beiden Sprachen bestanden.
Für deine Planung heißt das: Du brauchst für Deutsch keinen eigenen Latenzpuffer. Plane dein Budget wie für Englisch und miss dann mit deinen eigenen Sätzen nach.
Native Sprachmodelle: ein anderes Bild
Native Audio-Modelle verarbeiten Sprache ohne getrennte Spracherkennung. Bei ihnen sah der Sprachvergleich anders aus. Die Half-Cascade-Varianten von GPT Realtime 2 und 2.1 bestanden auf Deutsch alle vier Aufgaben und auf Englisch drei von vier.
| Konfiguration | DE Prüfungen | DE P50 ms | EN Prüfungen | EN P50 ms |
|---|---|---|---|---|
| Half-Cascade GPT Realtime 2 | 4/4 | 1940 | 3/4 | 2444 |
| Half-Cascade GPT Realtime 2.1 | 4/4 | 1780 | 3/4 | 1990 |
| Half-Cascade GPT Realtime 2.1 Mini | 3/4 | 2260 | 3/4 | 1899 |
| Realtime GPT Realtime 2 | 3/4 | 2954 | 3/4 | 2476 |
| Realtime GPT Realtime 2.1 | 4/4 | 2658 | 4/4 | 2616 |
| Realtime GPT Realtime 2.1 Mini | 3/4 | 2157 | 3/4 | 3026 |
Zusammen kamen die sechs nativen Konfigurationen auf Deutsch auf 21 von 24 bestandenen Prüfungen und auf Englisch auf 19 von 24. Der Median lag in beiden Sprachen grob zwischen 1,8 und 3 Sekunden, also deutlich über den Pipeline-Stacks. Die Mini-Varianten hatten in beiden Sprachen lange Ausreißer: 9358 ms auf Deutsch und 12913 ms auf Englisch bei Realtime 2.1 Mini.
Die Gemini-Live-Varianten und GPT Realtime Mini haben das Testprotokoll in diesem Lauf in keiner Sprache abgeschlossen. GPT Live 1 haben wir nicht bewertet, weil die Transkripte unvollständig waren. Beide fehlen deshalb im Sprachvergleich.
Spracherkennung: Wer versteht Deutsch am besten?
Hier zeigt sich der wichtigste Unterschied für deutsche Anrufe. Das Modell, das auf Englisch vorne liegt, ist nicht automatisch das beste für Deutsch. Der Vergleich zeigt alle Modelle, die in beiden Sprachen den vollständigen Korpus geschafft haben.
Drei Beobachtungen stechen heraus. ElevenLabs Scribe v2 Realtime lag auf Deutsch vorne (0,62 %, also ein Fehler) und auf Englisch auf Platz fünf. Google Gemini 3.5 Transcribe Live kam auf Deutsch auf 1,24 %, auf Englisch auf 7,26 %. Die AssemblyAI-U3-Familie lag in beiden Sprachen stabil bei den drei besten Werten.
Dass die deutschen Werte fast überall niedriger sind, heißt nicht, dass Deutsch leichter zu erkennen ist. Die Clips sind verschieden, der deutsche Korpus hat nur männliche Sprecher, und ein einzelner Fehler macht 0,62 Prozentpunkte aus. Lies das Ergebnis als Rangfolge innerhalb einer Sprache, nicht als Vergleich zwischen den Sprachen.
| STT-Modell | Deutsch WER | Englisch WER | Status |
|---|---|---|---|
| ElevenLabs Scribe v2 Realtime | 0,62 % | 3,23 % | beide vollständig |
| Google Gemini 3.5 Transcribe Live | 1,24 % | 7,26 % | beide vollständig |
| AssemblyAI U3 RT Pro | 1,86 % | 2,42 % | beide vollständig |
| AssemblyAI Universal 3.5 Pro | 1,86 % | 2,42 % | beide vollständig |
| AssemblyAI Universal 3.6 Pro | 1,86 % | 2,42 % | beide vollständig |
| Speechmatics Linden-1 | 2,48 % | 8,06 % | beide vollständig |
| Soniox STT v5 | 3,73 % | 8,06 % | beide vollständig |
| xAI STT 1 | 3,73 % | nicht gewertet | EN nur 6 von 8 Clips |
| xAI STT 2 | 3,73 % | nicht gewertet | EN nur 6 von 8 Clips |
| Deepgram Nova-3 | 4,35 % | 11,29 % | beide vollständig |
| Deepgram Flux General Multi | 6,21 % | 9,68 % | beide vollständig |
| Deepgram Nova-2 | 7,45 % | 16,13 % | beide vollständig |
| Cartesia Ink Whisper | 8,07 % | nicht gewertet | EN nur 6 von 8 Clips |
| Gladia Solaria-1 | nicht gewertet | nicht gewertet | Stream abgebrochen |
| AssemblyAI Universal Streaming Multilingual | nicht gewertet | nicht gewertet | doppelte Endergebnisse |
Unvollständige Läufe zählen nie als null Fehler. Sie stehen getrennt in der Tabelle.
Diese Modelle verstehen nur Englisch
Acht der 23 STT-Modelle im Katalog sind reine Englisch-Modelle. Für einen deutschen oder zweisprachigen Agent fallen sie weg, egal wie gut sie auf Englisch abschneiden:
- Cartesia Ink-2 (2,42 % auf Englisch, stark, aber ohne Deutsch)
- Deepgram Flux General EN (6,45 %)
- Deepgram Nova-3 Pharma (12,90 %)
- Deepgram Nova-2 Conversational AI (13,71 %)
- Deepgram Nova-2 Medical, Nova-2 Phonecall und Nova-3 Medical (je 14,52 %)
- AssemblyAI Universal Streaming (nicht gewertet, doppelte Endergebnisse)
28 von 29 Stimmmodellen liefen im Test auch auf Deutsch, nur Deepgram Flux TTS ausschließlich auf Englisch. Alle 33 Sprachmodelle haben wir in beiden Sprachen getestet. Ihre Sprachqualität lässt sich aus diesem Test aber nicht vergleichen, weil die Aufgaben je Sprache unterschiedlich schwer waren. Welche Sprachen Famulor insgesamt abdeckt, siehst du auf der Seite Deutsch bei Famulor.
Unterbrechungen: Deutsch braucht länger bis zur Stille
Das war der deutlichste Sprachunterschied im ganzen Test. Der Anrufer bat um eine ausführliche Erklärung und unterbrach dann mit „Stopp. Ich brauche nur den ersten Schritt, bitte ganz kurz." Auf Englisch lautete der Satz „Stop. I only need the first step, please keep it brief."
Im Median wurde der Agent nach einer deutschen Unterbrechung nach 1451 ms still, nach einer englischen nach 848 ms. Deepgram war die Ausnahme mit 56 ms auf Deutsch. Wichtig: In allen 18 Pipeline-Zellen hat der Agent danach die Prüfung zur Wiederaufnahme bestanden und kurz den ersten Schritt genannt. Die Unterbrechung hat also funktioniert, sie hat auf Deutsch nur länger gedauert.
Woran das liegt, können wir aus einer Unterbrechung pro Zelle nicht ableiten. Plausible Faktoren sind die Länge der deutschen Wörter, die Erkennung des ersten Wortes und der Zeitpunkt, an dem der Agent den Einwurf als Unterbrechung wertet. Für dich zählt die Praxis: Teste das Unterbrechen auf Deutsch ausdrücklich. Ein Agent, der auf Englisch sofort verstummt, tut das auf Deutsch nicht zwingend.
Implementierung: So testest du deinen Agent auf Deutsch
Die Zahlen oben sind ein Startpunkt. Entscheiden solltest du mit deinen eigenen Anrufen. So gehst du vor:
- Sprachen festlegen. Lege fest, ob dein Agent nur Deutsch, nur Englisch oder beides sprechen soll. Bei zwei Sprachen scheiden die acht reinen Englisch-Modelle für die Spracherkennung aus.
- Spracherkennung nach dem deutschen Ergebnis wählen. Starte mit einer Shortlist aus ElevenLabs Scribe v2 Realtime, Gemini 3.5 Transcribe Live, der AssemblyAI-U3-Familie und Speechmatics Linden-1. Teste sie danach mit eigenen Telefonaufnahmen, inklusive Dialekt und Hintergrundgeräuschen.
- Stimme je Sprache wählen. Nimm für Deutsch eine muttersprachliche deutsche Stimme und nicht die englische Stimme im Deutsch-Modus. In der Stimmbibliothek kannst du Stimmen nach Sprache filtern und anhören.
- Testfälle übersetzen, nicht nur übertragen. Deutsche Anrufer sagen Daten anders: „am zwanzigsten Oktober um zehn Uhr". Nimm ausgeschriebene Zahlen, Umlaute in Namen, zusammengesetzte Wörter und die Anrede mit Sie oder du in deine Tests auf.
- Unterbrechungen auf Deutsch testen. Prüfe „Stopp", „Moment mal" und „Nein, warte" mitten in einer langen Antwort. Miss, wann der Agent still wird, und ob er danach die richtige kurze Antwort gibt.
- Je Sprache messen und berichten. Werte P50 und P95 getrennt nach Sprache aus. Ein gemischter Durchschnitt versteckt genau die Unterschiede, die deine Anrufer bemerken.
- Mit mehr Anrufen absichern. Vier Anrufe zeigen eine Richtung. Für eine Freigabe brauchst du deutlich mehr Anrufe pro Sprache, verteilt über verschiedene Tageszeiten.
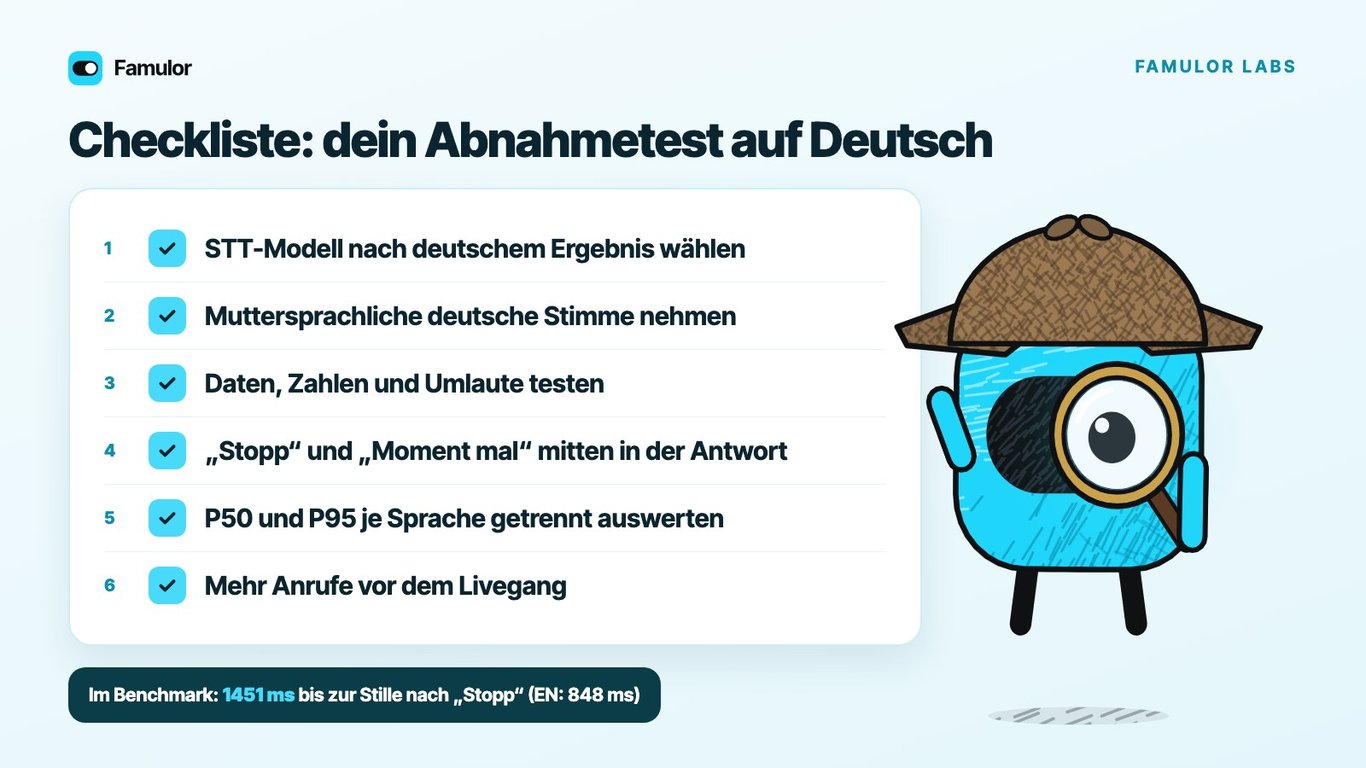
Checkliste für deinen Abnahmetest auf Deutsch.
Best Practices und typische Fehler
Typische Fehler
- Das englische Ranking übernehmen. Cartesia Ink-2 gehört auf Englisch zu den besten Modellen, versteht aber kein Deutsch. Gemini 3.5 Transcribe Live war auf Englisch Siebter und auf Deutsch Zweiter. Prüfe die deutsche Rangfolge separat.
- Ein reines Englisch-Modell im zweisprachigen Agent. Acht Modelle verstehen kein Deutsch. Im Test fällt das sofort auf, im Live-Betrieb erst beim ersten deutschen Anrufer.
- Einen Latenzpuffer für Deutsch einplanen statt zu messen. In diesem Test war Deutsch nicht langsamer. Ein pauschaler Aufschlag kostet dich Gesprächsqualität ohne Grund.
- Zahlen und Daten nicht testen. Ausgeschriebene Daten und Preise sind auf Deutsch länger und fehleranfälliger. Sie gehören in jeden Testfall.
Best Practices
- Aussprache pflegen. Produktnamen, Straßennamen und Fachbegriffe brauchen oft Hilfe. Wie das geht, zeigt unser Leitfaden zum Aussprache-Wörterbuch.
- Kurze Antworten. Kurze Sätze machen Unterbrechungen weniger schmerzhaft und senken die Zeit bis zur ersten Antwort.
- Getrennte Berichte je Sprache. So siehst du sofort, wenn ein Modell-Update nur eine Sprache verschlechtert.
- Regelmäßig nachtesten. Anbieter ändern Modelle und Routen. Ein Ergebnis vom Oktober 2026 kann im Dezember anders aussehen.
Branchen-Beispiele
Zahnarztpraxis in München
Eine Patientin ruft an und bestätigt „Dienstag, den zwanzigsten, um vierzehn Uhr". Der Agent muss Datum und Uhrzeit exakt erkennen und den Termin ohne Doppelbuchung bestätigen. Im Benchmark haben alle Pipeline-Stacks die Terminbestätigung auf Deutsch bestanden. Für die Praxis zählt zusätzlich die Erkennung von Namen mit Umlauten, also gehört „Müller" oder „Größer" in den Test.
Onlineshop mit Kunden in Deutschland und Großbritannien
Kunden fragen nach der Rückgabefrist, auf Deutsch oder Englisch. Hier lohnt ein zweisprachiger Agent mit einer Spracherkennung, die beide Sprachen kann. Die Antwort „14 Tage" kam im Test bei allen Pipeline-Stacks in beiden Sprachen richtig. Wichtig ist eine Stimme, die in beiden Sprachen natürlich klingt.
IT-Dienstleister mit Hotline
Ein Kunde meldet Routerfehler E17, und der Agent beginnt eine lange Anleitung. Nach zwei Sätzen sagt der Kunde „Stopp, nur den ersten Schritt". Genau dieses Szenario hat der Benchmark getestet. Plane hier kurze Antwortschritte ein, damit eine deutsche Unterbrechung schnell greift.
Berechne deinen ROI durch automatisierte Anrufe
Erfahre, wie viel du durch KI-gesteuerte Voice Agents jeden Monat sparen kannst.
ROI Ergebnis
ROI 0%
Ohne Kreditkarte
Fazit
Deutsch ist für Voice AI kein Bremsklotz. In unserem Benchmark waren die Pipeline-Stacks auf Deutsch genauso zuverlässig und im Median sogar etwas schneller als auf Englisch. Die Entscheidungen, die wirklich zählen, triffst du bei der Spracherkennung und beim Unterbrechen: Wähle ein STT-Modell nach seinem deutschen Ergebnis, nicht nach dem englischen Ranking, und teste Unterbrechungen ausdrücklich auf Deutsch.
Mit Famulor wählst du Spracherkennung, Sprachmodell und Stimme pro Agent selbst und kannst Testanrufe in beiden Sprachen direkt vergleichen. Alle unterstützten Sprachen findest du unter Sprachen. Der nächste Schritt: Buche eine Demo und höre dir deinen Agent auf Deutsch an.
Teste unseren KI-Assistenten
Erlebe selbst, wie natürlich unser KI-Telefonassistent klingt.
Gib deine Daten ein und erhalte in wenigen Sekunden einen Anruf von unserem KI-Agenten.
Der Agent ist darauf trainiert, über Famulor-Services zu sprechen und Termine zu vereinbaren.
Demo KI-Agent
Famulor Mitarbeiter
FAQ
Ist Voice AI auf Deutsch langsamer als auf Englisch?
In unserem Benchmark nicht. Der Median der Bestätigungszeit lag über neun Pipeline-Stacks bei 1249 ms auf Deutsch und 1308 ms auf Englisch, mit je vier Anrufen pro Sprache und Stack.
Welches STT-Modell erkennt Deutsch am besten?
In unserem kurzen Korpus lag ElevenLabs Scribe v2 Realtime mit 0,62 % Wortfehlerrate vorne, vor Gemini 3.5 Transcribe Live (1,24 %) und der AssemblyAI-U3-Familie (1,86 %). Teste die Shortlist mit eigenen Telefonaufnahmen.
Ist Deutsch leichter zu erkennen als Englisch?
Das lässt sich aus diesem Test nicht ableiten. Die Clips sind verschieden, der deutsche Korpus hat nur männliche Sprecher, und ein Fehler macht 0,62 Prozentpunkte aus. Vergleiche Modelle nur innerhalb einer Sprache.
Unterstützen alle Modelle Deutsch?
Nein. 15 von 23 STT-Modellen und 28 von 29 Stimmmodellen liefen auf Deutsch. Alle 33 Sprachmodelle wurden in beiden Sprachen getestet. Acht STT-Modelle verstehen nur Englisch.
Wie teste ich Unterbrechungen auf Deutsch?
Unterbrich den Agent mitten in einer langen Antwort mit „Stopp" oder „Moment mal". Miss die Zeit bis zur Stille und prüfe, ob die nächste Antwort kurz und richtig ist. Im Benchmark dauerte das auf Deutsch im Median 1451 ms.
Sind native Sprachmodelle auf Deutsch die bessere Wahl?
Für kurze Service-Aufgaben nicht automatisch. Native Konfigurationen lagen im Median bei etwa 1,8 bis 3 Sekunden, Pipelines bei rund 1,1 bis 1,6 Sekunden. Die Half-Cascade-Varianten von GPT Realtime 2 und 2.1 bestanden auf Deutsch aber alle vier Aufgaben.
Wie aktuell sind diese Ergebnisse?
Gemessen haben wir am 13. Oktober 2026. Anbieter ändern Modelle und Routen laufend. Nutze die Zahlen als Startpunkt und teste vor dem Livegang erneut.
Kann ich den Test mit Famulor nachbauen?
Ja. In Famulor wählst du Spracherkennung, Sprachmodell und Stimme pro Agent, führst Testanrufe auf Deutsch und Englisch und vergleichst die Gespräche im Anrufverlauf.
Quellen und Methode
Alle Zahlen stammen aus dem Famulor-Labs-Benchmark vom 13. Oktober 2026: 44 Sprach- und Konfigurationszellen in Produktions-WebRTC-Räumen, LiveKit Agents 1.8.6, EU-Worker, sowie 304 Anfragen an STT-Modelle mit menschlicher Sprache. Der Sprachkorpus stammt aus dem Datensatz FLEURS (CC BY 4.0). Die vollständigen Tabellen über alle Modelle findest du im Voice-AI-Benchmark Oktober 2026.
Autor bei Famulor