Resumir contenido con:




Vocabulario personalizado para agentes de voz con IA: cómo lograr que pronuncien correctamente nombres, direcciones y jerga técnica
Un agente de voz con IA que pronuncia mal "Thompson-Reilly Orthodontics" o que no entiende el nombre de una calle como "Ashworth Close" cuesta confianza y, a la larga, llamadas. La respuesta corta es que las plataformas modernas de IA de voz resuelven esto de forma deliberada, no por suerte, mediante diccionarios de pronunciación (para la salida de voz) y listas de vocabulario personalizado (para el reconocimiento de voz). Son dos mecanismos separados pero complementarios que configuras por asistente, sin necesidad de reentrenar el modelo de lenguaje subyacente.
Cualquiera que implemente un asistente telefónico con IA para una clínica dental, un concesionario de coches o una agencia inmobiliaria se enfrenta a los mismos problemas recurrentes: nombres propios, direcciones, marcas y jerga del sector. Este artículo explica cómo funciona la solución bajo el capó, cómo la abordan los principales proveedores y cómo gestionarla de forma limpia y centralizada en Famulor.
Dos problemas que suelen confundirse: comprensión frente a pronunciación
Un agente de voz tiene dos componentes de habla, cada uno con su propio modo de fallo:
- Conversión de voz a texto (STT): El agente debe reconocer correctamente las palabras inusuales que dice quien llama: un apellido poco común, una combinación de código postal o el SKU de un producto. Si el modelo no entiende bien la palabra, el término incorrecto termina en la transcripción y todo el proceso posterior (reservas, entrada en el CRM, enrutamiento) trabajará con datos erróneos.
- Conversión de texto a voz (TTS): El agente debe enfatizar y pronunciar correctamente las palabras que él mismo dice: el nombre de una empresa, un medicamento o un término técnico. Esto no es un problema de comprensión, sino de precisión acústica.
Ambos problemas afectan a las mismas categorías de palabras: nombres propios (personas, lugares, empresas), acrónimos y abreviaturas, y jerga específica del dominio (médica, legal, técnica). Solucionar solo una parte de la ecuación dejará llamadas que siguen sonando mal.
Cómo gestionan el control de pronunciación los principales motores de voz
Famulor es una plataforma agnóstica respecto al proveedor, conectada a varios motores de STT y TTS a la vez. Cada uno adopta un enfoque diferente para el control de la pronunciación:
| Proveedor | Mecanismo | Formato | Alcance |
|---|---|---|---|
| ElevenLabs (TTS) | Diccionarios de pronunciación con reglas de alias o fonemas | Archivo de léxico .pls basado en XML, símbolos IPA | Más de 70 idiomas con el modelo v3, aproximadamente 80-90% de consistencia en la pronunciación según cifras del proveedor |
| Cartesia Sonic (TTS) | Sobrescritura de fonemas en línea directamente en el texto, o un ID de diccionario de pronunciación reutilizable | Bloques de símbolos IPA con marcado de acentuación; listas de palabras gestionadas desde el panel | Por asistente o compartido entre varios asistentes |
| Deepgram (STT) | Potenciación de palabras clave (Nova-2/Enhanced) o prompts de términos clave (Nova-3) | Palabras sueltas para palabras clave, frases de varias palabras para términos clave | Aumenta la probabilidad de reconocimiento de términos raros y nombres propios |
| OpenAI Realtime | Pronunciaciones de referencia escritas directamente en el prompt del sistema | Instrucciones en lenguaje sencillo, p. ej. "Pronuncia 'Kyiv' como 'KEE-iv'" | Dependiente del modelo; ideal para un puñado de marcas o términos clave |
El denominador común: ninguno de estos proveedores requiere un reentrenamiento completo. Los cuatro enfoques son de configuración, no de desarrollo de modelos, lo que en la práctica los convierte en una solución de una semana, no en un proyecto de un trimestre.
Una breve introducción al IPA
El Alfabeto Fonético Internacional (IPA) parece intimidante al principio, pero es manejable en la práctica: cada símbolo corresponde exactamente a un sonido, independientemente de cómo se escriba la palabra. Para el apellido "Nguyen", una regla fonética podría verse como <<ˈŋʷɪn>>: la marca de acentuación (ˈ) señala la sílaba tónica y el resto detalla el sonido real en lugar de las letras en inglés. Para la mayoría de los casos, aprender de cinco a diez símbolos (la marca de acentuación principal, un puñado de símbolos vocálicos y grupos consonánticos comunes) es suficiente para cubrir las palabras que aparecen repetidamente. Los equipos que no quieran aprender IPA desde cero pueden apoyarse en una herramienta de referencia de pronunciación o un asistente de transcripción; lo importante es escuchar el resultado en una llamada de prueba antes de que entre en funcionamiento, no solo leer la regla en papel.
Las reglas de alias son el punto de partida más sencillo y cubren la mayoría de los casos: en lugar de una notación fonética, sustituyes la palabra por una grafía que el motor predeterminado ya pronuncia correctamente. "SKU" se convierte en "skew", "Ste." en "Suite". Solo recurre al IPA cuando una regla de alias siga sonando mal al oído.
Errores comunes de configuración
Cuatro patrones aparecen una y otra vez. Primero, los equipos crean el diccionario una vez durante el lanzamiento y no vuelven a tocarlo; los nuevos productos, ubicaciones o personal con nombres inusuales pasan desapercibidos. Segundo, los equipos solo corrigen el lado del TTS, porque escuchan las malas pronunciaciones directamente durante las pruebas, mientras que los errores de STT permanecen invisibles dentro de la transcripción. Tercero, las reglas se crean por asistente en lugar de mantenerse de forma centralizada, por lo que el mismo nombre de empresa termina con tres correcciones diferentes y parcialmente obsoletas en tres versiones de idioma. Cuarto, el diccionario se construye totalmente a partir de llamadas de prueba en oficinas silenciosas en lugar de llamadas reales; el ruido de fondo, los acentos y las conexiones móviles débiles producen patrones de fallo diferentes en producción que en un entorno de prueba tranquilo.
Configuración del control de pronunciación: paso a paso
1. Recopila palabras problemáticas de conversaciones reales
No adivines qué palabras causan problemas, extráelas de los datos. El análisis posterior a la llamada y las transcripciones muestran de forma fiable qué términos se reconocen o pronocian mal repetidamente. Reúne esta lista durante dos a cuatro semanas de funcionamiento real antes de crear un diccionario, para no perder tiempo "arreglando" palabras que nunca fueron un problema.
2. Clasifica por problema de STT o TTS
Clasifica cada palabra problemática: ¿la dice quien llama y no se entiende (STT), o la dice el agente y se pronuncia mal (TTS)? Muchos términos, como el nombre de tu propia empresa, necesitan ambas correcciones a la vez.
3. Crea reglas de TTS: alias o fonemas
Los casos sencillos solo necesitan una regla de alias ("Dr." pronunciado como "Doctor"). Los nombres propios sin una pronunciación estándar obvia (un apellido poco común, un modelo de vehículo) necesitan una regla fonética escrita en IPA. Esto requiere un poco de aprendizaje, pero compensa para cualquier término que aparezca en casi todas las llamadas.
4. Añade vocabulario de STT
Introduce nombres propios raros, nombres de productos y jerga como palabras clave o términos clave. Las palabras sueltas cortas funcionan bien como una lista simple; las expresiones de varias palabras (nombres de calles con patrones de números de casa, por ejemplo) son más fiables como frases que como palabras individuales.
5. Valida con llamadas de prueba reales
Escucha las llamadas de prueba, no solo las transcripciones; los errores de acentuación a menudo no aparecen en el texto escrito. Prueba deliberadamente con diferentes hablantes, acentos y ruido de fondo antes de salir a producción.
6. Mantén de forma centralizada en lugar de duplicar por asistente
Una vez que varios asistentes (diferentes ubicaciones o idiomas, por ejemplo) utilizan los mismos términos (nombre de tu empresa, nombres comunes de productos), un único diccionario compartido y reutilizable es mejor que una copia por asistente. Reduce el trabajo de mantenimiento y evita que una corrección en un asistente se olvide en otro.
El enfoque de Famulor: control de pronunciación centralizado, sin dependencia de proveedores
Debido a que Famulor es una plataforma de IA de voz agnóstica conectada a múltiples motores de STT y TTS simultáneamente, no estás atado a una única sintaxis de pronunciación. La base de conocimientos contiene tus términos específicos de empresa de forma centralizada (nombres de productos, direcciones, puntos de contacto) y el agente los consulta en cada conversación. La biblioteca de voz te permite elegir el motor y la voz adecuados para cada idioma y caso de uso en lugar de estar vinculado a un solo proveedor de TTS.
Para pronunciaciones de referencia estilo prompt (como "pronuncia 'famulor' como 'FA-mu-lor'"), utilizas el Editor de Prompts de IA, que hace que los cambios sean probables al instante sin necesidad de código o llamadas a la API. Dado que Famulor admite más de 40 idiomas, esto es fundamental para empresas con bases de clientes multilingües o ubicaciones en más de un país: una corrección de pronunciación para el asistente en inglés no se traslada automáticamente al alemán o al francés; cada idioma necesita su propia lista mantenida.
Ejemplos del mundo real por sector
Riverside Family Dental, una clínica de 12 personas, tuvo un problema recurrente en sus primeras dos semanas tras el lanzamiento: el asistente no reconocía de forma fiable "periodontal cleaning" y pronunciaba mal el nombre del ortodoncista que refería a la clínica, un apellido con guion. Tras añadir una lista de jerga a la base de conocimientos de la clínica dental y una corrección fonética para el nombre, las solicitudes de devolución de llamada para aclaraciones durante la reserva de citas disminuyeron notablemente.
Un grupo de concesionarios de coches con tres ubicaciones se encontró con un patrón similar: nombres de modelos de vehículos como "Ioniq" o "Cayenne" se pronunciaban con el acento incorrecto en la voz TTS predeterminada, confundiendo a quienes llamaban en las conversaciones de prueba. Un pequeño diccionario fonético para los diez modelos más mencionados solucionó el problema en las tres ubicaciones a la vez, ya que el diccionario se compartió entre los asistentes en lugar de duplicarse. Más información sobre configuraciones específicas por sector en la visión general del sector automotriz.
Para un agente inmobiliario centrado en un barrio específico, el mayor problema no era la pronunciación sino el reconocimiento: los nombres de calles con grafías inusuales se entendían mal en la transcripción, lo que provocaba que los clientes fueran dirigidos a la propiedad equivocada. Una lista de términos clave con los veinte nombres de calles más comunes en el área objetivo lo solucionó sin tocar ni un solo ajuste de TTS. Más ejemplos en la página de sector inmobiliario.
Lo que cuesta realmente una mala pronunciación
Los problemas de pronunciación parecen un detalle cosmético a primera vista. En la práctica, producen tres efectos medibles: una mayor tasa de abandono, porque quien llama asume que el asistente no es legítimo y cuelga; datos erróneos, porque los nombres o direcciones mal entendidos se escriben en el CRM o calendario tal cual; y más trabajo de limpieza manual, porque el personal tiene que corregir llamadas mal enrutadas o mal emparejadas a posteriori. Cada uno de estos se traduce directamente en minutos por llamada, y los minutos por llamada se traducen en costes. Una llamada en la que el asistente tiene que preguntar un nombre dos veces o corregir manualmente una dirección mal entendida suele durar entre 20 y 40 segundos más que una llamada limpia; y, en unos cientos de llamadas al mes, eso suma un tiempo de conversación extra real, ya sea como retraso en la cola para otros clientes o como capacidad adicional que tienes que pagar.
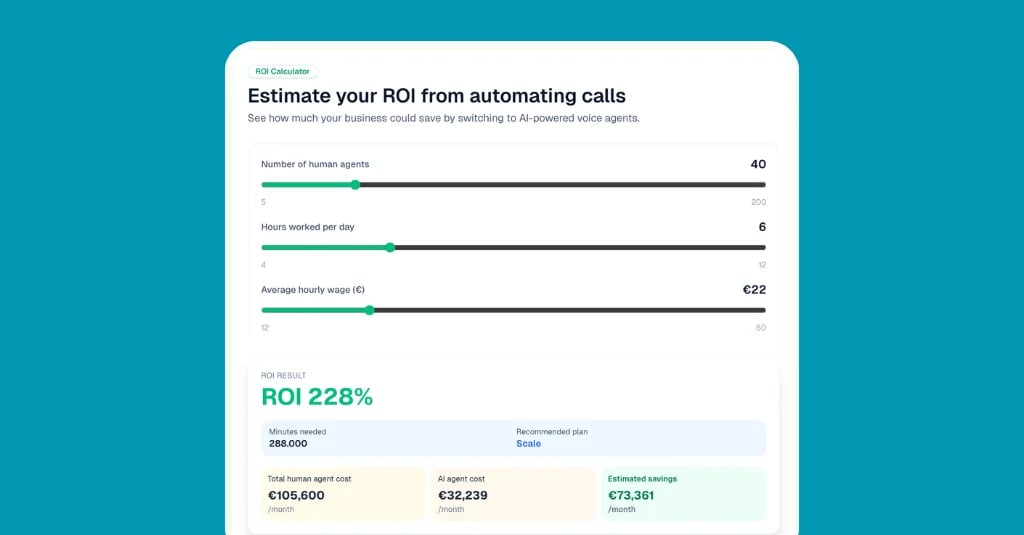
El esfuerzo de configuración es pequeño en comparación: crear los diez a treinta términos más importantes de una empresa suele llevar de una a dos horas, un trabajo único con un mantenimiento ligero después. Para tener una idea aproximada de lo que vale una pronunciación configurada limpiamente en tu propio volumen de llamadas y costes de personal, la calculadora de ROI de Famulor a continuación ofrece una estimación rápida basada en el volumen de llamadas, el tiempo medio de gestión y el coste actual de personal por llamada.
Calcula tu ROI automatizando llamadas
Descubre cuánto podrías ahorrar al usar voice agents con IA.
Resultado ROI
ROI 0%
Sin tarjeta de crédito
Conclusión
Los nombres propios, las direcciones y la jerga son la razón por la que tantos lanzamientos de IA de voz se sienten difíciles en las primeras semanas, y por la que también son solucionables con relativamente poco esfuerzo. La solución rara vez es un modelo nuevo; es un diccionario de pronunciación bien mantenido en el lado del TTS y una lista de palabras clave o términos clave en el lado del STT, ambos gestionados de forma centralizada en lugar de reinventados por asistente. Famulor agrupa exactamente estas piezas en una sola plataforma: una base de conocimientos, una biblioteca de voz multimotor, un editor de prompts y más de 40 idiomas, sin bloquearte con un solo proveedor. Si tu asistente todavía tropieza con el nombre de tu propia empresa, el siguiente paso útil es una breve demostración en vivo donde revisaremos tus términos reales (nombre de empresa, productos, direcciones) y mostraremos exactamente cómo funciona la configuración.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.

Agente IA de demo
Representante de Famulor
Preguntas frecuentes
¿Qué es un diccionario de pronunciación?
Un diccionario de pronunciación es una lista de asignaciones de palabra a pronunciación que le dice a un motor de texto a voz cómo deben sonar palabras específicas, ya sea mediante notación fonética (IPA) o una simple sustitución de palabras.
¿Cuál es la diferencia entre la potenciación de palabras clave y un diccionario de pronunciación?
La potenciación de palabras clave funciona en el lado de voz a texto y mejora la fiabilidad con la que se reconoce la palabra de quien llama. Un diccionario de pronunciación funciona en el lado de texto a voz y controla cómo el propio agente pronuncia una palabra. Necesitas ambos para manejar una palabra correctamente en ambas direcciones.
¿Necesito una lista de pronunciación separada para cada idioma?
Sí. Las reglas de pronunciación son específicas de cada idioma, ya que la fonética y los patrones de acentuación difieren entre ellos. Un nombre de empresa necesita su propia regla en una configuración de voz en alemán o francés, incluso si ya funciona correctamente en inglés.
¿Cuántas palabras debería contener un diccionario de pronunciación?
No hay un número fijo; cualquier palabra que se pronuncie o entienda mal repetidamente merece ser añadida. En la práctica, de 10 a 50 entradas cubren los problemas más comunes para la mayoría de las pequeñas y medianas empresas.
¿Puedo configurar correcciones de pronunciación sin conocimientos de programación?
Para sustituciones de palabras simples, sí; la mayoría de las plataformas, incluida Famulor, ofrecen interfaces sin código para esto. Las correcciones precisas de fonemas mediante notación IPA se benefician de una comprensión básica del alfabeto fonético, pero es algo que se puede aprender con un poco de práctica.
¿Con qué frecuencia debo actualizar la lista de pronunciación?
Justo después del lanzamiento, revísala tras dos a cuatro semanas de funcionamiento real basándote en el análisis posterior a la llamada. Después de eso, una revisión cada vez que añadas nuevos productos, ubicaciones o personal con nombres inusuales suele ser suficiente.
¿Qué sucede si una palabra no está en el diccionario?
El motor recurre a su lógica de pronunciación predeterminada, que maneja bien la mayoría de las palabras comunes. Los errores aparecen principalmente en nombres propios raros, jerga o términos en idiomas extranjeros que no tienen entrada.
¿La mala pronunciación también afecta al reconocimiento más adelante en la misma llamada?
Indirectamente, sí: cuando el asistente pronuncia mal un término, quien llama a menudo lo repite o lo corrige, lo que alarga la llamada y hace que sean más probables errores de reconocimiento adicionales.

Autor en Famulor