Résumer le contenu avec:




Vocabulaire personnalisé pour agents vocaux IA : comment obtenir une prononciation correcte des noms, adresses et termes techniques
Un agent vocal IA qui écorche le nom « Thompson-Reilly Orthodontics » ou qui comprend mal le nom de rue « Ashworth Close » entame la confiance et, à terme, fait fuir les appelants. La réponse courte : les plateformes d'IA vocale modernes résolvent ce problème de manière délibérée, et non par chance, grâce à des dictionnaires de prononciation (pour la synthèse vocale) et des listes de vocabulaire personnalisé (pour la reconnaissance vocale) — deux mécanismes distincts mais complémentaires que vous configurez par assistant, sans avoir à réentraîner le modèle de langage sous-jacent.
Toute personne déployant un assistant téléphonique IA pour un cabinet dentaire, une concession automobile ou une agence immobilière se heurte aux mêmes problèmes récurrents : noms propres, adresses, noms de marque et jargon sectoriel. Cet article explique comment la correction fonctionne réellement en coulisses, comment les principaux fournisseurs l'abordent et comment la gérer proprement et de manière centralisée dans Famulor.
Deux problèmes souvent confondus : compréhension vs prononciation
Un agent vocal possède deux composants vocaux, chacun ayant son propre mode de défaillance :
- Speech-to-Text (STT) : L'agent doit reconnaître correctement les mots inhabituels prononcés par l'appelant — un nom de famille rare, une combinaison de code postal, une référence produit. Si le modèle comprend mal le mot, le terme erroné se retrouve dans la transcription, et tout le processus en aval (réservation, saisie CRM, routage) s'appuie sur des données corrompues.
- Text-to-Speech (TTS) : L'agent doit accentuer et prononcer correctement les mots qu'il énonce lui-même — un nom d'entreprise, un médicament, un terme technique. Il ne s'agit pas d'un problème de compréhension, mais d'un problème de justesse acoustique.
Les deux problèmes touchent les mêmes catégories de mots : noms propres (personnes, lieux, entreprises), acronymes et abréviations, et jargon spécifique au domaine — médical, juridique, technique. Ne corriger qu'un seul côté de l'équation laisse toujours des appels à la sonorité défaillante.
Comment les principaux moteurs vocaux gèrent le contrôle de la prononciation
Famulor est une plateforme agnostique connectée simultanément à plusieurs moteurs STT et TTS. Chacun adopte une approche différente pour le contrôle de la prononciation :
| Fournisseur | Mécanisme | Format | Portée |
|---|---|---|---|
| ElevenLabs (TTS) | Dictionnaires de prononciation avec règles d'alias ou de phonèmes | Fichier lexique .pls basé sur XML, symboles API | Plus de 70 langues avec le modèle v3, environ 80-90 % de cohérence de prononciation selon les chiffres du fournisseur |
| Cartesia Sonic (TTS) | Remplacements de phonèmes en ligne directement dans le texte, ou ID de dictionnaire de prononciation réutilisable | Blocs de symboles API avec marquage de l'accentuation ; listes de mots gérées via tableau de bord | Par assistant, ou partagé entre plusieurs assistants |
| Deepgram (STT) | Renforcement de mots-clés (Nova-2/Enhanced) ou prompting de termes clés (Nova-3) | Mots uniques pour les mots-clés, expressions multi-mots pour les termes clés | Augmente la probabilité de reconnaissance pour les termes rares et les noms propres |
| OpenAI Realtime | Prononciations de référence écrites directement dans l'instruction système (system prompt) | Instructions en langage clair, ex. : « Prononcez 'Kyiv' comme 'KEE-iv' » | Dépendant du modèle ; idéal pour une poignée de marques ou de termes clés |
Le point commun : aucun de ces fournisseurs ne nécessite un réentraînement complet. Ces quatre approches relèvent de la configuration et non du développement de modèle, ce qui en fait, en pratique, une correction d'une semaine plutôt qu'un projet d'un trimestre.
Un mini guide de l'API
L'Alphabet Phonétique International (API) semble intimidant au premier abord, mais il est gérable en pratique : chaque symbole correspond exactement à un son, quelle que soit l'orthographe du mot. Pour le nom de famille « Nguyen », une règle de phonème pourrait ressembler à <<ˈŋʷɪn>> — le signe d'accentuation (ˈ) signale la syllabe accentuée, et le reste détaille le son réel plutôt que les lettres. Pour la plupart des cas d'usage, apprendre cinq à dix symboles — le signe d'accentuation primaire (ˈ), quelques symboles de voyelles et des groupes de consonnes courants — suffit à couvrir les mots qui reviennent fréquemment. Les équipes qui ne souhaitent pas apprendre l'API à partir de zéro peuvent s'appuyer sur un outil de référence de prononciation ou une aide à la transcription. L'essentiel est d'écouter le résultat lors d'un appel de test avant la mise en ligne, plutôt que de simplement lire la règle sur papier.
Les règles d'alias sont un point de départ plus simple et couvrent la plupart des cas : au lieu d'une notation phonétique, vous remplacez le mot par une orthographe que le moteur par défaut prononce déjà correctement — « SKU » devient « skew », « Ste. » devient « Suite ». Ne passez à l'API que si une règle d'alias sonne toujours faux à l'oreille.
Erreurs de configuration courantes
Quatre schémas reviennent sans cesse. Premièrement, les équipes créent le dictionnaire une fois lors du déploiement et n'y touchent plus jamais — les nouveaux produits, emplacements ou membres du personnel aux noms inhabituels passent alors inaperçus. Deuxièmement, les équipes ne corrigent que le côté TTS, car elles entendent directement les erreurs de prononciation lors des tests, tandis que les erreurs STT restent invisibles dans la transcription. Troisièmement, les règles sont créées par assistant au lieu d'être maintenues de manière centralisée, si bien que le même nom d'entreprise finit par avoir trois corrections différentes et partiellement obsolètes sur trois versions linguistiques. Quatrièmement, le dictionnaire est entièrement construit à partir d'appels de test en environnement calme plutôt que d'appels réels — le bruit de fond, les accents et les connexions mobiles faibles produisent des schémas de défaillance différents en production que dans un environnement de test serein.
Mise en place du contrôle de prononciation : étape par étape
1. Collectez les mots problématiques à partir de conversations réelles
Ne devinez pas quels mots posent problème — extrayez-les des données. L'analyse post-appel et les transcriptions montrent de manière fiable quels termes sont systématiquement mal reconnus ou mal prononcés. Rassemblez cette liste sur deux à quatre semaines d'exploitation réelle avant de construire un dictionnaire, afin de ne pas perdre de temps à « corriger » des mots qui n'ont jamais posé de problème.
2. Triez par problème STT ou TTS
Classez chaque mot problématique : est-il dit par l'appelant et mal entendu (STT), ou dit par l'agent et mal prononcé (TTS) ? De nombreux termes — votre propre nom d'entreprise, par exemple — nécessitent les deux corrections simultanément.
3. Créez des règles TTS : alias ou phonème
Les cas simples ne nécessitent qu'une règle d'alias (« Dr. » prononcé « Docteur »). Les noms propres sans prononciation standard évidente — un nom de famille rare, un modèle de véhicule — nécessitent une règle de phonème écrite en API. Cela demande un peu d'apprentissage, mais s'avère payant pour tout terme apparaissant dans presque chaque appel.
4. Ajoutez du vocabulaire STT
Saisissez les noms propres rares, les noms de produits et le jargon en tant que mots-clés ou termes clés. Les mots uniques courts fonctionnent bien sous forme de liste simple ; les expressions composées (noms de rue avec numéros de maison, par exemple) sont plus fiables sous forme d'expressions que de mots isolés.
5. Validez avec des appels de test réels
Écoutez les appels de test, pas seulement les transcriptions — les erreurs d'accentuation n'apparaissent souvent pas du tout dans le texte écrit. Testez de manière délibérée avec différents locuteurs, accents et bruits de fond avant la mise en service.
6. Maintenez de manière centralisée au lieu de dupliquer par assistant
Dès que plusieurs assistants — différents emplacements ou langues, par exemple — utilisent les mêmes termes (votre nom d'entreprise, noms de produits courants), un dictionnaire partagé et réutilisable est préférable à une copie par assistant. Cela réduit le travail de maintenance et évite qu'une correction effectuée sur un assistant ne soit oubliée sur un autre.
L'approche Famulor : contrôle de prononciation centralisé, sans verrouillage propriétaire
Parce que Famulor est une plateforme d'IA vocale agnostique connectée simultanément à plusieurs moteurs STT et TTS, vous n'êtes pas enfermé dans une syntaxe de prononciation unique. La base de connaissances centralise vos termes spécifiques — noms de produits, adresses, points de contact — et l'agent y puise dans chaque conversation. La bibliothèque vocale vous permet de choisir le moteur et la voix adaptés à chaque langue et cas d'usage, au lieu d'être lié à un seul fournisseur TTS.
Pour les prononciations de référence de type « prompt » — « prononcez 'famulor' comme 'FA-mu-lor' » — vous utilisez l'éditeur de prompt IA, qui rend les modifications instantanément testables sans code ni appels API. Comme Famulor prend en charge plus de 40 langues, cela est crucial pour les entreprises ayant une clientèle multilingue ou des sites dans plusieurs pays : une correction de prononciation pour l'assistant anglais ne s'applique pas automatiquement aux versions allemande ou française — chaque langue nécessite sa propre liste maintenue.
Exemples concrets par secteur
Riverside Family Dental, un cabinet de 12 personnes, a rencontré un problème récurrent dans les deux semaines suivant son déploiement : l'assistant ne reconnaissait pas de manière fiable le « détartrage parodontal » et prononçait mal le nom de l'orthodontiste référent du cabinet, un nom de famille composé. Après l'ajout d'une liste de jargon à la base de connaissances du cabinet dentaire et une correction phonétique pour le nom, les demandes de rappel pour clarification lors de la prise de rendez-vous ont sensiblement diminué.
Un groupe de trois concessions automobiles a rencontré un schéma similaire : les noms de modèles de véhicules comme « Ioniq » ou « Cayenne » étaient mal accentués par la voix TTS par défaut, ce qui perturbait les appelants lors des tests. Un petit dictionnaire de phonèmes pour les dix modèles les plus cités a résolu le problème pour les trois sites simultanément, le dictionnaire étant partagé entre les assistants plutôt que dupliqué. Plus d'informations sur les configurations spécifiques aux secteurs sont disponibles dans l'aperçu du secteur automobile.
Pour un agent immobilier concentré sur un quartier spécifique, le problème majeur n'était pas la prononciation mais la reconnaissance : des noms de rues à l'orthographe inhabituelle étaient constamment mal entendus dans la transcription, conduisant à associer les appelants à la mauvaise annonce. Une liste de termes clés avec les vingt noms de rues les plus courants dans la zone cible a résolu le problème sans toucher à un seul réglage TTS. Plus d'exemples sont disponibles sur la page immobilier.
Ce que coûte réellement une mauvaise prononciation
Les problèmes de prononciation semblent être un détail cosmétique au premier abord. En pratique, ils produisent trois effets mesurables : un taux d'abandon plus élevé, car les appelants supposent que l'assistant n'est pas légitime et raccrochent ; des données erronées, car les noms ou adresses mal entendus sont saisis tels quels dans le CRM ou le calendrier ; et un travail de nettoyage manuel accru, car le personnel doit corriger les appels mal routés ou mal appariés après coup. Chacun de ces points se traduit directement en minutes par appel, et les minutes par appel se traduisent en coûts. Un appel où l'assistant doit demander un nom deux fois ou où une adresse mal entendue doit être corrigée manuellement dure souvent 20 à 40 secondes de plus qu'un appel fluide — et sur quelques centaines d'appels par mois, cela représente un temps de parole supplémentaire réel, soit sous forme de délai d'attente pour d'autres appelants, soit sous forme de capacité supplémentaire que vous devez payer.
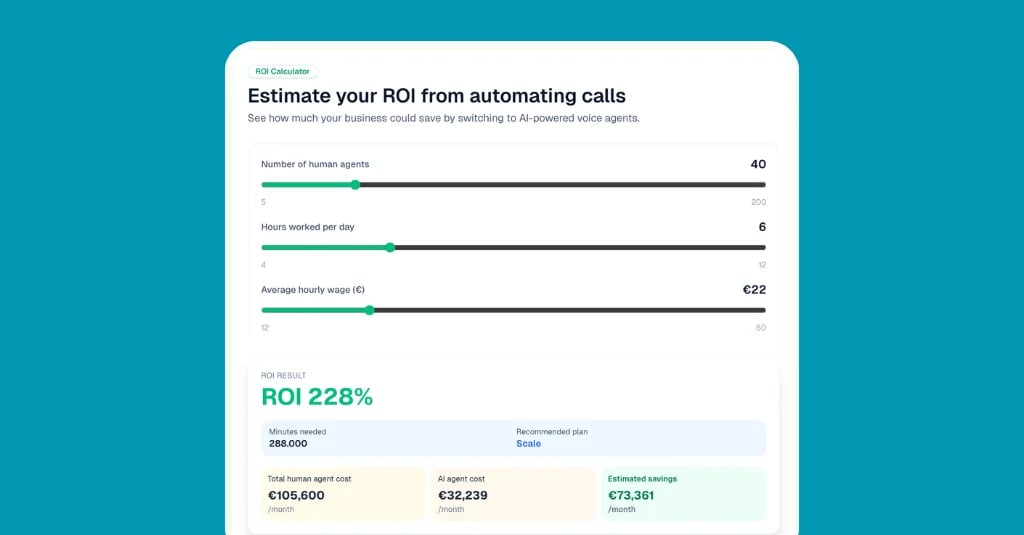
L'effort de configuration est faible en comparaison : construire les trente termes les plus importants d'une entreprise prend généralement une à deux heures — un travail ponctuel avec un entretien léger par la suite. Pour avoir une idée approximative de ce qu'une prononciation correctement configurée représente en termes de volume d'appels et de coûts de personnel, le calculateur de ROI Famulor ci-dessous donne une estimation rapide basée sur le volume d'appels, la durée moyenne de traitement et le coût actuel du personnel par appel.
Estimez votre ROI en automatisant vos appels
Voyez combien vous pourriez économiser chaque mois grâce aux voice agents IA.
Résultat ROI
ROI 0%
Sans carte bancaire
Conclusion
Les noms propres, les adresses et le jargon sont la raison pour laquelle tant de déploiements d'IA vocale semblent difficiles au cours des premières semaines — et pourquoi ils sont également corrigibles avec relativement peu d'efforts. La solution est rarement un nouveau modèle ; il s'agit d'un dictionnaire de prononciation bien entretenu côté TTS et d'une liste de mots-clés ou de termes clés côté STT, le tout géré de manière centralisée plutôt que réinventé par assistant. Famulor regroupe exactement ces éléments dans une seule plateforme : une base de connaissances, une bibliothèque vocale multi-moteurs, un éditeur de prompt et plus de 40 langues — sans vous enfermer chez un seul fournisseur. Si votre assistant trébuche encore sur votre propre nom d'entreprise, la prochaine étape utile est une courte démonstration en direct où nous passerons en revue vos termes réels — nom d'entreprise, produits, adresses — et montrerons exactement comment fonctionne la configuration.
Essayez notre Assistant IA
Découvrez à quel point notre assistant téléphonique IA sonne naturel.
Entrez vos coordonnées et recevez un appel de notre agent IA en quelques secondes.
L'agent est formé pour parler des services Famulor et prendre des rendez-vous.

Agent IA de démo
Représentant Famulor
FAQ
Qu'est-ce qu'un dictionnaire de prononciation ?
Un dictionnaire de prononciation est une liste de correspondances mot-à-prononciation qui indique à un moteur de synthèse vocale comment des mots spécifiques doivent sonner — soit par notation phonétique (API), soit par une simple substitution de mot.
Quelle est la différence entre le renforcement de mots-clés et un dictionnaire de prononciation ?
Le renforcement de mots-clés agit sur le côté reconnaissance vocale (STT) et améliore la fiabilité avec laquelle le mot d'un appelant est reconnu. Un dictionnaire de prononciation agit sur le côté synthèse vocale (TTS) et contrôle la façon dont l'agent lui-même prononce un mot. Vous avez besoin des deux pour gérer un mot correctement dans les deux sens.
Ai-je besoin d'une liste de prononciation distincte pour chaque langue ?
Oui. Les règles de prononciation sont spécifiques à chaque langue, car la phonétique et les schémas d'accentuation diffèrent. Un nom d'entreprise nécessite sa propre règle dans une configuration vocale allemande ou française, même s'il fonctionne déjà correctement en anglais.
Combien de mots un dictionnaire de prononciation doit-il contenir ?
Il n'y a pas de nombre fixe — tout mot systématiquement mal prononcé ou mal entendu mérite d'être ajouté. En pratique, 10 à 50 entrées couvrent les problèmes les plus courants pour la plupart des petites et moyennes entreprises.
Puis-je configurer des corrections de prononciation sans connaissances en codage ?
Pour les substitutions de mots simples, oui — la plupart des plateformes, dont Famulor, proposent des interfaces sans code pour cela. Les corrections précises utilisant la notation API bénéficient d'une compréhension de base de l'alphabet phonétique, mais cela s'apprend avec un peu de pratique.
À quelle fréquence dois-je mettre à jour la liste de prononciation ?
Juste après le déploiement, réexaminez-la après deux à quatre semaines d'exploitation réelle sur la base de l'analyse post-appel. Ensuite, une vérification à chaque ajout de nouveaux produits, emplacements ou membres du personnel aux noms inhabituels est généralement suffisante.
Que se passe-t-il si un mot n'est pas dans le dictionnaire ?
Le moteur revient à sa logique de prononciation par défaut, qui gère bien la plupart des mots courants. Les erreurs apparaissent principalement pour les noms propres rares, le jargon ou les termes en langue étrangère qui n'ont pas d'entrée.
Une mauvaise prononciation affecte-t-elle aussi la reconnaissance plus tard dans le même appel ?
Indirectement, oui : lorsque l'assistant prononce mal un terme, les appelants le répètent ou le corrigent souvent, ce qui allonge l'appel et rend les erreurs de reconnaissance supplémentaires plus probables.

Rédacteur chez Famulor