Inhoud samenvatten met:




A/B-testen voor Voice AI-agents: Hoe je prompts en gespreksstromen optimaliseert met data
Een AI-voice-agent die vanaf dag één vlekkeloos presteert, is de uitzondering, niet de regel. De meeste bedrijven steken weken in het schrijven van de initiële prompt, gaan live — en ontdekken na 500 gesprekken dat hun taakvoltooiingspercentage is blijven steken op 68%. Het verschil tussen een gemiddelde en een uitmuntende voice-agent zit hem niet in het model of de TTS-engine. Het is de systematische optimalisatie die plaatsvindt na de lancering. A/B-testen is de methode die dit verschil meetbaar maakt.
Deze gids leidt je door het plannen, uitvoeren en evalueren van A/B-tests voor AI-telefoonassistenten — van geïsoleerde promptexperimenten tot gestructureerde canary-rollouts met guardrail-metrics. Je leert welke variabelen je moet testen, hoeveel gesprekken je nodig hebt voor betrouwbare resultaten en welke fouten zelfs ervaren teams blijven maken.
Waarom traditioneel A/B-testen tekortschiet voor voice-agents
Als je A/B-testen kent van het web — knopkleuren, kopvarianten, checkout-stromen — dan vereisen voice-agents een fundamenteel andere mindset. Drie kenmerken maken voice-tests complexer dan de optimalisatie van een landingspagina:
Niet-determinisme: Dezelfde beller met dezelfde vraag kan twee totaal verschillende gespreksroutes triggeren bij exact dezelfde agent. Eén testgesprek is een steekproef van één — statistisch gezien betekenisloos. Pas na 3 tot 5 herhalingen per scenario ontstaat er een betrouwbaar patroon.
Complexiteit van meerdere gespreksrondes: Een webformulier volgt een lineair pad. Een telefoongesprek bevat onderbrekingen, vervolgvragen, onderwerpwisselingen en emotionele dynamiek. Een promptwijziging die de begroeting verbetert, kan drie stappen later het inplannen van een afspraak verslechteren.
Meerdimensionale metrics: Een variant kan de taakvoltooiing verhogen terwijl tegelijkertijd de latentie toeneemt, wat zorgt voor meer onderbrekingen of een verslechterde toon. Als je alleen het succespercentage meet, mis je regressies in andere dimensies volledig.
Wat je kunt testen bij voice-agents: de 7 variabelen
Effectief A/B-testen begint met een duidelijke isolatie. Verander slechts één variabele per test — anders is geen enkel resultaat toe te schrijven aan een specifieke wijziging. Deze zeven knoppen heb je tot je beschikking:
| Variabele | Voorbeeld | Typische impact |
|---|---|---|
| Systeemprompt | Kortere prompt vs. gedetailleerde prompt | Taakvoltooiing, latentie, gespreksduur |
| Begroeting | "Goedemorgen, met de praktijk van dr. Weber" vs. "Hallo, waarmee kan ik je vandaag helpen?" | Betrokkenheid van de beller, afhaakpercentage |
| Escalatielogica | Overdracht naar een mens na 2 vs. 3 mislukte pogingen | Containment-percentage, CSAT |
| TTS-stem | Stem A (warm, traag) vs. Stem B (neutraal, snel) | CSAT, waargenomen betrouwbaarheid |
| STT-provider | Provider A vs. Provider B voor bellers met een accent | ASR-nauwkeurigheid, foutinterpretatiegraad |
| Kennisbank | FAQ-gebaseerd vs. documentgebaseerd ophalen van informatie | Antwoordkwaliteit, hallucinatiegraad |
| Toolbeleid | Direct agendaplek boeken vs. na bevestiging | Conversie, boekingsfouten |
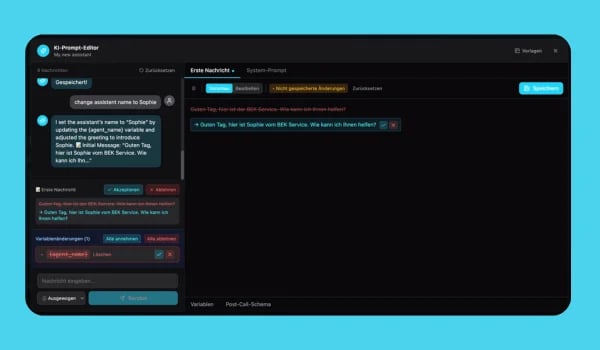
Met de Famulor Prompt Editor kun je varianten naast elkaar aanmaken en testen zonder dat je code hoeft aan te passen.
De A/B-testworkflow: van hypothese naar rollout
Een gestructureerde A/B-test voor voice-agents volgt vijf fasen. Sla er geen over — elke fase dient een doel.
Fase 1: Meet je nulmeting
Voordat je iets verandert, heb je een zuivere nulmeting nodig. Definieer je scenario's: wat zijn de meest voorkomende gesprekstypes? Een autoreparatiebedrijf zoals Bremer Auto Service in Hamburg handelt doorgaans afspraakverzoeken (45%), annuleringen (25%), servicevragen (20%) en noodgevallen (10%) af. Spiegel deze verdeling in je testscenario's.
Stel je personamix vast: ongeveer 70% meewerkende bellers, 15% ongeduldige of gefrustreerde bellers, 10% afgeleide bellers en 5% bellers met een sterk accent. Deze mix blijft identiek voor beide varianten.
Met het Famulor KPI-dashboard kun je je nulmetingsgegevens automatisch vastleggen en exporteren.
Fase 2: Verander één variabele
Formuleer je hypothese concreet: "Als ik de systeemprompt inkort van 800 naar 400 tokens, zal de latentie met ten minste 150 ms dalen zonder dat de taakvoltooiing onder de 80% zakt." Verander exact één variabele. Als je de prompt inkort en tegelijkertijd de stem wijzigt, weet je niet wat het verschil heeft veroorzaakt.
Fase 3: Voer de test uit
Draai beide varianten tegen identieke scenario's. Herhaal elk scenario ten minste 3 keer, idealiter 5 keer. Met 40 evaluatiescenario's en een frequentie van 5 betekent dit 200 testgesprekken per variant — een investering die zichzelf terugbetaalt in de helderheid van de resultaten.
Gebruik voor tests met live verkeer de canary gate-methode:
- Fase 0 (Dry Run): Synthetische tests en regressietests moeten slagen.
- Fase 1 (5–10% verkeer): Houd dit ten minste één bedrijfscyclus aan.
- Fase 2 (25%): Schaal op zodra cohorten vergelijkbaar zijn.
- Fase 3 (50%): Splits de test zolang de primaire metric en guardrails standhouden.
- Fase 4 (100%): Volledige rollout na gedocumenteerde goedkeuring.
Fase 4: Evalueer de resultaten
Vergelijk niet alleen het algehele succespercentage. Gebruik de volledige set aan metrics:
| Metric | Wat het laat zien | Waarschuwingssignaal |
|---|---|---|
| Taakvoltooiing | Werd het probleem van de beller opgelost? | Onder 75%: actie vereist |
| Latentie (P50/P95/P99) | Reactiesnelheid | P99 boven 3 seconden: tail-regressie |
| Onderbrekingspercentage | Hoe vaak de agent door de beller heen praat | Stijging > 5% t.o.v. nulmeting |
| Containment-percentage | Gesprekken opgelost zonder menselijke tussenkomst | Daling terwijl voltooiing stijgt = agent escaleert minder maar lost het niet beter op |
| Gespreksduur | Efficiëntie van de dialoog | Langere gesprekken bij gelijke voltooiing = onnodige lussen |
| CSAT / Sentiment | Tevredenheid van de beller | Nauwkeurigheidswinst ten koste van de toon |
Besluitvormingskader: Een variant wint alleen als de primaire metric verbetert EN alle guardrails binnen de marges blijven. Een stijging in taakvoltooiing van 72% naar 78% die de latentie verdubbelt, is geen verbetering — het is een compromis dat een afzonderlijke evaluatie vereist.
Fase 5: Documenteer en itereer
Leg vast wat er getest is, hoeveel gesprekken er hebben plaatsgevonden, wat de uitkomst was en welk besluit er is genomen. Mislukte tests zijn net zo waardevol als succesvolle — ze voorkomen dat het team dezelfde fout herhaalt. Maak van mislukte varianten regressietests: de prompt die het escalatiepercentage verhoogde, wordt een testgeval dat automatisch draait bij toekomstige wijzigingen.
De 5 meest gemaakte fouten bij A/B-testen van Voice AI
Zelfs ervaren teams trappen regelmatig in deze valkuilen:
1. Meerdere variabelen tegelijk veranderen. "We hebben de prompt ingekort, de stem gewijzigd en de escalatielogica aangepast." Resultaat: als de metrics veranderen, weet niemand welke wijziging de oorzaak was. Regel: één variabele per test, altijd.
2. Te weinig herhalingen. Eén enkel testgesprek per scenario behandelt ruis als signaal. Minimum: 3 herhalingen, idealiter 5. Voor voice-agents, waarbij elk gesprek anders kan verlopen, is dit geen luxe — het is basis statistische hygiëne.
3. Verschillende scenario's tussen varianten. Variant A wordt getest met eenvoudige afspraakverzoeken, variant B met complexe vervolgvragen. De resultaten zijn niet vergelijkbaar — de input moet identiek zijn.
4. Alleen naar het succespercentage kijken. Taakvoltooiing stijgt van 70% naar 76%, maar de latentie verdubbelt en het onderbrekingspercentage springt met 12% omhoog. Op het dashboard lijkt het een verbetering. In werkelijkheid is de gesprekservaring slechter.
5. Geen tail-latentie meten. Het gemiddelde is 800 ms — acceptabel. Maar de P99 zit op 4,2 seconden. Dat betekent dat elke honderdste beller meer dan vier seconden wacht op een reactie. Meet percentielen, geen gemiddelden.
Case study: Bremer Auto Service optimaliseert afspraakplanning
Bremer Auto Service, een autoreparatiebedrijf in Hamburg, gebruikt Famulor voor het inplannen van afspraken. Na de initiële lancering bleef de taakvoltooiing steken op 71% — goed, maar niet goed genoeg. Het team voerde een gestructureerde A/B-test uit:
Hypothese: "Als de agent naar het voertuigtype vraagt voordat er afspraakmomenten worden voorgesteld, zal de first-call resolution stijgen omdat direct de juiste werkplaatsplek wordt toegewezen."
Setup: Variant A (bestaand): agent vraagt naar de gewenste tijd, dan naar het voertuig. Variant B (nieuw): agent vraagt eerst naar het voertuig en het probleem, en biedt dan passende momenten aan.
Resultaten na 300 testgesprekken:
- Taakvoltooiing: 71% naar 83% (+12 procentpunten)
- Latentie (P50): 720 ms naar 780 ms (+60 ms, binnen tolerantie)
- Gespreksduur: 2:10 min naar 1:48 min (−22 seconden, minder vervolgvragen)
- Boekingsfouten: 8% naar 3% (−5 procentpunten)
Het resultaat was onomstotelijk. De variant werd uitgerold via de Famulor Agent Coach-functie en de nulmeting werd bijgewerkt voor de volgende test.
Steekproefgroottes: hoeveel gesprekken heb je echt nodig?
De vraag naar de juiste steekproefgrootte bepaalt of je testresultaten betrouwbaar zijn of dat je reageert op ruis. Referentiewaarden:
| Gesprekken per variant | Betrouwbaarheid | Aanbeveling |
|---|---|---|
| Onder 100 | Alleen richtinggevend | Voor eerste inschatting, niet voor rollout-besluiten |
| 100–500 | Grote effecten detecteerbaar | Geschikt voor significante promptwijzigingen |
| 500–1,000 | Matige wijzigingen meetbaar | Standaard voor de meeste tests |
| Boven 1.000 | Kleine verschillen statistisch significant | Voor finetuning (stem, toon) |
Planningsvoorbeeld: om betrouwbaar een stijging in taakvoltooiing van 70% naar 75% te detecteren, heb je ongeveer 1.250 gesprekken per variant nodig. Voor een sprong van 70% naar 80% zijn ongeveer 300 gesprekken voldoende.
Simulatie vs. live verkeer: wanneer gebruik je welke aanpak?
Niet elke test hoeft echte bellers te betrekken. De juiste strategie combineert beide benaderingen:
Simulatietests (pre-rollout): Beide varianten draaien tegen identieke synthetische scenario's. Geen risico voor echte bellers, geen omzetverlies door slechte varianten. Ideaal voor vroege iteraties en grote promptwijzigingen. De geïntegreerde testomgeving van Famulor ondersteunt precies deze aanpak.
Live-verkeertests: Echte bellers worden verdeeld over de varianten. Dit levert de meest realistische data op, maar brengt risico's met zich mee: slechte varianten kosten echte conversies. Gebruik dit pas nadat de simulatiefase is geslaagd en er een canary gate met duidelijke stopcondities is gedefinieerd.
Aanbevolen pad: Simulatie, dan canary (5–10%), dan opschalen (25%), dan splitsen (50%), dan volledige rollout (100%). Elke fase heeft een stopconditie. Als een guardrail-metric breekt, rol dan terug — ga niet in discussie.
Famulor als jouw A/B-testplatform: wat de tools opleveren
Famulor biedt de tools die nodig zijn om de gehele A/B-testworkflow uit te voeren — zonder externe software of maatwerkcode:
- Prompt Editor: Creëer, versieer en configureer promptvarianten voor A/B-testen.
- Agent Coach: Evaluatie na het gesprek met geautomatiseerde scoringscriteria — niet alleen of het gesprek slaagde, maar ook hoe goed het verliep.
- KPI Dashboard: Taakafronding, latentie, containment, CSAT en gespreksduur in één oogopslag — filterbaar per variant.
- Testomgeving: Synthetische testgesprekken met configureerbare scenario's en persona's.
- 300+ Integraties: CRM-data, agendasystemen en helpdeskhulpmiddelen worden automatisch meegenomen in de evaluatie.
Bereken je ROI met geautomatiseerde gesprekken
Ontdek hoeveel je per maand bespaart via AI voice agents.
ROI Resultaat
ROI 0%
Geen creditcard nodig
Conclusie
A/B-testen voor voice AI-agents is geen optionele extra, maar de enige methode die systematisch en reproduceerbaar aantoont welke wijzigingen je agent verbeteren en welke hem verslechteren. De sleutel is discipline: één variabele per test, voldoende herhalingen, multidimensionale statistieken en een gedocumenteerd besluitvormingskader.
Met Famulor heb je de tools al in huis: Prompt Editor, Agent Coach, KPI Dashboard en de geïntegreerde testomgeving vormen samen een gesloten optimalisatiecyclus. Begin vandaag nog met je eerste gestructureerde A/B-test: meet je nulmeting, formuleer een hypothese en test één enkele variabele. De resultaten spreken voor zich.
Volgende stap: Maak je gratis Famulor-account aan en zet je eerste A/B-test op in de Prompt Editor.
Probeer onze AI-assistent
Ervaar hoe natuurlijk onze AI-telefoonassistent klinkt.
Vul je gegevens in en ontvang binnen enkele seconden een oproep van onze AI-agent.
De agent is getraind om over Famulor-diensten te praten en afspraken te maken.

Demo AI-agent
Famulor medewerker
Veelgestelde vragen
Wat is A/B-testen voor voice AI-agents?
A/B-testen vergelijkt twee varianten van een voice-agent — die in precies één variabele verschillen — op basis van dezelfde testscenario's. Het doel is om datagestuurde beslissingen te nemen over welke versie betere resultaten oplevert.
Hoeveel testgesprekken heb ik nodig voor zinvolle resultaten?
Minimaal 100 gesprekken per variant voor een indicatie. Voor statistisch betrouwbare conclusies bij matige effecten worden 500 tot 1.000 gesprekken per variant aanbevolen.
Welke statistieken moet ik bijhouden bij een voice AI A/B-test?
Naast taakafronding als primaire statistiek: latentie (P50/P95/P99), onderbrekingspercentage, containment-percentage, gespreksduur en CSAT. Een variant wint alleen als aan alle randvoorwaarden is voldaan.
Kan ik meerdere variabelen tegelijk testen?
Nee. Wijzig slechts één variabele per test — prompt, stem, escalatielogica of STT-provider. Anders kun je niet herleiden welke wijziging het resultaat heeft veroorzaakt.
Wat is een canary gate-uitrol?
Een gefaseerde uitrol waarbij de nieuwe variant in eerste instantie slechts 5 tot 10 procent van het live verkeer ontvangt. Als de resultaten positief zijn, wordt dit geleidelijk uitgebreid naar 25, 50 en uiteindelijk 100 procent. Elke fase heeft duidelijke stopcondities.
Hoe verschilt simulatietesten van testen met live verkeer?
Simulatietests gebruiken synthetische scenario's zonder echte bellers — nul risico, ideaal voor vroege iteraties. Tests met live verkeer verdelen echte bellers over de varianten en leveren realistischere data op, maar brengen conversierisico met zich mee.
Welke veelgemaakte fouten moet ik vermijden bij A/B-testen?
De meest gemaakte fouten: meerdere variabelen tegelijk wijzigen, te weinig herhalingen, verschillende scenario's tussen varianten, alleen kijken naar het succespercentage en het niet meten van de staartlatentie.
Hoe lang duurt een typische voice AI A/B-test?
Een simulatietest met 200 scenario's is in een paar uur klaar. Een test met live verkeer duurt één tot vier weken, afhankelijk van het gespreksvolume, om statistisch significante resultaten te leveren.
Kan ik A/B-testen ook gebruiken voor outbound voice-agents?
Ja. Outbound agents profiteren in het bijzonder van A/B-tests omdat variabelen zoals beltijd, openingszin en gespreksscript een direct meetbare impact hebben op conversie- en afspraakpercentages.
Biedt Famulor ingebouwde functies voor A/B-testen?
Ja. Famulor combineert de Prompt Editor, Agent Coach, het KPI Dashboard en de testomgeving tot een gesloten optimalisatiecyclus. Je kunt varianten maken, testen en evalueren zonder externe tools.

Auteur bij Famulor