Résumer le contenu avec:




Tests A/B pour agents vocaux IA : comment optimiser les prompts et les flux d'appels grâce aux données
Un agent vocal IA qui fonctionne parfaitement dès le premier jour est l'exception, pas la règle. La plupart des entreprises passent des semaines à concevoir le prompt initial, le mettent en service, puis découvrent après 500 appels que leur taux de résolution plafonne à 68 %. La différence entre un agent vocal moyen et un agent exceptionnel ne réside pas dans le modèle ou le moteur TTS. Elle réside dans l'optimisation systématique effectuée après le lancement. Le test A/B est la méthode qui rend cette différence mesurable.
Ce guide vous explique comment planifier, exécuter et évaluer des tests A/B pour des assistants téléphoniques IA, des expériences isolées sur les prompts aux déploiements progressifs structurés avec des métriques de garde-fou. Vous apprendrez quelles variables tester, quel volume d'appels est nécessaire pour obtenir des résultats fiables et quelles erreurs les équipes expérimentées continuent de commettre.
Pourquoi les tests A/B traditionnels sont inadaptés aux agents vocaux
Si vous connaissez les tests A/B issus du web (couleurs de boutons, variantes de titres, tunnels de commande), sachez que les agents vocaux exigent une approche fondamentalement différente. Trois caractéristiques rendent les tests vocaux plus complexes que l'optimisation d'une simple page de destination :
Non-déterminisme : Le même appelant avec la même question peut déclencher deux parcours de conversation totalement différents avec un agent identique. Un seul appel de test constitue un échantillon unique, statistiquement dénué de sens. Ce n'est qu'après 3 à 5 répétitions par scénario qu'un modèle fiable émerge.
Complexité multi-tours : Un formulaire web suit un chemin linéaire. Une conversation téléphonique comporte des interruptions, des questions de suivi, des changements de sujet et des dynamiques émotionnelles. Une modification de prompt qui améliore l'accueil peut dégrader la prise de rendez-vous trois tours plus tard.
Métriques multidimensionnelles : Une variante peut augmenter le taux de résolution tout en augmentant simultanément la latence, provoquant davantage d'interruptions ou dégradant le ton. Si vous ne mesurez que le taux de succès, vous passez totalement à côté des régressions sur d'autres dimensions.
Ce que vous pouvez tester sur les agents vocaux : les 7 variables
Un test A/B efficace commence par une isolation claire. Ne modifiez qu'une seule variable par test, sinon aucun résultat ne pourra être attribué. Ces sept leviers sont à votre disposition :
| Variable | Exemple | Impact typique |
|---|---|---|
| Prompt système | Prompt court vs prompt détaillé | Taux de résolution, latence, durée d'appel |
| Accueil | "Bonjour, cabinet du Dr Weber" vs "Bonjour, comment puis-je vous aider aujourd'hui ?" | Engagement de l'appelant, taux d'abandon |
| Logique d'escalade | Transfert à un humain après 2 vs 3 tentatives infructueuses | Taux de confinement, CSAT |
| Voix TTS | Voix A (chaleureuse, lente) vs Voix B (neutre, rapide) | CSAT, fiabilité perçue |
| Fournisseur STT | Fournisseur A vs Fournisseur B pour les appelants avec accent | Précision ASR, taux de mauvaise interprétation |
| Base de connaissances | Récupération basée sur FAQ vs basée sur documents | Qualité des réponses, taux d'hallucination |
| Politique d'outils | Réserver un créneau immédiatement vs après confirmation | Conversion, erreurs de réservation |
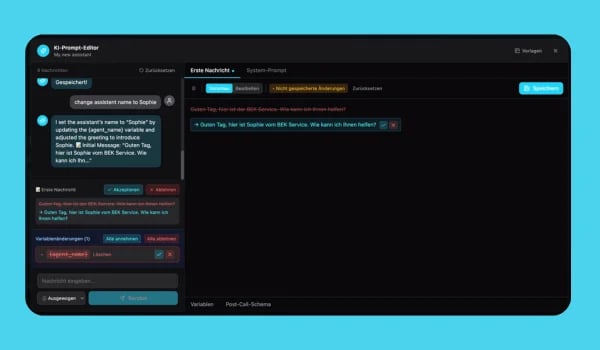
Avec l'éditeur de prompts de Famulor, vous pouvez créer et tester des variantes côte à côte sans toucher à la moindre ligne de code.
Le flux de travail du test A/B : de l'hypothèse au déploiement
Un test A/B structuré pour les agents vocaux suit cinq phases. N'en sautez aucune, chaque phase a son utilité.
Phase 1 : Mesurer votre base de référence
Avant de changer quoi que ce soit, vous avez besoin d'une base de référence propre. Définissez vos scénarios : quels sont les types d'appels les plus courants ? Un atelier de réparation automobile comme Bremer Auto Service à Hambourg gère généralement des demandes de rendez-vous (45 %), des annulations (25 %), des demandes de renseignements sur les services (20 %) et des urgences (10 %). Reflétez cette répartition dans vos scénarios de test.
Définissez votre mix de personas : environ 70 % d'appelants coopératifs, 15 % d'appelants impatients ou frustrés, 10 % d'appelants distraits et 5 % d'appelants avec un accent prononcé. Ce mix reste identique pour les deux variantes.
Avec le tableau de bord des KPI de Famulor, vous pouvez capturer et exporter automatiquement vos métriques de base.
Phase 2 : Modifier une seule variable
Formulez votre hypothèse concrètement : "Si je raccourcis le prompt système de 800 à 400 jetons, la latence diminuera d'au moins 150 ms sans que le taux de résolution ne tombe en dessous de 80 %." Modifiez exactement une variable. Si vous raccourcissez le prompt et changez la voix en même temps, vous ne saurez pas ce qui a fait la différence.
Phase 3 : Exécuter le test
Exécutez les deux variantes sur des scénarios identiques. Répétez chaque scénario au moins 3 fois, idéalement 5. Avec 40 scénarios d'évaluation et une fréquence de 5, cela représente 200 appels de test par variante, un investissement qui se rentabilise par la clarté des résultats.
Pour les tests en trafic réel, utilisez la méthode du déploiement progressif (canary) :
- Étape 0 (Test à blanc) : Les tests synthétiques et les tests de régression doivent être validés.
- Étape 1 (5–10 % du trafic) : Maintenir pendant au moins un cycle commercial.
- Étape 2 (25 %) : Étendre une fois que les cohortes sont comparables.
- Étape 3 (50 %) : Poursuivre le test tant que la métrique principale et les garde-fous sont respectés.
- Étape 4 (100 %) : Déploiement complet après validation documentée.
Phase 4 : Évaluer les résultats
Ne vous contentez pas de comparer le taux de succès global. Utilisez l'ensemble complet des métriques :
| Métrique | Ce qu'elle indique | Signal d'alerte |
|---|---|---|
| Taux de résolution | Le problème de l'appelant a-t-il été résolu ? | En dessous de 75 % : action urgente requise |
| Latence (P50/P95/P99) | Vitesse de réponse | P99 au-dessus de 3 secondes : régression critique |
| Taux d'interruption | Fréquence à laquelle l'agent coupe la parole à l'appelant | Augmentation > 5 % par rapport à la base |
| Taux de confinement | Appels résolus sans transfert à un humain | Baisse alors que la résolution augmente = l'agent escalade moins mais ne résout pas mieux |
| Durée d'appel | Efficacité du dialogue | Appels plus longs à résolution égale = boucles inutiles |
| CSAT / Sentiment | Satisfaction de l'appelant | Gains de précision au détriment du ton |
Cadre de décision : Une variante ne gagne que si la métrique principale s'améliore ET que tous les garde-fous restent dans les limites. Une augmentation du taux de résolution de 72 % à 78 % qui double la latence n'est pas une amélioration, c'est un compromis qui nécessite une évaluation distincte.
Phase 5 : Documenter et itérer
Enregistrez ce qui a été testé, le nombre d'appels effectués, le résultat et la décision prise. Les tests échoués sont aussi précieux que les réussis : ils empêchent l'équipe de répéter la même erreur. Transformez les variantes échouées en tests de régression : le prompt qui a augmenté le taux d'escalade devient un cas de test qui s'exécute automatiquement lors des changements futurs.
Les 5 erreurs les plus courantes dans les tests A/B d'IA vocale
Même les équipes expérimentées tombent régulièrement dans ces pièges :
1. Modifier plusieurs variables à la fois. "Nous avons raccourci le prompt, changé la voix et ajusté la logique d'escalade." Résultat : si les métriques bougent, personne ne sait quel changement en est la cause. Règle : une seule variable par test, toujours.
2. Trop peu de répétitions. Un seul appel de test par scénario traite le bruit comme un signal. Minimum : 3 répétitions, idéalement 5. Pour les agents vocaux, où chaque appel peut se dérouler différemment, ce n'est pas un luxe, c'est une hygiène statistique de base.
3. Scénarios différents entre les variantes. La variante A est testée avec des demandes de rendez-vous simples, la variante B avec des questions de suivi complexes. Les résultats ne sont pas comparables : l'entrée doit être identique.
4. Ne regarder que le taux de succès. Le taux de résolution grimpe de 70 % à 76 %, mais la latence double et le taux d'interruption bondit de 12 %. Sur le tableau de bord, cela ressemble à une amélioration. En réalité, l'expérience d'appel est dégradée.
5. Ne pas mesurer la latence de queue (tail latency). La moyenne est de 800 ms, ce qui est acceptable. Mais le P99 est à 4,2 secondes. Cela signifie qu'un appelant sur cent attend plus de quatre secondes pour une réponse. Mesurez les centiles, pas les moyennes.
Étude de cas : Bremer Auto Service optimise la prise de rendez-vous
Bremer Auto Service, un atelier de réparation automobile à Hambourg, utilise Famulor pour la planification des rendez-vous. Après le lancement initial, le taux de résolution était de 71 %, un bon score, mais insuffisant. L'équipe a mené un test A/B structuré :
Hypothèse : "Si l'agent demande le type de véhicule avant de suggérer des créneaux de rendez-vous, la résolution au premier appel augmentera car le bon atelier sera assigné immédiatement."
Configuration : Variante A (existante) : l'agent demande l'heure souhaitée, puis le véhicule. Variante B (nouvelle) : l'agent demande le véhicule et le problème d'abord, puis propose des créneaux correspondants.
Résultats après 300 appels de test :
- Taux de résolution : 71 % à 83 % (+12 points de pourcentage)
- Latence (P50) : 720 ms à 780 ms (+60 ms, dans la tolérance)
- Durée d'appel : 2:10 min à 1:48 min (−22 secondes, moins de questions de suivi)
- Erreurs de réservation : 8 % à 3 % (−5 points de pourcentage)
Le résultat était sans appel. La variante a été déployée via la fonctionnalité Agent Coach de Famulor, et la base de référence a été mise à jour pour le test suivant.
Tailles d'échantillon : de combien d'appels avez-vous réellement besoin ?
La question de la taille d'échantillon appropriée détermine si vos résultats de test sont fiables ou si vous réagissez simplement au bruit. Valeurs de référence :
| Appels par variante | Fiabilité | Recommandation |
|---|---|---|
| Moins de 100 | Directionnelle uniquement | Pour une évaluation initiale, pas pour des décisions de déploiement |
| 100–500 | Effets importants détectables | Adapté pour des changements de prompt significatifs |
| 500–1,000 | Changements modérés mesurables | Standard pour la plupart des tests |
| Plus de 1 000 | Petites différences statistiquement significatives | Pour le réglage fin (voix, ton) |
Exemple de planification : pour détecter de manière fiable une augmentation du taux de résolution de 70 % à 75 %, vous avez besoin d'environ 1 250 appels par variante. Pour un saut de 70 % à 80 %, environ 300 appels suffisent.
Simulation vs trafic réel : quand utiliser quelle approche ?
Tous les tests ne doivent pas nécessairement impliquer de vrais appelants. La bonne stratégie combine les deux approches :
Tests de simulation (pré-déploiement) : Les deux variantes sont exécutées face à des scénarios synthétiques identiques. Aucun risque pour les vrais appelants, aucune perte de revenus due à des variantes médiocres. Idéal pour les itérations précoces et les changements de prompt majeurs. L'environnement de test intégré de Famulor prend en charge exactement cette approche.
Tests en trafic réel : Les vrais appelants sont répartis entre les variantes. Cela fournit les données les plus réalistes mais comporte des risques : les variantes médiocres coûtent des conversions réelles. À utiliser uniquement après la phase de simulation et une fois qu'un déploiement progressif avec des conditions d'arrêt claires est défini.
Parcours recommandé : Simulation, puis déploiement progressif (5–10 %), puis extension (25 %), puis répartition (50 %), puis déploiement complet (100 %). Chaque étape comporte une condition d'arrêt. Si une métrique de garde-fou est rompue, revenez en arrière, ne débattez pas.
Famulor comme plateforme de test A/B : ce que les outils apportent
Famulor fournit les outils nécessaires pour exécuter l'ensemble du flux de travail de test A/B, sans logiciel externe ni code personnalisé :
- Éditeur de prompts: Créez, versionnez et configurez des variantes de prompts pour vos tests A/B.
- Coach d'agent: Évaluation post-appel avec critères de notation automatisés : ne mesurez pas seulement si l'appel a réussi, mais avec quelle efficacité.
- Tableau de bord des KPI: Taux de résolution, latence, taux de rétention, CSAT et durée des appels en un coup d'œil, avec possibilité de filtrage par variante.
- Environnement de test: Appels de test synthétiques avec scénarios et personas configurables.
- Plus de 300 intégrations: Les données CRM, les systèmes de calendrier et les outils de helpdesk alimentent automatiquement l'évaluation.
Estimez votre ROI en automatisant vos appels
Voyez combien vous pourriez économiser chaque mois grâce aux voice agents IA.
Résultat ROI
ROI 0%
Sans carte bancaire
Conclusion
Le test A/B pour les agents vocaux IA n'est pas une option facultative : c'est la seule méthode permettant de démontrer de manière systématique et reproductible quels changements améliorent votre agent et lesquels le dégradent. La clé réside dans la discipline : une seule variable par test, un nombre suffisant de répétitions, des métriques multidimensionnelles et un cadre décisionnel documenté.
Avec Famulor, vous disposez déjà des outils nécessaires : l'éditeur de prompts, le coach d'agent, le tableau de bord des KPI et l'environnement de test intégré forment une boucle d'optimisation fermée. Commencez dès aujourd'hui votre premier test A/B structuré : mesurez votre base de référence, formulez une hypothèse et testez une seule variable. Les résultats parleront d'eux-mêmes.
Prochaine étape : Créez votre compte Famulor gratuit et configurez votre premier test A/B dans l'éditeur de prompts.
Essayez notre Assistant IA
Découvrez à quel point notre assistant téléphonique IA sonne naturel.
Entrez vos coordonnées et recevez un appel de notre agent IA en quelques secondes.
L'agent est formé pour parler des services Famulor et prendre des rendez-vous.

Agent IA de démo
Représentant Famulor
FAQ
Qu'est-ce que le test A/B pour les agents vocaux IA ?
Le test A/B compare deux variantes d'un agent vocal, différant par une seule variable, face aux mêmes scénarios de test. L'objectif est de prendre des décisions fondées sur des données pour déterminer quelle version offre les meilleurs résultats.
Combien d'appels de test sont nécessaires pour obtenir des résultats significatifs ?
Au moins 100 appels par variante pour obtenir des résultats directionnels. Pour des conclusions statistiquement fiables sur des effets modérés, 500 à 1 000 appels par variante sont recommandés.
Quelles métriques dois-je suivre lors d'un test A/B d'IA vocale ?
Au-delà du taux de résolution comme métrique principale : la latence (P50/P95/P99), le taux d'interruption, le taux de rétention, la durée de l'appel et le CSAT. Une variante ne l'emporte que si toutes les limites de sécurité sont respectées.
Puis-je tester plusieurs variables à la fois ?
Non. Ne modifiez qu'une seule variable par test : prompt, voix, logique d'escalade ou fournisseur STT. Sinon, vous ne pourrez pas attribuer le résultat à un changement spécifique.
Qu'est-ce qu'un déploiement par palier (canary gate) ?
Un déploiement progressif où la nouvelle variante ne reçoit initialement que 5 à 10 % du trafic réel. Si les résultats sont positifs, elle est progressivement étendue à 25 %, 50 % et enfin 100 %. Chaque étape comporte des conditions d'arrêt claires.
En quoi les tests de simulation diffèrent-ils des tests sur trafic réel ?
Les tests de simulation utilisent des scénarios synthétiques sans appelants réels : risque zéro, idéal pour les premières itérations. Les tests sur trafic réel répartissent les appelants réels entre les variantes et fournissent des données plus réalistes, mais comportent un risque de conversion.
Quelles erreurs courantes dois-je éviter lors des tests A/B ?
Les erreurs les plus fréquentes : modifier plusieurs variables à la fois, un nombre insuffisant de répétitions, utiliser des scénarios différents entre les variantes, ne regarder que le taux de succès et ne pas mesurer la latence extrême.
Combien de temps dure un test A/B d'IA vocale typique ?
Un test de simulation avec 200 scénarios se termine en quelques heures. Un test sur trafic réel prend d'une à quatre semaines selon le volume d'appels pour fournir des résultats statistiquement significatifs.
Puis-je utiliser le test A/B pour les agents vocaux sortants également ?
Oui. Les agents sortants bénéficient particulièrement des tests A/B car des variables comme le moment de l'appel, la phrase d'accroche et le script de conversation ont un impact directement mesurable sur les taux de conversion et de prise de rendez-vous.
Famulor propose-t-il des fonctionnalités de test A/B intégrées ?
Oui. Famulor combine l'éditeur de prompts, le coach d'agent, le tableau de bord des KPI et l'environnement de test dans une boucle d'optimisation fermée. Vous pouvez créer, tester et évaluer des variantes sans outils externes.

Rédacteur chez Famulor