Inhalt zusammenfassen mit:




A/B Testing für Voice AI Agents: System Prompts und Gesprächsflüsse datenbasiert optimieren
Ein AI Voice Agent, der beim ersten Rollout perfekt funktioniert, ist die Ausnahme. Die Regel: Unternehmen investieren Wochen in den initialen Prompt, gehen live — und stellen nach 500 Anrufen fest, dass die Task-Completion-Rate bei 68 % stagniert. Der Unterschied zwischen einem durchschnittlichen und einem exzellenten Voice Agent liegt nicht im Modell oder in der TTS-Engine, sondern in der systematischen Optimierung nach dem Launch. A/B Testing ist die Methode, die diesen Unterschied messbar macht.
Dieser Artikel zeigt, wie Sie A/B Tests für Ihre AI-Telefonassistenten planen, durchführen und auswerten — vom isolierten Prompt-Experiment bis zum strukturierten Canary-Rollout mit Guardrail-Metriken. Sie erfahren, welche Variablen sich testen lassen, wie viele Anrufe Sie für belastbare Ergebnisse brauchen und welche Fehler selbst erfahrene Teams regelmäßig machen.
Warum klassisches A/B Testing bei Voice Agents nicht reicht
Wer A/B Testing aus dem Web kennt — Button-Farben, Headline-Varianten, Checkout-Flows — muss bei Voice Agents umdenken. Drei fundamentale Unterschiede machen Voice-Tests komplexer als jede Landing-Page-Optimierung:
Nicht-Determinismus: Derselbe Anrufer mit derselben Frage kann beim identischen Agent zwei unterschiedliche Gesprächsverläufe auslösen. Ein einzelner Testanruf ist eine Stichprobe von eins — statistisch wertlos. Erst ab 3–5 Wiederholungen pro Szenario ergibt sich ein belastbares Bild.
Multi-Turn-Komplexität: Ein Webformular hat einen linearen Pfad. Ein Telefongespräch hat Unterbrechungen, Rückfragen, Themenwechsel und emotionale Dynamik. Eine Prompt-Änderung, die die Begrüßung verbessert, kann die Terminbuchung im dritten Gesprächsschritt verschlechtern.
Mehrdimensionale Metriken: Eine Variante kann die Task Completion steigern und gleichzeitig die Latenz erhöhen, mehr Unterbrechungen verursachen oder den Ton verschlechtern. Wer nur die Erfolgsrate misst, übersieht Regressionen in anderen Dimensionen.
Was sich bei Voice Agents testen lässt: Die 7 Variablen
Effektives A/B Testing beginnt mit einer klaren Isolierung. Ändern Sie pro Test immer nur eine Variable — sonst lässt sich kein Ergebnis zuordnen. Diese sieben Hebel stehen Ihnen zur Verfügung:
| Variable | Beispiel | Typischer Impact |
|---|---|---|
| System Prompt | Kürzerer Prompt vs. detaillierter Prompt | Task Completion, Latenz, Gesprächsdauer |
| Begrüßung | „Guten Tag, Praxis Dr. Weber" vs. „Hallo, hier ist die Praxis, wie kann ich helfen?" | Caller-Engagement, Abbruchrate |
| Eskalationslogik | Nach 2 vs. nach 3 gescheiterten Versuchen an Mensch übergeben | Containment Rate, CSAT |
| TTS-Stimme | Stimme A (warm, langsam) vs. Stimme B (sachlich, schnell) | CSAT, Vertrauenswürdigkeit |
| STT-Provider | Provider A vs. Provider B bei Dialekt-Anrufern | ASR-Genauigkeit, Fehlinterpretationen |
| Knowledge Base | FAQ-basiert vs. Dokument-basiert | Antwortqualität, Halluzinationsrate |
| Tool-Policy | Kalender-Buchung sofort vs. nach Bestätigung | Conversion, Fehlbuchungen |
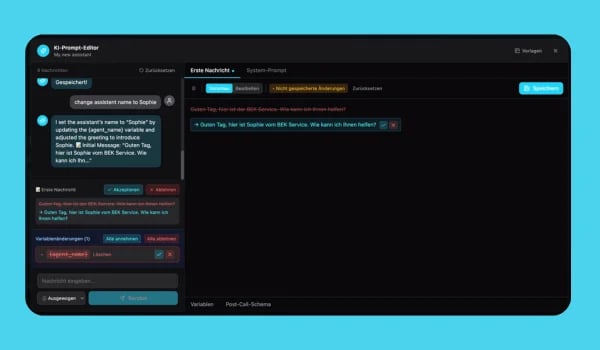
In Famulors Prompt Editor können Sie Varianten direkt nebeneinander anlegen und testen, ohne dass technische Eingriffe nötig sind.
Der A/B-Testing-Workflow: Von der Hypothese zum Rollout
Ein strukturierter A/B Test für Voice Agents durchläuft fünf Phasen. Überspringen Sie keine davon — jede Phase hat eine Funktion.
Phase 1: Baseline messen
Bevor Sie etwas ändern, brauchen Sie eine saubere Baseline. Definieren Sie Ihre Szenarien: Welche Anruftypen kommen am häufigsten vor? Eine Zahnarztpraxis wie Dr. Müller in Düsseldorf hat typischerweise Terminanfragen (45 %), Absagen (25 %), Rückfragen zu Behandlungen (20 %) und Notfälle (10 %). Bilden Sie diese Verteilung in Ihren Testszenarien ab.
Legen Sie Ihre Persona-Mischung fest: Etwa 70 % kooperative Anrufer, 15 % ungeduldige oder frustrierte Anrufer, 10 % abgelenkte Anrufer und 5 % Anrufer mit starkem Akzent. Diese Mischung bleibt für beide Varianten identisch.
Mit Famulors KPI-Dashboard können Sie Ihre Baseline-Metriken automatisch erfassen und exportieren.
Phase 2: Eine Variable ändern
Formulieren Sie Ihre Hypothese konkret: „Wenn ich den System Prompt von 800 auf 400 Tokens kürze, sinkt die Latenz um mindestens 150 ms, ohne dass die Task Completion unter 80 % fällt." Ändern Sie exakt eine Variable. Wenn Sie gleichzeitig den Prompt kürzen und die Stimme wechseln, wissen Sie am Ende nicht, was gewirkt hat.
Phase 3: Test durchführen
Führen Sie beide Varianten gegen identische Szenarien aus. Jedes Szenario mindestens 3-mal, besser 5-mal wiederholen. Bei 40 Evaluierungsszenarien und Frequenz 5 sind das 200 Testanrufe pro Variante — ein Aufwand, der sich durch die Klarheit der Ergebnisse mehr als amortisiert.
Für Live-Traffic-Tests gilt die Canary-Gate-Methode:
- Stufe 0 (Dry Run): Synthetische Tests und Regressionstests müssen bestehen.
- Stufe 1 (5–10 % Traffic): Mindestens einen Geschäftszyklus halten.
- Stufe 2 (25 %): Erweitern, sobald Kohorten vergleichbar sind.
- Stufe 3 (50 %): Split-Test, solange Primary Metric und Guardrails halten.
- Stufe 4 (100 %): Vollständiger Rollout nach dokumentierter Freigabe.
Phase 4: Ergebnisse auswerten
Vergleichen Sie nicht nur die Gesamterfolgsrate. Nutzen Sie das vollständige Metrik-Set:
| Metrik | Was sie zeigt | Warnsignal |
|---|---|---|
| Task Completion | Wurde das Anliegen gelöst? | Unter 75 %: dringender Handlungsbedarf |
| Latenz (P50/P95/P99) | Antwortgeschwindigkeit | P99 über 3 Sekunden: Tail-Regression |
| Unterbrechungsrate | Wie oft spricht der Agent über den Anrufer | Anstieg > 5 % gegenüber Baseline |
| Containment Rate | Wie viele Anrufe ohne menschliche Hilfe gelöst | Sinkend bei steigender Completion = Agent eskaliert weniger, löst aber nicht besser |
| Gesprächsdauer | Effizienz des Dialogs | Längere Gespräche bei gleicher Completion = unnötige Schleifen |
| CSAT / Sentiment | Zufriedenheit des Anrufers | Genauigkeitsgewinn auf Kosten des Tons |
Entscheidungsrahmen: Eine Variante gewinnt nur, wenn die Primary Metric sich verbessert UND alle Guardrails innerhalb der Grenzen bleiben. Ein Anstieg der Task Completion von 72 % auf 78 %, der die Latenz verdoppelt, ist keine Verbesserung — es ist ein Trade-off, der separat bewertet werden muss.
Phase 5: Dokumentieren und iterieren
Halten Sie fest: Was wurde getestet, wie viele Anrufe liefen, was war das Ergebnis, welche Entscheidung wurde getroffen. Gescheiterte Tests sind genauso wertvoll wie erfolgreiche — sie verhindern, dass das Team denselben Fehler erneut macht. Wandeln Sie gescheiterte Varianten in Regressionstests um: Der Prompt, der die Eskalationsrate erhöht hat, wird zum Testfall, der bei zukünftigen Änderungen automatisch geprüft wird.
Die 5 häufigsten Fehler beim Voice AI A/B Testing
Auch erfahrene Teams tappen regelmäßig in diese Fallen:
1. Mehrere Variablen gleichzeitig ändern. „Wir kürzen den Prompt, wechseln die Stimme und passen die Eskalationslogik an." Ergebnis: Wenn sich die Metriken bewegen, weiß niemand, welche Änderung verantwortlich ist. Regel: Eine Variable pro Test, immer.
2. Zu wenige Wiederholungen. Ein einzelner Testanruf pro Szenario behandelt Rauschen als Signal. Minimum: 3 Wiederholungen, besser 5. Bei Voice Agents, wo jeder Anruf anders verlaufen kann, ist das kein Luxus, sondern statistische Grundhygiene.
3. Unterschiedliche Szenarien zwischen Varianten. Variante A wird mit einfachen Terminanfragen getestet, Variante B mit komplexen Rückfragen. Die Ergebnisse sind nicht vergleichbar — der Input muss identisch sein.
4. Nur die Erfolgsrate betrachten. Die Task Completion steigt von 70 % auf 76 %, aber die Latenz verdoppelt sich und die Unterbrechungsrate steigt um 12 %. Im Dashboard sieht es nach einer Verbesserung aus. In der Realität ist das Gesprächserlebnis schlechter.
5. Keine Tail-Latenz messen. Der Durchschnitt liegt bei 800 ms — akzeptabel. Aber das P99 liegt bei 4,2 Sekunden. Das bedeutet: Jeder hundertste Anrufer wartet über vier Sekunden auf eine Antwort. Messen Sie Perzentile, nicht Durchschnitte.
Praxisbeispiel: Autowerkstatt Bremer KFZ-Service optimiert Terminbuchung
Die Autowerkstatt Bremer KFZ-Service in Hamburg setzt Famulor für die Terminbuchung ein. Nach dem Launch lag die Task Completion bei 71 % — gut, aber nicht gut genug. Das Team startete einen strukturierten A/B Test:
Hypothese: „Wenn der Agent nach dem Fahrzeugtyp fragt, bevor er Termine vorschlägt, steigt die First-Call-Resolution, weil der richtige Werkstattbereich sofort zugeordnet wird."
Setup: Variante A (bestehend): Agent fragt nach gewünschtem Termin, dann nach Fahrzeug. Variante B (neu): Agent fragt zuerst nach Fahrzeug und Anliegen, dann bietet er passende Slots an.
Ergebnis nach 300 Testanrufen:
- Task Completion: 71 % → 83 % (+12 Prozentpunkte)
- Latenz (P50): 720 ms → 780 ms (+60 ms, innerhalb der Toleranz)
- Gesprächsdauer: 2:10 Min → 1:48 Min (-22 Sekunden, weil weniger Rückfragen)
- Fehlbuchungen: 8 % → 3 % (-5 Prozentpunkte)
Das Ergebnis war eindeutig. Die Variante wurde über das Famulor Agent Coach-Feature ausgerollt und die Baseline für den nächsten Test aktualisiert.
Stichprobengrößen: Wie viele Anrufe brauchen Sie wirklich?
Die Frage nach der richtigen Stichprobengröße entscheidet darüber, ob Ihre Testergebnisse belastbar sind oder ob Sie auf Rauschen reagieren. Orientierungswerte:
| Anrufe pro Variante | Aussagekraft | Empfehlung |
|---|---|---|
| Unter 100 | Nur richtungsweisend | Für erste Einschätzung, nicht für Rollout-Entscheidungen |
| 100–500 | Große Effekte erkennbar | Geeignet für deutliche Prompt-Änderungen |
| 500–1.000 | Moderate Änderungen messbar | Standard für die meisten Tests |
| Über 1.000 | Kleine Unterschiede statistisch signifikant | Für feine Optimierungen (Stimme, Tonalität) |
Planungsbeispiel: Um einen Anstieg der Task Completion von 70 % auf 75 % zuverlässig zu erkennen, benötigen Sie etwa 1.250 Anrufe pro Variante. Für einen Sprung von 70 % auf 80 % reichen rund 300 Anrufe.
Simulation vs. Live-Traffic: Wann welcher Ansatz?
Nicht jeder Test muss echte Anrufer betreffen. Die richtige Strategie kombiniert beide Ansätze:
Simulations-Tests (Pre-Rollout): Beide Varianten laufen gegen identische synthetische Szenarien. Kein Risiko für echte Anrufer, kein Umsatzverlust bei schlechten Varianten. Ideal für erste Iterationen und größere Prompt-Änderungen. Famulors integrierte Test-Umgebung ermöglicht genau diesen Ansatz.
Live-Traffic-Tests: Echte Anrufer werden zwischen Varianten aufgeteilt. Liefert die realistischsten Daten, birgt aber Risiken: Schlechte Varianten kosten echte Conversions. Nur einsetzen, wenn die Simulation-Phase bestanden ist und ein Canary-Gate mit klaren Stop-Bedingungen definiert wurde.
Empfohlener Pfad: Simulation → Canary (5–10 %) → Erweiterung (25 %) → Split (50 %) → Rollout (100 %). Jede Stufe hat eine Stop-Bedingung. Wenn eine Guardrail-Metrik bricht, wird zurückgerollt — nicht diskutiert.
Famulor als A/B-Testing-Plattform: Was die Werkzeuge leisten
Famulor bringt die notwendigen Werkzeuge mit, um den gesamten A/B-Testing-Workflow abzubilden — ohne externe Tools oder Custom-Code:
- Prompt Editor: Prompt-Varianten erstellen, versionieren und A/B-fähig konfigurieren.
- Agent Coach: Post-Call-Evaluierung mit automatisierten Bewertungskriterien — nicht nur ob der Anruf erfolgreich war, sondern wie gut.
- KPI-Dashboard: Task Completion, Latenz, Containment, CSAT und Gesprächsdauer auf einen Blick — mit Filterung nach Variante.
- Testumgebung: Synthetische Testanrufe mit definierbaren Szenarien und Personas.
- 300+ Integrationen: CRM-Daten, Kalendersysteme und Helpdesk-Tools fließen automatisch in die Auswertung ein.
Berechne deinen ROI durch automatisierte Anrufe
Erfahre, wie viel du durch KI-gesteuerte Voice Agents jeden Monat sparen kannst.
ROI Ergebnis
ROI 0%
Ohne Kreditkarte
Fazit
A/B Testing für Voice AI Agents ist kein optionaler Luxus — es ist die einzige Methode, die systematisch und reproduzierbar zeigt, welche Änderungen Ihren Agent besser machen und welche ihn verschlechtern. Der Schlüssel liegt in der Disziplin: eine Variable pro Test, ausreichend Wiederholungen, mehrdimensionale Metriken und ein dokumentierter Entscheidungsrahmen.
Mit Famulor haben Sie die Werkzeuge dafür bereits an Bord: Prompt Editor, Agent Coach, KPI-Dashboard und integrierte Testumgebung bilden einen geschlossenen Optimierungskreislauf. Starten Sie heute mit Ihrem ersten strukturierten A/B Test — messen Sie Ihre Baseline, formulieren Sie eine Hypothese und testen Sie eine einzige Variable. Die Ergebnisse werden Sie überraschen.
Nächster Schritt: Erstellen Sie Ihren kostenlosen Famulor-Account und richten Sie Ihren ersten A/B Test im Prompt Editor ein.
Teste unseren KI-Assistenten
Erlebe selbst, wie natürlich unser KI-Telefonassistent klingt.
Gib deine Daten ein und erhalte in wenigen Sekunden einen Anruf von unserem KI-Agenten.
Der Agent ist darauf trainiert, über Famulor-Services zu sprechen und Termine zu vereinbaren.

Demo KI-Agent
Famulor Mitarbeiter
FAQ
Was ist A/B Testing bei Voice AI Agents?
A/B Testing vergleicht zwei Varianten eines Voice Agents — die sich in genau einer Variable unterscheiden — anhand derselben Testszenarien. Ziel ist es, datenbasiert zu entscheiden, welche Version bessere Ergebnisse liefert.
Wie viele Testanrufe brauche ich für ein aussagekräftiges Ergebnis?
Mindestens 100 Anrufe pro Variante für richtungsweisende Ergebnisse. Für statistisch belastbare Aussagen bei moderaten Effekten empfehlen sich 500–1.000 Anrufe pro Variante.
Welche Metriken sollte ich bei einem Voice AI A/B Test messen?
Neben der Task Completion als Primary Metric: Latenz (P50/P95/P99), Unterbrechungsrate, Containment Rate, Gesprächsdauer und CSAT. Eine Variante gewinnt nur, wenn alle Guardrails bestehen.
Kann ich mehrere Variablen gleichzeitig testen?
Nein. Ändern Sie pro Test immer nur eine Variable — Prompt, Stimme, Eskalationslogik oder STT-Provider. Sonst lässt sich nicht zuordnen, welche Änderung das Ergebnis verursacht hat.
Was ist ein Canary-Gate-Rollout?
Ein stufenweiser Rollout, bei dem die neue Variante zunächst nur 5–10 % des Live-Traffics erhält. Bei positiven Ergebnissen wird schrittweise auf 25 %, 50 % und schließlich 100 % erweitert. Jede Stufe hat klare Stop-Bedingungen.
Wie unterscheidet sich Simulations-Testing von Live-Traffic-Testing?
Simulations-Tests nutzen synthetische Szenarien ohne echte Anrufer — kein Risiko, ideal für erste Iterationen. Live-Traffic-Tests verteilen echte Anrufer auf Varianten und liefern realistischere Daten, bergen aber Conversion-Risiken.
Welche typischen Fehler sollte ich beim A/B Testing vermeiden?
Die häufigsten Fehler: mehrere Variablen gleichzeitig ändern, zu wenige Wiederholungen, unterschiedliche Szenarien zwischen Varianten, nur die Erfolgsrate betrachten und keine Tail-Latenz messen.
Wie lange dauert ein typischer Voice AI A/B Test?
Ein Simulationstest mit 200 Szenarien ist in wenigen Stunden abgeschlossen. Ein Live-Traffic-Test braucht je nach Anrufvolumen ein bis vier Wochen, um statistisch signifikante Ergebnisse zu liefern.
Kann ich A/B Testing auch für Outbound Voice Agents nutzen?
Ja. Outbound-Agents profitieren besonders von A/B Tests, weil Variablen wie Anrufzeitpunkt, Eröffnungssatz und Gesprächsskript direkt messbar auf Conversion und Terminquote wirken.
Bietet Famulor integrierte A/B-Testing-Funktionen?
Ja. Famulor kombiniert Prompt Editor, Agent Coach, KPI-Dashboard und Testumgebung zu einem geschlossenen Optimierungskreislauf. Sie können Varianten anlegen, testen und auswerten — ohne externe Tools.

Autor bei Famulor