Resumir contenido con:




Pruebas A/B para agentes de voz con IA: cómo optimizar prompts y flujos de llamadas con datos
Un agente de voz con IA que funciona a la perfección desde el primer día es la excepción, no la regla. La mayoría de las empresas invierten semanas en redactar el prompt inicial, lo ponen en marcha y, tras 500 llamadas, descubren que su tasa de resolución de tareas se ha estancado en el 68%. La diferencia entre un agente de voz mediocre y uno excepcional no reside en el modelo ni en el motor TTS. Es la optimización sistemática que ocurre después del lanzamiento. Las pruebas A/B son el método que hace que esta diferencia sea medible.
Esta guía te explica cómo planificar, ejecutar y evaluar pruebas A/B para asistentes telefónicos con IA, desde experimentos aislados con prompts hasta despliegues canary estructurados con métricas de control. Aprenderás qué variables probar, cuántas llamadas necesitas para obtener resultados fiables y qué errores siguen cometiendo incluso los equipos experimentados.
Por qué las pruebas A/B tradicionales no bastan para los agentes de voz
Si conoces las pruebas A/B del mundo web —colores de botones, variantes de titulares, flujos de pago—, los agentes de voz requieren una mentalidad fundamentalmente distinta. Tres características hacen que las pruebas de voz sean más complejas que la optimización de cualquier página de aterrizaje:
No determinismo: La misma persona que llama con la misma pregunta puede desencadenar dos rutas de conversación totalmente distintas con el mismo agente. Una sola llamada de prueba es una muestra de tamaño uno, estadísticamente insignificante. Solo tras 3 a 5 repeticiones por escenario surge un patrón fiable.
Complejidad multironda: Un formulario web sigue una ruta lineal. Una conversación telefónica tiene interrupciones, preguntas de seguimiento, cambios de tema y dinámicas emocionales. Un cambio en el prompt que mejora el saludo puede degradar la reserva de citas tres turnos después.
Métricas multidimensionales: Una variante puede aumentar la resolución de tareas y, al mismo tiempo, aumentar la latencia, provocar más interrupciones o empeorar el tono. Si solo mides la tasa de éxito, pasarás por alto regresiones en otras dimensiones.
Qué puedes probar en los agentes de voz: las 7 variables
Una prueba A/B eficaz comienza con un aislamiento claro. Cambia solo una variable por prueba; de lo contrario, no podrás atribuir el resultado a nada. Tienes a tu disposición estas siete palancas:
| Variable | Ejemplo | Impacto típico |
|---|---|---|
| System Prompt | Prompt corto frente a prompt detallado | Resolución de tareas, latencia, duración de la llamada |
| Saludo | "Buenos días, consulta del Dr. Weber" frente a "Hola, ¿en qué puedo ayudarte hoy?" | Interacción del usuario, tasa de abandono |
| Lógica de escalado | Transferencia a un humano tras 2 frente a 3 intentos fallidos | Tasa de contención, CSAT |
| Voz TTS | Voz A (cálida, lenta) frente a Voz B (neutral, rápida) | CSAT, fiabilidad percibida |
| Proveedor STT | Proveedor A frente a Proveedor B para usuarios con acento | Precisión ASR, tasa de malinterpretación |
| Base de conocimientos | Recuperación basada en FAQ frente a basada en documentos | Calidad de respuesta, tasa de alucinación |
| Política de herramientas | Reservar cita inmediatamente frente a reservar tras confirmación | Conversión, errores de reserva |
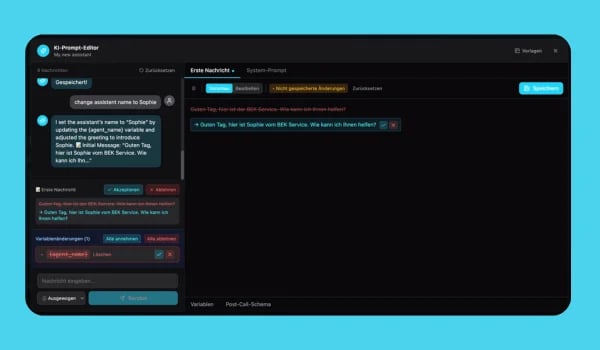
Con el Editor de Prompts de Famulor, puedes crear y probar variantes una al lado de la otra sin tocar una sola línea de código.
El flujo de trabajo de las pruebas A/B: de la hipótesis al despliegue
Una prueba A/B estructurada para agentes de voz sigue cinco fases. No te saltes ninguna: cada una tiene su propósito.
Fase 1: mide tu línea base
Antes de cambiar nada, necesitas una línea base clara. Define tus escenarios: ¿cuáles son los tipos de llamada más comunes? Un taller mecánico como Bremer Auto Service en Hamburgo suele gestionar solicitudes de cita (45%), cancelaciones (25%), consultas de servicio (20%) y emergencias (10%). Refleja esta distribución en tus escenarios de prueba.
Establece tu mezcla de perfiles: aproximadamente un 70% de usuarios cooperativos, 15% impacientes o frustrados, 10% distraídos y 5% con acentos marcados. Esta mezcla debe ser idéntica para ambas variantes.
Con el Panel de KPI de Famulor, puedes capturar y exportar tus métricas base automáticamente.
Fase 2: cambia una variable
Plantea tu hipótesis de forma concreta: "Si acorto el system prompt de 800 a 400 tokens, la latencia se reducirá al menos 150 ms sin que la resolución de tareas caiga por debajo del 80%". Cambia exactamente una variable. Si acortas el prompt y cambias la voz al mismo tiempo, no sabrás qué causó la diferencia.
Fase 3: ejecuta la prueba
Ejecuta ambas variantes con escenarios idénticos. Repite cada escenario al menos 3 veces, idealmente 5. Con 40 escenarios de evaluación y una frecuencia de 5, eso supone 200 llamadas de prueba por variante: una inversión que se paga sola gracias a la claridad de los resultados.
Para pruebas con tráfico real, utiliza el método de puerta canary:
- Etapa 0 (Prueba en seco): Las pruebas sintéticas y de regresión deben superarse.
- Etapa 1 (5–10% del tráfico): Mantener durante al menos un ciclo de negocio.
- Etapa 2 (25%): Ampliar una vez que las cohortes sean comparables.
- Etapa 3 (50%): Dividir la prueba mientras la métrica principal y los controles se mantengan.
- Etapa 4 (100%): Despliegue completo tras la aprobación documentada.
Fase 4: evalúa los resultados
No te limites a comparar la tasa de éxito general. Utiliza el conjunto completo de métricas:
| Métrica | Qué muestra | Señal de advertencia |
|---|---|---|
| Resolución de tareas | ¿Se resolvió el problema del usuario? | Por debajo del 75%: acción urgente necesaria |
| Latencia (P50/P95/P99) | Velocidad de respuesta | P99 superior a 3 segundos: regresión en la cola |
| Tasa de interrupción | Con qué frecuencia el agente interrumpe al usuario | Aumento > 5% sobre la línea base |
| Tasa de contención | Llamadas resueltas sin intervención humana | Si cae mientras la resolución sube = el agente escala menos pero no resuelve mejor |
| Duración de la llamada | Eficiencia del diálogo | Llamadas más largas con igual resolución = bucles innecesarios |
| CSAT / Sentimiento | Satisfacción del usuario | Ganancias de precisión a costa del tono |
Marco de decisión: Una variante gana solo si la métrica principal mejora Y todos los controles se mantienen dentro de los límites. Un aumento en la resolución de tareas del 72% al 78% que duplica la latencia no es una mejora: es un compromiso que requiere una evaluación por separado.
Fase 5: documenta e itera
Registra qué se probó, cuántas llamadas se realizaron, el resultado y la decisión tomada. Las pruebas fallidas son tan valiosas como las exitosas: evitan que el equipo repita el mismo error. Convierte las variantes fallidas en pruebas de regresión: el prompt que aumentó la tasa de escalado se convierte en un caso de prueba que se ejecuta automáticamente frente a futuros cambios.
Los 5 errores más comunes en las pruebas A/B de IA de voz
Incluso los equipos experimentados caen en estas trampas habitualmente:
1. Cambiar varias variables a la vez. "Acortamos el prompt, cambiamos la voz y ajustamos la lógica de escalado". Resultado: si las métricas se mueven, nadie sabe qué cambio lo provocó. Regla: una variable por prueba, siempre.
2. Muy pocas repeticiones. Una sola llamada de prueba por escenario trata el ruido como señal. Mínimo: 3 repeticiones, idealmente 5. Para agentes de voz, donde cada llamada puede desarrollarse de forma distinta, esto no es un lujo, es higiene estadística básica.
3. Escenarios diferentes entre variantes. La variante A se prueba con solicitudes de cita simples, la variante B con preguntas de seguimiento complejas. Los resultados no son comparables: la entrada debe ser idéntica.
4. Mirar solo la tasa de éxito. La resolución de tareas sube del 70% al 76%, pero la latencia se duplica y la tasa de interrupción salta un 12%. En el panel parece una mejora. En realidad, la experiencia de llamada es peor.
5. No medir la latencia de cola. El promedio es de 800 ms, aceptable. Pero el P99 se sitúa en 4,2 segundos. Eso significa que uno de cada cien usuarios espera más de cuatro segundos para obtener una respuesta. Mide percentiles, no promedios.
Caso práctico: Bremer Auto Service optimiza la reserva de citas
Bremer Auto Service, un taller mecánico en Hamburgo, utiliza Famulor para la programación de citas. Tras el lanzamiento inicial, la resolución de tareas se situaba en el 71%: bien, pero no lo suficiente. El equipo realizó una prueba A/B estructurada:
Hipótesis: "Si el agente pregunta por el tipo de vehículo antes de sugerir franjas horarias, la resolución en la primera llamada aumentará porque se asigna inmediatamente el taller adecuado".
Configuración: Variante A (existente): el agente pide la hora preferida, luego el vehículo. Variante B (nueva): el agente pide primero el vehículo y el problema, luego ofrece franjas coincidentes.
Resultados tras 300 llamadas de prueba:
- Resolución de tareas: del 71% al 83% (+12 puntos porcentuales)
- Latencia (P50): de 720 ms a 780 ms (+60 ms, dentro de la tolerancia)
- Duración de la llamada: de 2:10 min a 1:48 min (-22 segundos, menos preguntas de seguimiento)
- Errores de reserva: del 8% al 3% (-5 puntos porcentuales)
El resultado fue claro. La variante se desplegó mediante la función Agent Coach de Famulor, y la línea base se actualizó para la siguiente prueba.
Tamaños de muestra: ¿cuántas llamadas necesitas realmente?
La cuestión del tamaño de muestra adecuado determina si tus resultados son fiables o si estás reaccionando al ruido. Valores de referencia:
| Llamadas por variante | Fiabilidad | Recomendación |
|---|---|---|
| Menos de 100 | Solo direccional | Para evaluación inicial, no para decisiones de despliegue |
| 100–500 | Efectos grandes detectables | Adecuado para cambios significativos en el prompt |
| 500–1,000 | Cambios moderados medibles | Estándar para la mayoría de las pruebas |
| Más de 1.000 | Diferencias pequeñas estadísticamente significativas | Para ajustes finos (voz, tono) |
Ejemplo de planificación: para detectar de forma fiable un aumento en la resolución de tareas del 70% al 75%, necesitas aproximadamente 1.250 llamadas por variante. Para un salto del 70% al 80%, bastan unas 300 llamadas.
Simulación frente a tráfico real: cuándo usar cada enfoque
No todas las pruebas necesitan involucrar a usuarios reales. La estrategia correcta combina ambos enfoques:
Pruebas de simulación (pre-despliegue): Ambas variantes se ejecutan frente a escenarios sintéticos idénticos. Sin riesgo para los usuarios reales, sin pérdida de ingresos por variantes deficientes. Ideal para iteraciones tempranas y cambios importantes en el prompt. El entorno de pruebas integrado de Famulor admite exactamente este enfoque.
Pruebas con tráfico real: Los usuarios reales se dividen entre las variantes. Esto ofrece los datos más realistas, pero conlleva riesgos: las variantes deficientes cuestan conversiones reales. Úsalo solo después de superar la fase de simulación y tras definir una puerta canary con condiciones de parada claras.
Ruta recomendada: Simulación, luego canary (5–10%), luego ampliar (25%), luego dividir (50%), luego despliegue completo (100%). Cada etapa tiene una condición de parada. Si una métrica de control falla, revierte el cambio; no lo debatas.
Famulor como tu plataforma de pruebas A/B: qué ofrecen las herramientas
Famulor proporciona las herramientas necesarias para ejecutar todo el flujo de trabajo de pruebas A/B, sin software externo ni código personalizado:
- Editor de prompts: Crea, versiona y configura variantes de prompts para pruebas A/B.
- Entrenador de agentes: Evaluación post-llamada con criterios de puntuación automatizados: no solo si la llamada tuvo éxito, sino qué tan bien se desarrolló.
- Panel de KPI: Visualización rápida de la finalización de tareas, latencia, contención, CSAT y duración de la llamada, filtrable por variante.
- Entorno de pruebas: Llamadas de prueba sintéticas con escenarios y perfiles configurables.
- Más de 300 integraciones: Los datos de CRM, sistemas de calendario y herramientas de helpdesk se integran automáticamente en la evaluación.
Calcula tu ROI automatizando llamadas
Descubre cuánto podrías ahorrar al usar voice agents con IA.
Resultado ROI
ROI 0%
Sin tarjeta de crédito
Conclusión
Las pruebas A/B para agentes de voz con IA no son un extra opcional; son el único método que demuestra de forma sistemática y reproducible qué cambios mejoran tu agente y cuáles lo empeoran. La clave es la disciplina: una variable por prueba, suficientes repeticiones, métricas multidimensionales y un marco de decisión documentado.
Con Famulor, ya tienes las herramientas necesarias: el Editor de prompts, el Entrenador de agentes, el Panel de KPI y el entorno de pruebas integrado forman un ciclo de optimización cerrado. Empieza hoy mismo con tu primera prueba A/B estructurada: mide tu línea base, formula una hipótesis y prueba una sola variable. Los resultados hablarán por sí solos.
Siguiente paso: Crea tu cuenta gratuita de Famulor y configura tu primera prueba A/B en el Editor de prompts.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.

Agente IA de demo
Representante de Famulor
Preguntas frecuentes
¿Qué es una prueba A/B para agentes de voz con IA?
Las pruebas A/B comparan dos variantes de un agente de voz, que difieren exactamente en una variable, frente a los mismos escenarios de prueba. El objetivo es tomar decisiones basadas en datos sobre qué versión ofrece mejores resultados.
¿Cuántas llamadas de prueba necesito para obtener resultados significativos?
Al menos 100 llamadas por variante para obtener resultados orientativos. Para conclusiones estadísticamente fiables sobre efectos moderados, se recomiendan entre 500 y 1.000 llamadas por variante.
¿Qué métricas debo seguir en una prueba A/B de IA de voz?
Más allá de la finalización de tareas como métrica principal: latencia (P50/P95/P99), tasa de interrupción, tasa de contención, duración de la llamada y CSAT. Una variante solo gana si cumple con todos los parámetros de control.
¿Puedo probar varias variables a la vez?
No. Cambia solo una variable por prueba: el prompt, la voz, la lógica de escalado o el proveedor de STT. De lo contrario, no podrás atribuir qué cambio causó el resultado.
¿Qué es un despliegue tipo canary gate?
Un despliegue por etapas donde la nueva variante recibe inicialmente solo entre el 5% y el 10% del tráfico real. Si los resultados son positivos, se amplía gradualmente al 25%, 50% y, finalmente, al 100%. Cada etapa tiene condiciones de parada claras.
¿En qué se diferencian las pruebas de simulación de las pruebas con tráfico real?
Las pruebas de simulación utilizan escenarios sintéticos sin llamadas reales; es decir, riesgo cero, ideal para iteraciones tempranas. Las pruebas con tráfico real dividen a los interlocutores reales entre las variantes y ofrecen datos más realistas, pero conllevan un riesgo de conversión.
¿Qué errores comunes debo evitar en las pruebas A/B?
Los errores más comunes: cambiar varias variables a la vez, realizar muy pocas repeticiones, utilizar escenarios diferentes entre variantes, fijarse solo en la tasa de éxito y no medir la latencia de cola.
¿Cuánto dura una prueba A/B típica de IA de voz?
Una prueba de simulación con 200 escenarios finaliza en unas pocas horas. Una prueba con tráfico real requiere de una a cuatro semanas, dependiendo del volumen de llamadas, para ofrecer resultados estadísticamente significativos.
¿Puedo usar pruebas A/B también para agentes de voz salientes?
Sí. Los agentes salientes se benefician especialmente de las pruebas A/B porque variables como el momento de la llamada, la frase de apertura y el guion de la conversación tienen un impacto directamente medible en la conversión y en la tasa de citas.
¿Ofrece Famulor funciones integradas de pruebas A/B?
Sí. Famulor combina el Editor de prompts, el Entrenador de agentes, el Panel de KPI y el entorno de pruebas en un ciclo de optimización cerrado. Puedes crear, probar y evaluar variantes sin necesidad de herramientas externas.

Autor en Famulor