Inhoud samenvatten met:




TTS en STT uitgelegd: De twee helften van elke spraakgestuurde agent
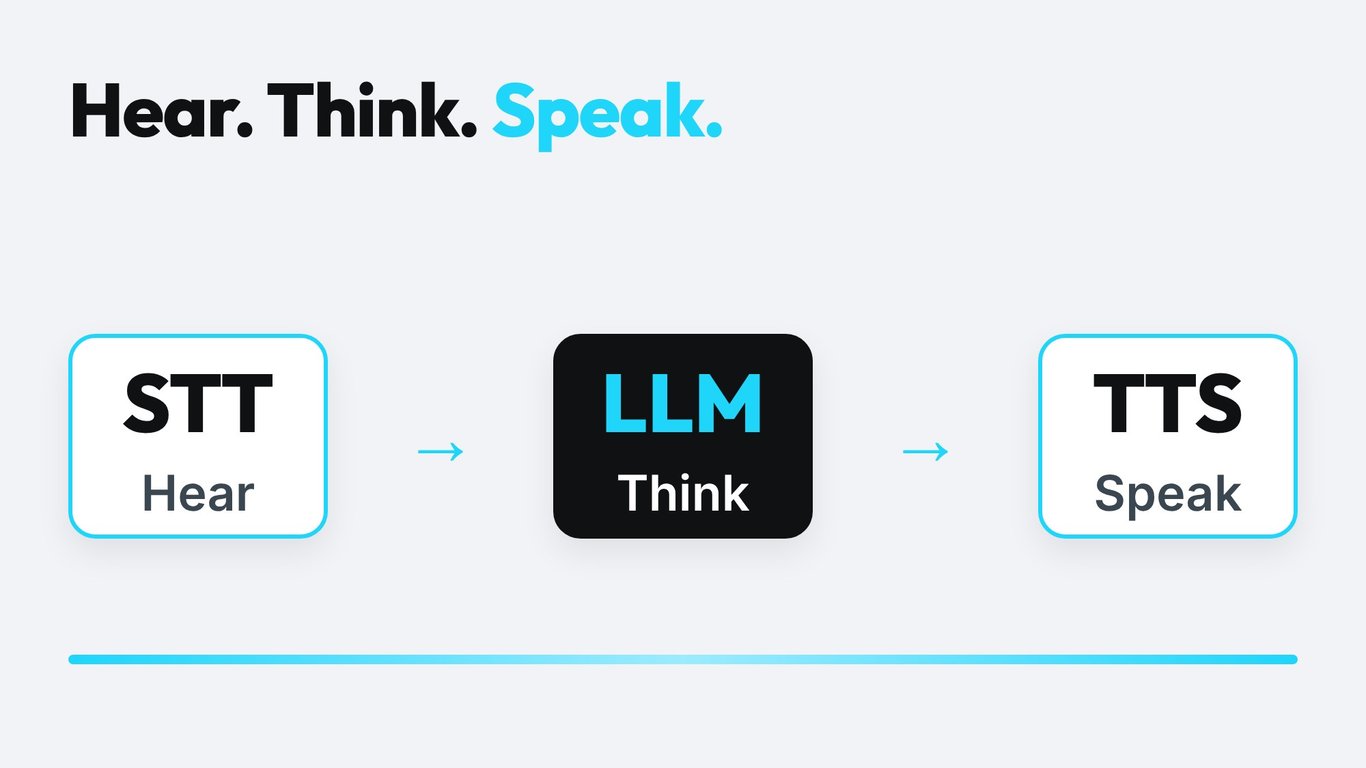
Als je hebt gezocht op "TTS" of "STT betekenis" en hier bent beland, is dit het korte antwoord: STT staat voor speech-to-text (spraak-naar-tekst) (de agent luistert) en TTS staat voor text-to-speech (tekst-naar-spraak) (de agent spreekt). Elke AI-telefoonagent die je belt, is gebouwd op deze twee taken, met een taalmodel in het midden dat beslist wat er gezegd moet worden. Deze gids legt uit wat elk onderdeel doet, waar gesprekken misgaan en hoe je de juiste opzet kiest voor jouw bedrijf.
Wat betekenen TTS en STT?
STT (speech-to-text) wordt ook wel automatische spraakherkenning (ASR) of transcriptie genoemd. Het neemt een audiostream en zet deze om in woorden. In een spraakgestuurde agent draait dit continu terwijl de beller praat en stuurt het gedeeltelijke tekst naar de volgende stap.
TTS (text-to-speech) is spraaksynthese. Het neemt de tekst die het taalmodel heeft geschreven en produceert audio in een gekozen stem, taal en stijl. In een spraakgestuurde agent begint het al met spreken voordat de hele zin af is, zodat de beller niet hoeft te wachten.
De twee worden vaak verward met stemklonen, stemvervormers of "AI-stemmen" in het algemeen. Dat zijn functies die boven op TTS zijn gebouwd. STT heeft zelf geen stem: het luistert alleen.
| Term | Volledige naam | Input | Output | Taak in een spraakgestuurde agent |
|---|---|---|---|---|
| STT | Speech-to-text (ASR) | Audio van beller | Tekst | Begrijpen wat er werd gezegd |
| LLM | Large language model | Tekst en context | Tekst | Antwoord bepalen en tools aanroepen |
| TTS | Text-to-speech | Tekst | Audio | Antwoord uitspreken met een natuurlijke stem |
| S2S | Speech-to-speech | Audio van beller | Audio | Alle drie de stappen in één model uitvoeren |
Hoe een telefoongesprek door STT, LLM en TTS stroomt
Neem een tandartspraktijk met vier behandelkamers. Een patiënt belt en zegt: "Ik moet mijn afspraak voor de gebitsreiniging verplaatsen van dinsdag naar donderdag." Dit is wat er in ongeveer één seconde gebeurt:
- Het telefoonnetwerk levert audio aan het agentplatform.
- STT streamt de audio naar tekst terwijl de patiënt nog aan het praten is.
- Een endpointing-check bepaalt of de patiënt de zin heeft afgemaakt.
- Het taalmodel leest de tekst, controleert de agenda via een tool en schrijft een antwoord.
- TTS zet de eerste woorden van het antwoord om in audio en streamt deze terug.
- De patiënt hoort het antwoord en kan op elk moment onderbreken, wat de TTS-stream annuleert en terugkeert naar stap 2.
Elke stap voegt vertraging toe en elke stap kan op zijn eigen manier falen. STT kan een naam verkeerd verstaan. Het model kan de verkeerde plek kiezen. TTS kan een straatnaam verkeerd uitspreken. Weten welk onderdeel faalde, is de eerste stap om het te verhelpen. De gesprekslogs van Famulor tonen het transcript naast het antwoord van de agent, zodat je kunt zien of het probleem lag bij het horen, het denken of het spreken.
Waarom telefoonaudio lastiger is dan een podcast
De meeste spraakmodellen worden gedemonstreerd met schone studio-audio. Telefoongesprekken zijn anders. Traditionele telefoonlijnen gebruiken de G.711-codec met een samplefrequentie van 8 kHz, wat hoge frequenties afsnijdt. Medeklinkers zoals "s", "f" en "th" worden moeilijker van elkaar te onderscheiden, en dat is precies waar namen, nummers en e-mailadressen fout gaan. Breedbandaudio zoals G.722 gebruikt 16 kHz en behoudt meer detail, maar alleen als beide kanten van het gesprek dit ondersteunen.
De grafiek laat zien waarom een model dat goed scoort op podcast-audio toch moeite kan hebben met een gewoon telefoongesprek: het ontvangt slechts een fractie van de informatie. Wanneer je STT test, test het dan altijd op opnames van je eigen telefoonlijn, met je eigen accenten, achtergrondgeluiden en vocabulaire.
Speech-to-Text in detail
Wat bepaalt de STT-kwaliteit bij gesprekken
- Accent- en taaldekking: Duitse dialecten, Zwitserduits en het wisselen tussen talen (code-switching) blijven voor veel modellen zwakke punten.
- Vocabulaire: productnamen, achternamen en medische of juridische termen. Veel aanbieders laten je trefwoorden of aangepaste vocabulaire toevoegen.
- Getallen en formaten: telefoonnummers, IBAN's, postcodes en datums. Eén verkeerd cijfer maakt een boeking onbruikbaar.
- Omgaan met ruis: auto's, werkplaatsen, keukens en luidsprekers.
- Streaminggedrag: hoe snel gedeeltelijke woorden verschijnen en hoe stabiel ze zijn.
Woordfoutpercentage is niet het hele verhaal
Het woordfoutpercentage (WER) telt verkeerde, ontbrekende en extra woorden ten opzichte van een referentietranscript. Het is nuttig om modellen te vergelijken, maar een lage WER kan de fouten verhullen die er echt toe doen. Het woord "niet" missen of "15" en "50" verwarren telt hetzelfde als het missen van "de". Voor een spraakgestuurde agent is entiteitsnauwkeurigheid (namen, nummers, datums) vaak de betere maatstaf. We hebben dit uitgebreid behandeld in ons STT-benchmarkartikel.
Streaming versus batch
Batch-STT wacht op de volledige opname en geeft een gepolijst transcript terug. Dat is perfect voor gespreksverslagen en kwaliteitscontrole. Streaming-STT geeft woorden terug zodra ze worden uitgesproken, wat de enige optie is voor een live gesprek. Veel aanbieders bieden beide aan, waarbij streaming meestal een beetje nauwkeurigheid inruilt voor snelheid.
Endpointing en onderbrekingen
Endpointing bepaalt wanneer de beller is uitgesproken. Te vroeg, en de agent onderbreekt mensen midden in een zin. Te laat, en elk antwoord voelt traag aan. Goede agents combineren stiltedetectie met de betekenis van de zin: "Mijn nummer is 0151..." is duidelijk nog niet klaar, zelfs niet na een pauze. Barge-in (de beller laten onderbreken) hangt af van dezelfde logica.
Text-to-Speech in detail
Wat maakt dat een TTS-stem goed klinkt
- Natuurlijkheid: ritme, ademhaling en klemtoon die overeenkomen met hoe mensen praten.
- Prosodiecontrole: vragen die omhoog gaan, korte pauzes voor belangrijke feiten, kalme toon voor slecht nieuws.
- Uitspraak: merknamen, straatnamen, afkortingen en woorden uit verschillende talen. Uitspraakwoordenboeken lossen het meeste hiervan op.
- Tijd tot eerste audio: hoe snel de eerste lettergreep arriveert nadat de tekst is verzonden.
- Consistentie: dezelfde stem bij gesprek 1 en gesprek 10.000.
Stemklonen en toestemming
Veel TTS-aanbieders bieden klonen aan op basis van een kort fragment. Kloon alleen stemmen van mensen die schriftelijke toestemming hebben gegeven en vertel bellers dat ze met een AI spreken. In de EU is transparantie over AI-interactie onderdeel van de AI Act, en het opnemen of verwerken van stemgegevens valt onder de AVG. Onze AVG-gids voor AI-spraakagents behandelt de details.
De stem afstemmen op de taak
Een ambachtelijk bedrijf dat spoedoproepen aanneemt, heeft een kalme, heldere stem nodig. Een hotelreceptie wil misschien een warmere toon. Een betalingsherinnering heeft een neutrale, beleefde stem nodig. Luister naar voorbeelden in je eigen taal, met je eigen zinnen, voordat je beslist. De Famulor-stemmenbibliotheek laat je stemmen van verschillende aanbieders vergelijken.
Latentie: Waar de vertraging vandaan komt
Bellers merken stilte snel op. De totale vertraging is de som van het netwerk, het einde van de beurt van de beller, de denktijd van het model en de eerste audio van het antwoord. Elke STT- en TTS-aanbieder draagt bij aan die som, en daarom hebben we een aparte gids geschreven over hoe snel je telefoonbot moet antwoorden.
Praktische manieren om vertraging te verminderen zonder kwaliteitsverlies:
- Gebruik streaming STT en streaming TTS, nooit batch, voor live gesprekken.
- Kies aanbieders met servers dicht bij je telefonieprovider.
- Houd prompts en tool-outputs kort zodat het model sneller antwoordt.
- Gebruik korte opvulzinnen ("Een momentje, ik controleer de agenda") terwijl een tool draait.
- Stem endpointing af in plaats van vaste pauzes toe te voegen.
Cascaded pipeline of speech-to-speech?
De klassieke opzet schakelt STT, LLM en TTS aaneen. Nieuwere speech-to-speech (S2S) modellen nemen audio in en geven audio uit in één enkel model. Beide hebben hun plek. Ons overzicht van speech-to-speech-modellen gaat dieper in op de materie.
| Criterium | Cascaded (STT + LLM + TTS) | Speech-to-speech |
|---|---|---|
| Controle over elke stap | Hoog: wissel elk onderdeel uit | Lager: één model doet alles |
| Transcript voor logs en QA | Natief | Vereist een aparte transcriptie |
| Stemkeuze | Honderden TTS-stemmen | Beperkt tot de stemmen van het model |
| Toon en onderbrekingen | Afhankelijk van afstemming | Vaak natuurlijker |
| Tool-aanroepen en regels | Volwassen en voorspelbaar | Verbetert snel |
| Een slecht gesprek debuggen | Controleer elke stap | Moeilijker te isoleren |
Voor gereguleerde of kritieke gesprekken zoals afspraken, betalingen of claims, geven veel teams nog steeds de voorkeur aan de cascaded opzet omdat elke stap zichtbaar en vervangbaar is. Voor informele, conversatiegerichte use cases kan S2S natuurlijker aanvoelen.
Hoe kies je STT- en TTS-aanbieders?
Gebruik een korte scorekaart en weeg deze op basis van je use case:
- Taal- en accentdekking voor je echte bellers.
- Nauwkeurigheid bij entiteiten: namen, nummers, datums.
- Streaming-latentie voor STT en tijd tot eerste audio voor TTS.
- Stemkwaliteit en controle voor TTS.
- Gegevensverwerking: regio, retentie, training op jouw data, DPA.
- Prijs per minuut of per teken bij jouw gespreksvolume.
- Betrouwbaarheid: uptime en fallback-opties.
We hebben stapsgewijze gidsen geschreven voor beide kanten: hoe kies je een STT-aanbieder en hoe kies je een TTS-aanbieder. Famulor ondersteunt aanbieders zoals Deepgram, Soniox, ElevenLabs en Cartesia, zodat je er verschillende kunt testen met hetzelfde script.
Wat kosten STT en TTS in een spraakgestuurde agent?
Een minuut van een spraakgestuurde agent bestaat uit telefonie, STT, LLM en TTS. Aanbieders factureren in verschillende eenheden: STT meestal per audiominuut of uur, TTS per teken of per audiominuut, LLM's per token. Vergelijken is makkelijker als je alles omrekent naar kosten per gespreksminuut voor je eigen belpatroon. Lange antwoorden van de agent kosten meer TTS dan korte, en lange monologen van de beller kosten meer STT.
Bij Famulor betaal je één prijs per minuut in plaats van losse facturen van verschillende aanbieders. Pay-as-you-go begint bij € 0,15 per minuut en abonnementen zoals Plus bevatten 100 minuten, met extra minuten voor € 0,12. Bekijk de huidige tarieven op de prijzenpagina.
Bereken je ROI met geautomatiseerde gesprekken
Ontdek hoeveel je per maand bespaart via AI voice agents.
ROI Resultaat
ROI 0%
Geen creditcard nodig
Drie voorbeelden: welke configuratie past bij welke klus?
Afspraken boeken voor een tandartspraktijk
Namen en datums zijn cruciaal. Kies een STT met een hoge nauwkeurigheid voor entiteiten en een aangepaste woordenlijst voor behandelingen, gecombineerd met een rustige, heldere TTS-stem. Voeg een bevestiging toe door de gegevens te herhalen: "Donderdag om 10:30, klopt dat?"
Bereikbaarheid buiten kantooruren voor een loodgietersbedrijf
Bellers zijn gestrest en bevinden zich vaak in rumoerige omgevingen. Geef prioriteit aan een STT die goed omgaat met achtergrondgeluid en een korte, geruststellende TTS-stem. Houd antwoorden beknopt en verzamel eerst het adres en de urgentie.
Uitgaande herinneringen voor een sportschool
Uitgaande gesprekken beginnen met een snelle begroeting, dus de tijd tot het eerste audiofragment van de TTS is hierbij essentieel. De STT hoeft meestal alleen ja, nee en enkele datums te herkennen. Een stack in het middensegment volstaat meestal.
STT en TTS instellen in Famulor
- Maak een assistent aan met de no-code voice agent builder.
- Kies de taal en een stem, en luister naar een voorbeeld.
- Kies het transcriptiemodel dat past bij jouw taal en het niveau van achtergrondgeluid.
- Voeg uitspraakinstructies en een aangepaste woordenlijst toe voor je merk- en plaatsnamen.
- Voer gesimuleerde en echte testgesprekken uit en lees daarna de transcripties.
- Wijzig telkens één instelling en vergelijk de resultaten.
Controleer de ondersteunde talen voordat je een stem kiest.
Veelgemaakte fouten
- Een stem kiezen op basis van een studiodemo zonder deze ooit op een telefoonlijn te testen.
- De STT beoordelen op basis van één algemeen nauwkeurigheidscijfer.
- De uitspraak van de bedrijfsnaam negeren.
- Het herhalen van getallen en datums ter bevestiging overslaan.
- De agent lange alinea's laten uitspreken. Korte zinnen klinken beter en kosten minder TTS-tegoed.
Conclusie
STT en TTS zijn de oren en de stem van je AI-telefoonassistent. Hoe beter ze aansluiten bij je bellers, taal en gebruiksdoel, des te meer gesprekken de agent zonder menselijke tussenkomst afrondt. Test beide op echte opnames, houd de latentie laag met streaming en verander telkens één ding tegelijk. Klaar om het verschil te horen met je eigen script? Begin met de live demo hieronder en bouw daarna je eerste assistent in Famulor.
Probeer onze AI-assistent
Ervaar hoe natuurlijk onze AI-telefoonassistent klinkt.
Vul je gegevens in en ontvang binnen enkele seconden een oproep van onze AI-agent.
De agent is getraind om over Famulor-diensten te praten en afspraken te maken.

Demo AI-agent
Famulor medewerker
Veelgestelde vragen
Wat betekent TTS?
TTS staat voor text-to-speech. Het zet geschreven tekst om in gesproken audio en genereert in een voice agent de gesproken antwoorden van de agent.
Wat betekent STT?
STT staat voor speech-to-text. Het zet gesproken audio om in geschreven tekst, zodat het taalmodel kan begrijpen wat de beller heeft gezegd. Dit wordt ook wel ASR of transcriptie genoemd.
Wat is het verschil tussen TTS en STT?
STT luistert en TTS spreekt. STT verwerkt audio tot tekst. TTS verwerkt tekst tot audio. Een voice agent heeft beide nodig, of een speech-to-speech-model dat beide taken combineert.
Hebben AI-telefoonagenten altijd aparte STT en TTS nodig?
Nee. Cascaded agents gebruiken afzonderlijke STT-, LLM- en TTS-stappen. Speech-to-speech-modellen verwerken audio-in en audio-uit in één model. Beide benaderingen bestaan, waarbij de cascaded-methode meer controle en transcripties biedt.
Wat is belangrijker voor de gesprekskwaliteit, STT of TTS?
Beide, maar op verschillende manieren. Een zwakke STT leidt tot verkeerde antwoorden omdat de agent de beller verkeerd verstaat. Een zwakke TTS leidt tot gesprekken die robotachtig of moeilijk verstaanbaar klinken. Test beide met je eigen gesprekken.
Waarom verstaat mijn voice agent namen en getallen verkeerd?
Telefoonaudio is smalbandig en bevat ruis, en namen zijn zeldzame woorden. Gebruik een aangepaste woordenlijst, laat de agent gegevens ter bevestiging spellen en gebruik een STT-model dat is getest op jouw taal en accenten.
Hoe kan ik de agent sneller laten antwoorden?
Gebruik streaming STT en TTS, optimaliseer de endpointing, houd prompts en toolresultaten kort en kies aanbieders die zich dicht bij je telefonie-regio bevinden.
Is het legaal om een gekloonde of synthetische stem te gebruiken in gesprekken?
Je hebt toestemming nodig voor elke gekloonde stem en bellers moeten weten dat ze met een AI spreken. Controleer de AVG en de EU AI Act voor jouw situatie en win juridisch advies in voor gereguleerde sectoren.
Kan ik later nog van STT- of TTS-aanbieder wisselen in Famulor?
Ja. Je kunt de stem- en transcriptie-instellingen van een assistent wijzigen en je testgesprekken opnieuw uitvoeren zonder de agent opnieuw te hoeven bouwen.

Auteur bij Famulor