Resumir contenido con:




TTS y STT explicados: las dos mitades de todo agente de voz
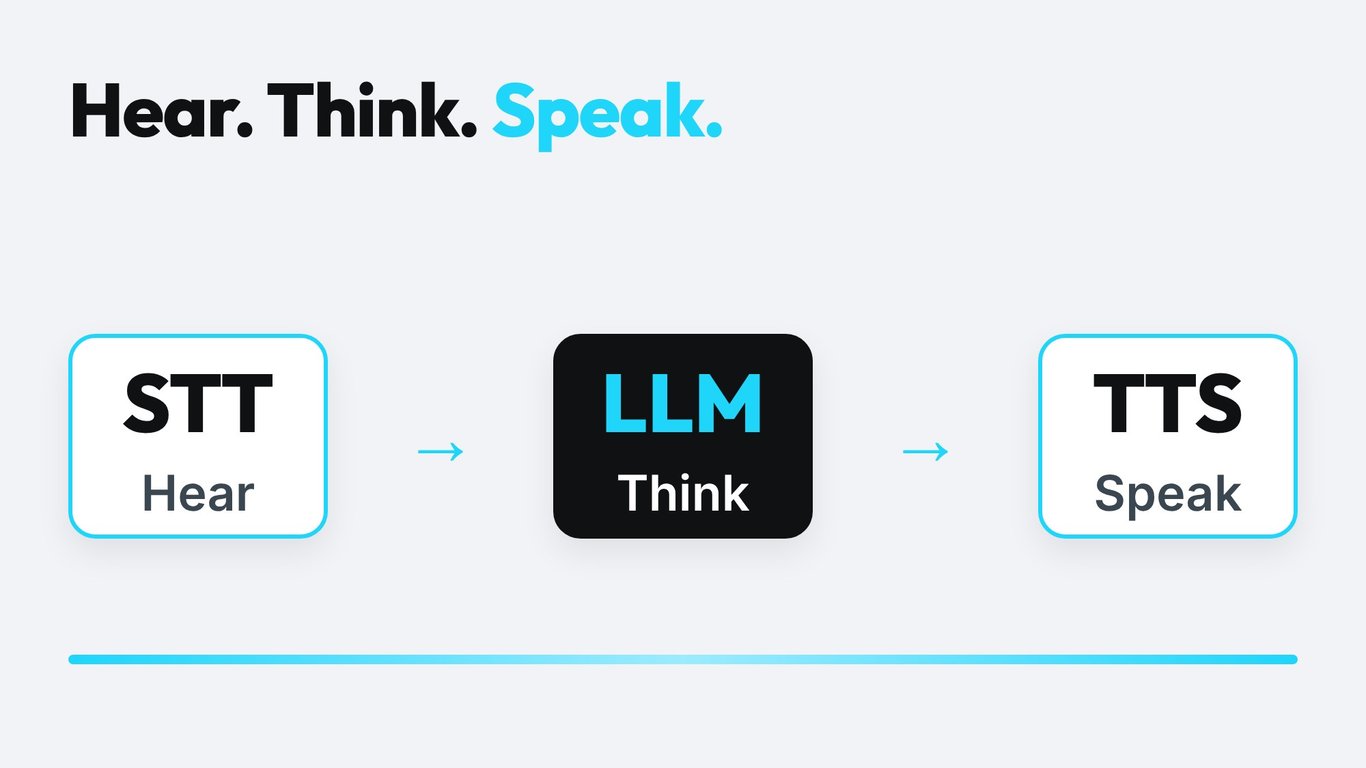
Si has buscado "TTS" o "significado de STT" y has llegado hasta aquí, la respuesta corta es esta: STT es speech-to-text (conversión de voz a texto) (el agente escucha) y TTS es text-to-speech (conversión de texto a voz) (el agente habla). Todo agente telefónico de IA al que llames se basa en estas dos funciones, con un modelo de lenguaje en medio que decide qué decir. Esta guía explica qué hace cada parte, dónde fallan las llamadas y cómo elegir la configuración adecuada para tu negocio.
¿Qué significan TTS y STT?
STT (speech-to-text) también se denomina reconocimiento automático del habla (ASR) o transcripción. Toma un flujo de audio y devuelve palabras. En un agente de voz, se ejecuta continuamente mientras el interlocutor habla y envía texto parcial al siguiente paso.
TTS (text-to-speech) es la síntesis del habla. Toma el texto que escribió el modelo de lenguaje y produce audio con una voz, idioma y estilo elegidos. En un agente de voz, empieza a hablar antes de que la frase completa haya terminado, para que el interlocutor no tenga que esperar.
A menudo se confunden ambos con la clonación de voz, los cambiadores de voz o las "voces de IA" en general. Esas son funciones integradas sobre el TTS. El STT no tiene voz propia: solo escucha.
| Término | Nombre completo | Entrada | Salida | Función en un agente de voz |
|---|---|---|---|---|
| STT | Speech-to-text (ASR) | Audio del interlocutor | Texto | Entender lo que se dijo |
| LLM | Modelo de lenguaje extenso | Texto y contexto | Texto | Decidir la respuesta y llamar a herramientas |
| TTS | Text-to-speech | Texto | Audio | Decir la respuesta con una voz natural |
| S2S | Speech-to-speech (voz a voz) | Audio del interlocutor | Audio | Hacer los tres pasos en un solo modelo |
Cómo fluye una llamada telefónica a través de STT, LLM y TTS
Imagina una clínica dental con cuatro gabinetes. Un paciente llama y dice: "Necesito cambiar mi limpieza del martes al jueves". Esto es lo que sucede en aproximadamente un segundo:
- La red telefónica entrega el audio a la plataforma del agente.
- El STT transmite el audio a texto mientras el paciente aún está hablando.
- Una comprobación de finalización (endpointing) decide que el paciente ha terminado la frase.
- El modelo de lenguaje lee el texto, consulta el calendario a través de una herramienta y escribe una respuesta.
- El TTS convierte las primeras palabras de la respuesta en audio y las transmite de vuelta.
- El paciente escucha la respuesta y puede interrumpir en cualquier momento, lo que cancela el flujo de TTS y vuelve al paso 2.
Cada paso añade retraso y cada paso puede fallar a su manera. El STT puede entender mal un nombre. El modelo puede elegir la opción incorrecta. El TTS puede pronunciar mal una calle. Saber qué parte falló es el primer paso para solucionarlo. Los registros de llamadas de Famulor muestran la transcripción junto a la respuesta del agente, para que puedas ver si el problema fue de audición, razonamiento o habla.
Por qué el audio telefónico es más difícil que un podcast
La mayoría de los modelos de voz se demuestran con audio de estudio limpio. Las llamadas telefónicas son diferentes. Las líneas telefónicas tradicionales utilizan el códec G.711 con una frecuencia de muestreo de 8 kHz, que corta las frecuencias altas. Las consonantes como "s", "f" y "z" se vuelven más difíciles de distinguir, que es precisamente donde fallan los nombres, números y direcciones de correo electrónico. El audio de banda ancha como G.722 utiliza 16 kHz y mantiene más detalle, pero solo si ambos extremos de la llamada lo admiten.
El gráfico muestra por qué un modelo que obtiene buenos resultados con audio de podcast puede tener dificultades en una llamada telefónica normal: recibe una fracción de la información. Cuando pruebes el STT, hazlo siempre con grabaciones de tu propia línea telefónica, con tus propios acentos, ruido de fondo y vocabulario.
El speech-to-text en detalle
Qué determina la calidad del STT en las llamadas
- Cobertura de acentos e idiomas: los dialectos alemanes, el alemán suizo y el cambio de código entre idiomas siguen siendo puntos débiles para muchos modelos.
- Vocabulario: nombres de productos, apellidos y términos médicos o legales. Muchos proveedores te permiten añadir sugerencias de palabras clave o vocabulario personalizado.
- Números y formatos: números de teléfono, IBAN, códigos postales y fechas. Un solo dígito incorrecto hace que una reserva no sirva.
- Gestión del ruido: coches, talleres, cocinas y altavoces.
- Comportamiento de streaming: qué tan rápido aparecen las palabras parciales y qué tan estables son.
La tasa de error de palabras no lo es todo
La tasa de error de palabras (WER) cuenta las palabras incorrectas, faltantes y adicionales frente a una transcripción de referencia. Es útil para comparar modelos, pero un WER bajo puede ocultar los errores que importan. Omitir la palabra "no" o confundir "15" con "50" cuenta igual que omitir "el". Para un agente de voz, la precisión de las entidades (nombres, números, fechas) suele ser la mejor medida. Cubrimos esto en detalle en nuestro artículo de referencia de STT.
Streaming frente a procesamiento por lotes (batch)
El STT por lotes espera a la grabación completa y devuelve una transcripción pulida. Es perfecto para resúmenes de llamadas y revisión de cumplimiento. El STT en streaming devuelve las palabras a medida que se pronuncian, lo cual es la única opción para una conversación en vivo. Muchos proveedores ofrecen ambos, y el streaming suele sacrificar un poco de precisión por velocidad.
Endpointing e interrupciones
El endpointing decide cuándo el interlocutor ha terminado de hablar. Si es demasiado pronto, el agente corta a las personas a mitad de la frase. Si es demasiado tarde, cada respuesta parece lenta. Los buenos agentes combinan la detección de silencio con el significado de la frase: "Mi número es 0151..." claramente no ha terminado, incluso después de una pausa. El barge-in (permitir que el interlocutor interrumpa) depende de la misma lógica.
El text-to-speech en detalle
Qué hace que una voz TTS suene bien
- Naturalidad: ritmo, respiración y énfasis que coincidan con la forma en que habla la gente.
- Control de prosodia: preguntas que suben de tono, pausas cortas antes de datos importantes, tono tranquilo para malas noticias.
- Pronunciación: nombres de marcas, nombres de calles, abreviaturas y palabras en idiomas mixtos. Los diccionarios de pronunciación resuelven la mayor parte de esto.
- Tiempo hasta el primer audio: qué tan rápido llega la primera sílaba después de enviar el texto.
- Consistencia: la misma voz en la llamada 1 y en la 10.000.
Clonación de voz y consentimiento
Muchos proveedores de TTS ofrecen clonación a partir de una muestra corta. Solo clona voces de personas que hayan dado su consentimiento por escrito e informa a los interlocutores de que están hablando con una IA. En la UE, la transparencia sobre la interacción con IA es parte de la Ley de IA, y la grabación o el procesamiento de datos de voz entran dentro del RGPD. Nuestra guía del RGPD para agentes de voz con IA cubre los detalles.
Adaptar la voz al trabajo
Un negocio artesanal que recibe llamadas de emergencia necesita una voz tranquila y clara. Una recepción de hotel puede querer un tono más cálido. Un recordatorio de deuda necesita una voz neutral y educada. Escucha muestras en tu propio idioma, con tus propias frases, antes de decidir. La biblioteca de voces de Famulor te permite comparar voces entre proveedores.
Latencia: de dónde viene el retraso
Los interlocutores notan el silencio rápidamente. El retraso total es la suma de la red, el final del turno del interlocutor, el tiempo de pensamiento del modelo y el primer audio de la respuesta. Cada proveedor de STT y TTS contribuye a esa suma, por lo que escribimos una guía separada sobre qué tan rápido debe responder tu bot telefónico.
Formas prácticas de reducir el retraso sin perder calidad:
- Usa STT y TTS en streaming, nunca por lotes, para llamadas en vivo.
- Elige proveedores con servidores cercanos a tu operador de telefonía.
- Mantén los prompts y las salidas de herramientas breves para que el modelo responda más rápido.
- Usa frases de relleno cortas ("Un momento, consulto el calendario") mientras se ejecuta una herramienta.
- Ajusta el endpointing en lugar de añadir pausas fijas.
¿Arquitectura en cascada o speech-to-speech?
La configuración clásica encadena STT, LLM y TTS. Los modelos más nuevos de speech-to-speech (S2S) toman audio y dan audio en un solo modelo. Ambos tienen su lugar. Nuestro resumen de modelos speech-to-speech profundiza más.
| Criterio | Cascada (STT + LLM + TTS) | Speech-to-speech |
|---|---|---|
| Control sobre cada paso | Alto: intercambia cualquier parte | Menor: un modelo hace todo |
| Transcripción para registros y QA | Nativa | Necesita una transcripción separada |
| Elección de voz | Cientos de voces TTS | Limitado a las voces del modelo |
| Tono e interrupciones | Depende del ajuste | A menudo más natural |
| Llamada a herramientas y reglas | Maduro y predecible | Mejorando rápidamente |
| Depurar una mala llamada | Comprueba cada paso | Más difícil de aislar |
Para llamadas reguladas o de alto riesgo, como citas, pagos o reclamaciones, muchos equipos siguen prefiriendo la configuración en cascada porque cada paso es visible y reemplazable. Para casos de uso conversacionales casuales, el S2S puede sentirse más natural.
Cómo elegir proveedores de STT y TTS
Usa una tarjeta de puntuación corta y ponderada según tu caso de uso:
- Cobertura de idiomas y acentos para tus interlocutores reales.
- Precisión en entidades: nombres, números, fechas.
- Latencia de streaming para STT y tiempo hasta el primer audio para TTS.
- Calidad y control de voz para TTS.
- Gestión de datos: región, retención, entrenamiento con tus datos, DPA.
- Precio por minuto o por carácter según tu volumen de llamadas.
- Fiabilidad: tiempo de actividad y opciones de respaldo.
Escribimos guías paso a paso para ambos lados: cómo elegir un proveedor de STT y cómo elegir un proveedor de TTS. Famulor admite proveedores como Deepgram, Soniox, ElevenLabs y Cartesia, para que puedas probar varios con el mismo guion.
Cuánto cuestan el STT y el TTS en un agente de voz
Un minuto de agente de voz se compone de telefonía, STT, LLM y TTS. Los proveedores facturan en diferentes unidades: el STT suele ser por minuto o hora de audio, el TTS por carácter o por minuto de audio, los LLM por token. Compararlos es más fácil si conviertes todo al coste por minuto de llamada para tu propio patrón de llamadas. Las respuestas largas del agente cuestan más TTS que las cortas, y los monólogos largos del interlocutor cuestan más STT.
Con Famulor, verás un precio por minuto en lugar de facturas separadas de distintos proveedores. El pago por uso comienza en 0,15 € por minuto, y planes como el Plus incluyen 100 minutos, con minutos adicionales a 0,12 €. Consulta los planes actuales en la página de precios.
Calcula tu ROI automatizando llamadas
Descubre cuánto podrías ahorrar al usar voice agents con IA.
Resultado ROI
ROI 0%
Sin tarjeta de crédito
Tres ejemplos: ¿Qué configuración se adapta a cada trabajo?
Reserva de citas para una clínica dental
Los nombres y las fechas son fundamentales. Elige un sistema STT con una alta precisión en entidades y un vocabulario personalizado para tratamientos, además de una voz TTS tranquila y clara. Añade una confirmación de lectura: "Jueves a las 10:30, ¿es correcto?"
Línea de atención fuera de horario para una empresa de fontanería
Quienes llaman suelen estar estresados y a menudo en lugares ruidosos. Prioriza un STT robusto frente al ruido y una voz TTS breve y tranquilizadora. Mantén las respuestas cortas y solicita primero la dirección y el nivel de urgencia.
Recordatorios de salida para un gimnasio
Las llamadas salientes comienzan con un saludo rápido, por lo que el tiempo de respuesta del TTS es crucial. El STT solo necesita captar respuestas afirmativas, negativas y algunas fechas. Una configuración de precio medio suele ser suficiente.
Configuración de STT y TTS en Famulor
- Crea un asistente con el constructor de agentes de voz sin código.
- Elige el idioma y una voz, y escucha una muestra.
- Selecciona el modelo de transcripción que mejor se adapte a tu idioma y nivel de ruido.
- Añade sugerencias de pronunciación y vocabulario personalizado para tu marca y nombres de lugares.
- Realiza llamadas de prueba simuladas y reales, y luego lee las transcripciones.
- Cambia un ajuste a la vez y compara los resultados.
Comprueba los idiomas compatibles antes de decidirte por una voz.
Errores comunes
- Elegir una voz a partir de una demo de estudio y no probarla nunca en una línea telefónica.
- Juzgar el STT basándose únicamente en un número de precisión global.
- Ignorar la pronunciación del nombre de la empresa.
- Omitir la confirmación de lectura para números y fechas.
- Dejar que el agente hable en párrafos largos. Las frases cortas suenan mejor y consumen menos TTS.
Conclusión
El STT y el TTS son los oídos y la voz de tu agente telefónico de IA. Cuanto mejor se adapten a tus interlocutores, idioma y caso de uso, más llamadas finalizará el agente sin intervención humana. Prueba ambos con grabaciones reales, mantén la latencia baja mediante streaming y cambia solo una cosa a la vez. ¿Listo para escuchar la diferencia con tu propio guion? Empieza con la demo en vivo a continuación y luego crea tu primer asistente en Famulor.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.

Agente IA de demo
Representante de Famulor
Preguntas frecuentes
¿Qué significa TTS?
TTS son las siglas de text-to-speech (texto a voz). Convierte texto escrito en audio hablado y, en un agente de voz, genera las respuestas habladas del agente.
¿Qué significa STT?
STT son las siglas de speech-to-text (voz a texto). Convierte audio hablado en texto escrito para que el modelo de lenguaje pueda entender lo que dijo quien llama. También se denomina ASR o transcripción.
¿Cuál es la diferencia entre TTS y STT?
El STT escucha y el TTS habla. El STT recibe audio y devuelve texto. El TTS recibe texto y devuelve audio. Un agente de voz necesita ambos, o un modelo de voz a voz que cubra ambas funciones.
¿Los agentes telefónicos de IA siempre necesitan STT y TTS por separado?
No. Los agentes en cascada utilizan pasos separados de STT, LLM y TTS. Los modelos de voz a voz gestionan la entrada y salida de audio en un solo modelo. Ambos enfoques existen, y el de cascada ofrece más control y transcripciones.
¿Qué es más importante para la calidad de la llamada, el STT o el TTS?
Ambos, pero de formas distintas. Un STT débil provoca respuestas erróneas porque el agente no entendió bien. Un TTS débil hace que las llamadas suenen robóticas o difíciles de entender. Prueba ambos en tus propias llamadas.
¿Por qué mi agente de voz no entiende bien los nombres y números?
El audio telefónico es estrecho y ruidoso, y los nombres son palabras poco frecuentes. Utiliza vocabulario personalizado, confirmaciones deletreadas y un modelo STT probado en tu idioma y acentos.
¿Cómo puedo hacer que el agente responda más rápido?
Utiliza STT y TTS en streaming, ajusta el endpointing, mantén los prompts y los resultados de las herramientas breves, y elige proveedores cercanos a tu región de telefonía.
¿Es legal utilizar una voz clonada o sintética en las llamadas?
Necesitas consentimiento para cualquier voz clonada, y quienes llaman deben saber que están hablando con una IA. Consulta el RGPD y la Ley de IA de la UE para tu caso y obtén asesoramiento legal para sectores regulados.
¿Puedo cambiar de proveedor de STT o TTS más adelante en Famulor?
Sí. Puedes cambiar los ajustes de voz y transcripción de un asistente y volver a realizar tus llamadas de prueba sin tener que reconstruir el agente.

Autor en Famulor