Inhalt zusammenfassen mit:




TTS und STT erklärt: Die zwei Hälften jedes Voice Agents
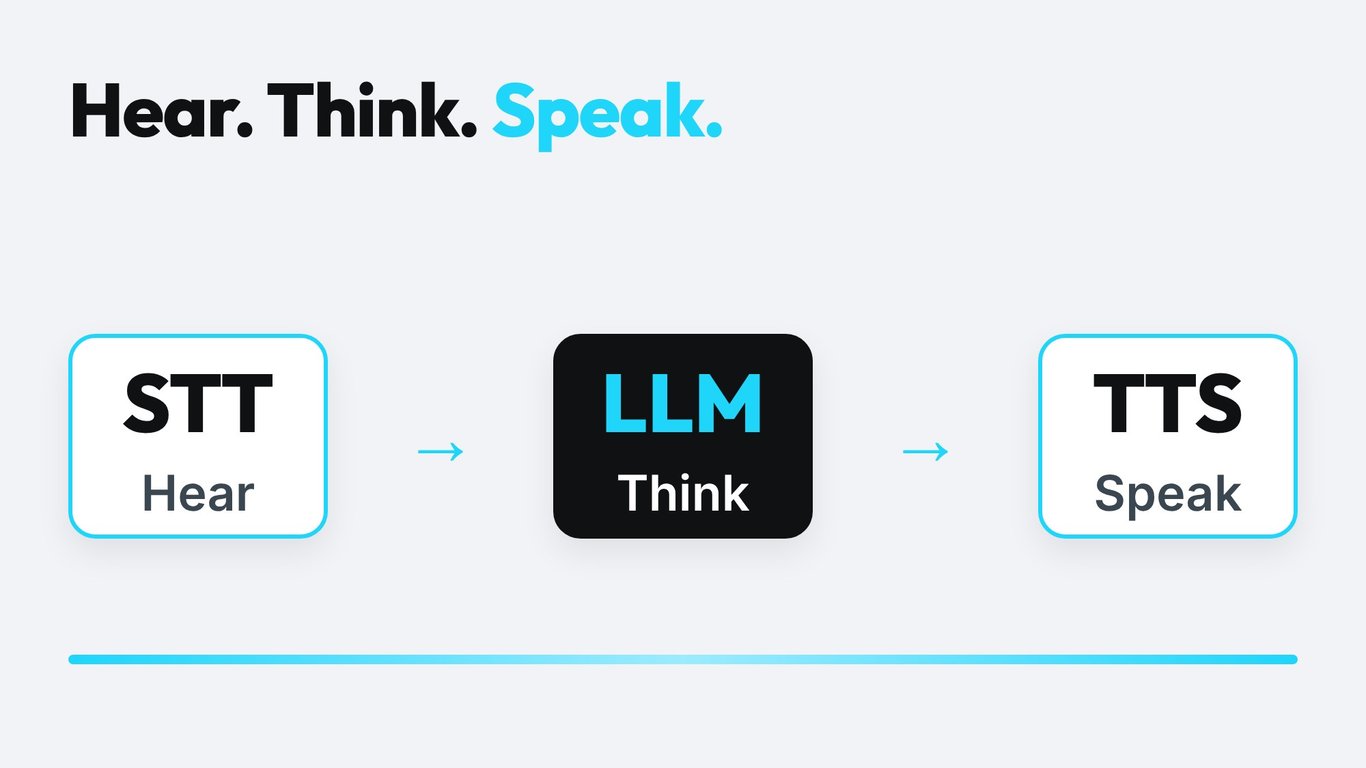
Du hast nach "TTS" oder "STT Bedeutung" gesucht? Kurz gesagt: STT ist Speech-to-Text (der Agent hört zu) und TTS ist Text-to-Speech (der Agent spricht). Jeder KI-Telefonassistent basiert auf diesen zwei Aufgaben, dazwischen entscheidet ein Sprachmodell, was gesagt wird. Dieser Ratgeber zeigt, was jeder Teil macht, wo Anrufe scheitern und wie du die passende Kombination für dein Unternehmen findest.
Was bedeuten TTS und STT?
STT (Speech-to-Text) heißt auch automatische Spracherkennung (ASR) oder Transkription. Es nimmt einen Audiostrom und liefert Wörter. Im Voice Agent läuft STT dauerhaft, solange der Anrufer spricht, und gibt Teiltexte an den nächsten Schritt weiter.
TTS (Text-to-Speech) ist Sprachsynthese. Es nimmt den Text des Sprachmodells und erzeugt Audio in einer gewählten Stimme, Sprache und Sprechweise. Im Voice Agent beginnt TTS zu sprechen, bevor der ganze Satz fertig ist, damit der Anrufer nicht wartet.
Oft werden beide mit Stimmklonen, Stimmverzerrern oder "KI-Stimmen" allgemein verwechselt. Das sind Funktionen, die auf TTS aufbauen. STT hat keine eigene Stimme: Es hört nur zu.
| Begriff | Langform | Eingang | Ausgang | Aufgabe im Voice Agent |
|---|---|---|---|---|
| STT | Speech-to-Text (ASR) | Audio des Anrufers | Text | Verstehen, was gesagt wurde |
| LLM | Großes Sprachmodell | Text und Kontext | Text | Antwort festlegen und Tools aufrufen |
| TTS | Text-to-Speech | Text | Audio | Antwort natürlich aussprechen |
| S2S | Speech-to-Speech | Audio des Anrufers | Audio | Alle drei Schritte in einem Modell |
So läuft ein Anruf durch STT, LLM und TTS
Nehmen wir eine Zahnarztpraxis mit vier Behandlungsstühlen. Eine Patientin ruft an und sagt: "Ich möchte meine Zahnreinigung von Dienstag auf Donnerstag verschieben." In etwa einer Sekunde passiert Folgendes:
- Das Telefonnetz liefert das Audio an die Agenten-Plattform.
- STT wandelt das Audio in Text um, noch während die Patientin spricht.
- Die Satzende-Erkennung (Endpointing) entscheidet, dass der Satz fertig ist.
- Das Sprachmodell liest den Text, prüft per Tool den Kalender und schreibt die Antwort.
- TTS wandelt die ersten Worte der Antwort in Audio um und streamt sie zurück.
- Die Patientin hört die Antwort und kann jederzeit unterbrechen. Das stoppt den TTS-Strom und startet wieder bei Schritt 2.
Jeder Schritt kostet Zeit und kann auf eigene Weise scheitern. STT versteht einen Namen falsch. Das Modell wählt den falschen Termin. TTS spricht eine Straße falsch aus. Wer weiß, welcher Teil versagt hat, kann gezielt nachbessern. Die Anruf-Protokolle in Famulor zeigen das Transkript neben der Antwort des Agenten. So siehst du, ob das Problem beim Hören, Denken oder Sprechen lag.
Warum Telefonaudio schwieriger ist als ein Podcast
Die meisten Sprachmodelle werden mit sauberem Studio-Audio vorgeführt. Telefonate sind anders. Klassische Telefonleitungen nutzen den Codec G.711 mit 8 kHz Abtastrate, der hohe Frequenzen abschneidet. Konsonanten wie "s", "f" und "th" lassen sich schwerer unterscheiden. Genau dort scheitern Namen, Zahlen und E-Mail-Adressen. Breitband-Audio wie G.722 nutzt 16 kHz und behält mehr Details, aber nur, wenn beide Seiten es unterstützen.
Das Diagramm zeigt, warum ein Modell mit guten Podcast-Werten am normalen Telefon trotzdem straucheln kann: Es bekommt nur einen Bruchteil der Information. Teste STT deshalb immer mit Aufnahmen deiner eigenen Telefonleitung, mit deinen Dialekten, Hintergrundgeräuschen und Fachwörtern.
Speech-to-Text im Detail
Was die STT-Qualität bei Anrufen bestimmt
- Akzente und Sprachabdeckung: Dialekte, Schweizerdeutsch und Sprachwechsel mitten im Satz sind bei vielen Modellen noch Schwachstellen.
- Vokabular: Produktnamen, Nachnamen, medizinische oder juristische Begriffe. Viele Anbieter erlauben Stichwort-Hinweise oder eigene Wortlisten.
- Zahlen und Formate: Telefonnummern, IBANs, Postleitzahlen und Daten. Eine falsche Ziffer macht eine Buchung wertlos.
- Geräuschunterdrückung: Auto, Werkstatt, Küche, Freisprecheinrichtung.
- Streaming-Verhalten: Wie schnell Teilwörter erscheinen und wie stabil sie sind.
Die Wortfehlerrate ist nicht alles
Die Wortfehlerrate (WER) zählt falsche, fehlende und überflüssige Wörter gegen ein Referenztranskript. Sie hilft beim Modellvergleich, kann aber die wichtigen Fehler verstecken. Ein fehlendes "nicht" oder die Verwechslung von "15" und "50" zählt genauso wie ein fehlendes "der". Für einen Voice Agent ist die Genauigkeit bei Entitäten (Namen, Zahlen, Daten) oft das bessere Maß. Mehr dazu in unserem STT-Benchmark-Artikel.
Streaming oder Batch
Batch-STT wartet auf die komplette Aufnahme und liefert ein sauberes Transkript. Das passt für Zusammenfassungen und Qualitätsprüfung. Streaming-STT liefert Wörter, während sie gesprochen werden. Für Live-Gespräche gibt es nur diese Variante. Viele Anbieter haben beides, wobei Streaming oft etwas Genauigkeit gegen Tempo tauscht.
Endpointing und Unterbrechungen
Das Endpointing entscheidet, wann der Anrufer fertig gesprochen hat. Zu früh, und der Agent fällt ins Wort. Zu spät, und jede Antwort wirkt träge. Gute Agenten kombinieren Stille-Erkennung mit dem Sinn des Satzes: "Meine Nummer ist 0151..." ist auch nach einer Pause klar nicht fertig. Barge-in (Unterbrechen durch den Anrufer) beruht auf derselben Logik.
Text-to-Speech im Detail
Was eine TTS-Stimme gut klingen lässt
- Natürlichkeit: Rhythmus, Atmung und Betonung wie beim echten Sprechen.
- Prosodie-Kontrolle: Fragen mit steigender Stimme, kurze Pausen vor wichtigen Fakten, ruhiger Ton bei schlechten Nachrichten.
- Aussprache: Markennamen, Straßennamen, Abkürzungen und Wörter aus mehreren Sprachen. Aussprache-Wörterbücher lösen das meiste.
- Zeit bis zum ersten Audio: Wie schnell nach dem Text die erste Silbe ankommt.
- Konstanz: Dieselbe Stimme bei Anruf 1 und Anruf 10.000.
Stimmklonen und Einwilligung
Viele TTS-Anbieter klonen Stimmen aus einer kurzen Probe. Klone nur Stimmen von Personen, die schriftlich zugestimmt haben, und sag Anrufern, dass sie mit einer KI sprechen. In der EU gehört Transparenz bei KI-Interaktion zum AI Act, und die Verarbeitung von Sprachdaten fällt unter die DSGVO. Details findest du in unserem DSGVO-Leitfaden für KI-Telefonassistenten.
Stimme zur Aufgabe wählen
Ein Handwerksbetrieb mit Notdienst braucht eine ruhige, klare Stimme. Eine Hotelrezeption darf wärmer klingen. Eine Zahlungserinnerung braucht einen neutralen, höflichen Ton. Höre Beispiele in deiner Sprache und mit deinen eigenen Sätzen, bevor du entscheidest. In der Famulor-Stimmenbibliothek vergleichst du Stimmen mehrerer Anbieter.
Latenz: Woher die Verzögerung kommt
Anrufer bemerken Stille schnell. Die Gesamtverzögerung ist die Summe aus Netzwerk, Ende des Redebeitrags, Denkzeit des Modells und erstem Audio der Antwort. Jeder STT- und TTS-Anbieter trägt dazu bei. Deshalb gibt es einen eigenen Ratgeber dazu, wie schnell dein Telefonbot antworten muss.
So senkst du die Verzögerung ohne Qualitätsverlust:
- Nutze bei Live-Anrufen immer Streaming-STT und Streaming-TTS, nie Batch.
- Wähle Anbieter mit Servern nahe an deinem Telefonie-Carrier.
- Halte Prompts und Tool-Antworten kurz, damit das Modell schneller antwortet.
- Setze kurze Überbrückungssätze ein ("Einen Moment, ich schaue in den Kalender"), während ein Tool läuft.
- Stelle das Endpointing ein, statt feste Pausen einzubauen.
Kaskade oder Speech-to-Speech?
Der klassische Aufbau verkettet STT, LLM und TTS. Neuere Speech-to-Speech-Modelle (S2S) nehmen Audio auf und geben Audio aus, in einem einzigen Modell. Beide Ansätze haben ihren Platz.
| Kriterium | Kaskade (STT + LLM + TTS) | Speech-to-Speech |
|---|---|---|
| Kontrolle über jeden Schritt | Hoch: jeder Teil austauschbar | Geringer: ein Modell macht alles |
| Transkript für Logs und QA | Von Haus aus da | Braucht eine separate Transkription |
| Stimmenauswahl | Hunderte TTS-Stimmen | Auf die Stimmen des Modells begrenzt |
| Tonfall und Unterbrechungen | Abhängig von der Feinabstimmung | Oft natürlicher |
| Tool-Aufrufe und Regeln | Ausgereift und vorhersehbar | Wird schnell besser |
| Fehlersuche bei schlechtem Anruf | Jeden Schritt prüfen | Schwerer einzugrenzen |
Bei regulierten oder folgenreichen Anrufen wie Terminen, Zahlungen oder Schadensmeldungen bevorzugen viele Teams weiter die Kaskade, weil jeder Schritt sichtbar und austauschbar ist. Für lockere, dialogorientierte Fälle kann S2S natürlicher wirken.
So wählst du STT- und TTS-Anbieter
Nutze eine kurze Bewertungsliste und gewichte sie nach deinem Anwendungsfall:
- Sprach- und Akzentabdeckung für deine echten Anrufer.
- Genauigkeit bei Entitäten: Namen, Zahlen, Daten.
- Streaming-Latenz bei STT und Zeit bis zum ersten Audio bei TTS.
- Stimmqualität und Steuerung bei TTS.
- Datenverarbeitung: Region, Speicherdauer, Training mit deinen Daten, AVV.
- Preis pro Minute oder Zeichen bei deinem Anrufvolumen.
- Zuverlässigkeit: Verfügbarkeit und Ausweichoptionen.
Für die Auswahl der Spracherkennung gibt es eine Schritt-für-Schritt-Anleitung: STT-Anbieter auswählen. Famulor unterstützt Anbieter wie Deepgram, Soniox, ElevenLabs und Cartesia. So testest du mehrere mit demselben Skript.
Was STT und TTS im Voice Agent kosten
Eine Agenten-Minute setzt sich aus Telefonie, STT, LLM und TTS zusammen. Anbieter rechnen in verschiedenen Einheiten ab: STT meist pro Audiominute oder -stunde, TTS pro Zeichen oder Audiominute, LLMs pro Token. Der Vergleich gelingt leichter, wenn du alles auf Kosten pro Gesprächsminute für dein Anrufmuster umrechnest. Lange Agenten-Antworten kosten mehr TTS, lange Monologe der Anrufer mehr STT.
Bei Famulor siehst du einen Preis pro Minute statt einzelner Anbieter-Rechnungen. Pay-as-you-go startet bei 0,15 € pro Minute, Pläne wie Plus enthalten 100 Minuten, Zusatzminuten kosten 0,12 €. Die aktuellen Tarife findest du auf der Preisseite.
Berechne deinen ROI durch automatisierte Anrufe
Erfahre, wie viel du durch KI-gesteuerte Voice Agents jeden Monat sparen kannst.
ROI Ergebnis
ROI 0%
Ohne Kreditkarte
Drei Beispiele: Welcher Aufbau passt wozu?
Terminbuchung in einer Zahnarztpraxis
Namen und Daten sind entscheidend. Wähle ein STT mit starker Entitäten-Genauigkeit und eigenem Vokabular für Behandlungen sowie eine ruhige, klare TTS-Stimme. Ergänze eine Rückfrage: "Donnerstag um 10:30 Uhr, stimmt das?"
Notdienst-Hotline eines Sanitärbetriebs
Anrufer sind gestresst und oft an lauten Orten. Setze auf geräuschrobustes STT und eine kurze, beruhigende TTS-Stimme. Halte Antworten knapp und frage zuerst nach Adresse und Dringlichkeit.
Outbound-Erinnerungen für ein Fitnessstudio
Ausgehende Anrufe beginnen mit einer schnellen Begrüßung, daher zählt die Zeit bis zum ersten TTS-Audio. STT muss meist nur Ja, Nein und ein paar Daten erkennen. Ein Stack im mittleren Preisbereich reicht oft aus.
STT und TTS in Famulor einrichten
- Lege einen Assistenten mit dem No-Code-Voice-Agent-Builder an.
- Wähle Sprache und Stimme und höre eine Probe an.
- Wähle das Transkriptionsmodell, das zu Sprache und Geräuschpegel passt.
- Ergänze Aussprache-Hinweise und eigenes Vokabular für Marken- und Ortsnamen.
- Starte simulierte und echte Testanrufe und lies die Transkripte.
- Ändere jeweils eine Einstellung und vergleiche die Ergebnisse.
Prüfe vor der Stimmenwahl die unterstützten Sprachen deines Anbieters.
Häufige Fehler
- Eine Stimme nach der Studio-Demo wählen und nie am Telefon testen.
- STT an einer einzigen Gesamtgenauigkeit messen.
- Die Aussprache des Firmennamens ignorieren.
- Die Rückfrage bei Zahlen und Daten weglassen.
- Den Agenten in langen Absätzen sprechen lassen. Kurze Sätze klingen besser und kosten weniger TTS.
Fazit
STT und TTS sind Ohren und Stimme deines KI-Telefonassistenten. Je besser sie zu deinen Anrufern, deiner Sprache und deinem Anwendungsfall passen, desto mehr Anrufe löst der Agent ohne Mitarbeiter. Teste beide mit echten Aufnahmen, halte die Latenz mit Streaming niedrig und ändere immer nur eine Sache. Du willst den Unterschied mit deinem eigenen Skript hören? Starte mit der Live-Demo unten und baue dann deinen ersten Assistenten in Famulor.
Teste unseren KI-Assistenten
Erlebe selbst, wie natürlich unser KI-Telefonassistent klingt.
Gib deine Daten ein und erhalte in wenigen Sekunden einen Anruf von unserem KI-Agenten.
Der Agent ist darauf trainiert, über Famulor-Services zu sprechen und Termine zu vereinbaren.

Demo KI-Agent
Famulor Mitarbeiter
FAQ
Was bedeutet TTS?
TTS steht für Text-to-Speech. Es wandelt geschriebenen Text in gesprochenes Audio um. Im Voice Agent erzeugt es die gesprochenen Antworten.
Was bedeutet STT?
STT steht für Speech-to-Text. Es wandelt gesprochenes Audio in Text um, damit das Sprachmodell versteht, was der Anrufer gesagt hat. Man nennt es auch ASR oder Transkription.
Was ist der Unterschied zwischen TTS und STT?
STT hört zu, TTS spricht. STT nimmt Audio und liefert Text. TTS nimmt Text und liefert Audio. Ein Voice Agent braucht beides oder ein Speech-to-Speech-Modell, das beides abdeckt.
Brauchen KI-Telefonassistenten immer getrenntes STT und TTS?
Nein. Kaskaden-Agenten nutzen getrennte Schritte für STT, LLM und TTS. Speech-to-Speech-Modelle verarbeiten Audio rein und Audio raus in einem Modell. Die Kaskade bietet mehr Kontrolle und Transkripte.
Was zählt mehr für die Anrufqualität, STT oder TTS?
Beides, aber unterschiedlich. Schwaches STT führt zu falschen Antworten, weil der Agent falsch verstanden hat. Schwaches TTS führt zu Anrufen, die roboterhaft klingen oder schwer zu verstehen sind. Teste beides an deinen eigenen Anrufen.
Warum versteht mein Voice Agent Namen und Zahlen falsch?
Telefonaudio ist schmalbandig und verrauscht, und Namen sind seltene Wörter. Nutze eigenes Vokabular, Rückfragen zur Bestätigung und ein STT-Modell, das mit deiner Sprache und deinen Akzenten getestet wurde.
Wie antwortet mein Agent schneller?
Nutze Streaming-STT und -TTS, stelle das Endpointing ein, halte Prompts und Tool-Ergebnisse kurz und wähle Anbieter nahe an deiner Telefonie-Region.
Ist eine geklonte oder synthetische Stimme am Telefon erlaubt?
Für jede geklonte Stimme brauchst du eine Einwilligung, und Anrufer sollten wissen, dass sie mit einer KI sprechen. Prüfe DSGVO und AI Act für deinen Fall und hole in regulierten Branchen Rechtsrat ein.
Kann ich in Famulor später den STT- oder TTS-Anbieter wechseln?
Ja. Du änderst Stimme und Transkription eines Assistenten und wiederholst deine Testanrufe, ohne den Agenten neu zu bauen.

Autor bei Famulor