Résumer le contenu avec:




TTS et STT : les deux piliers de tout agent vocal
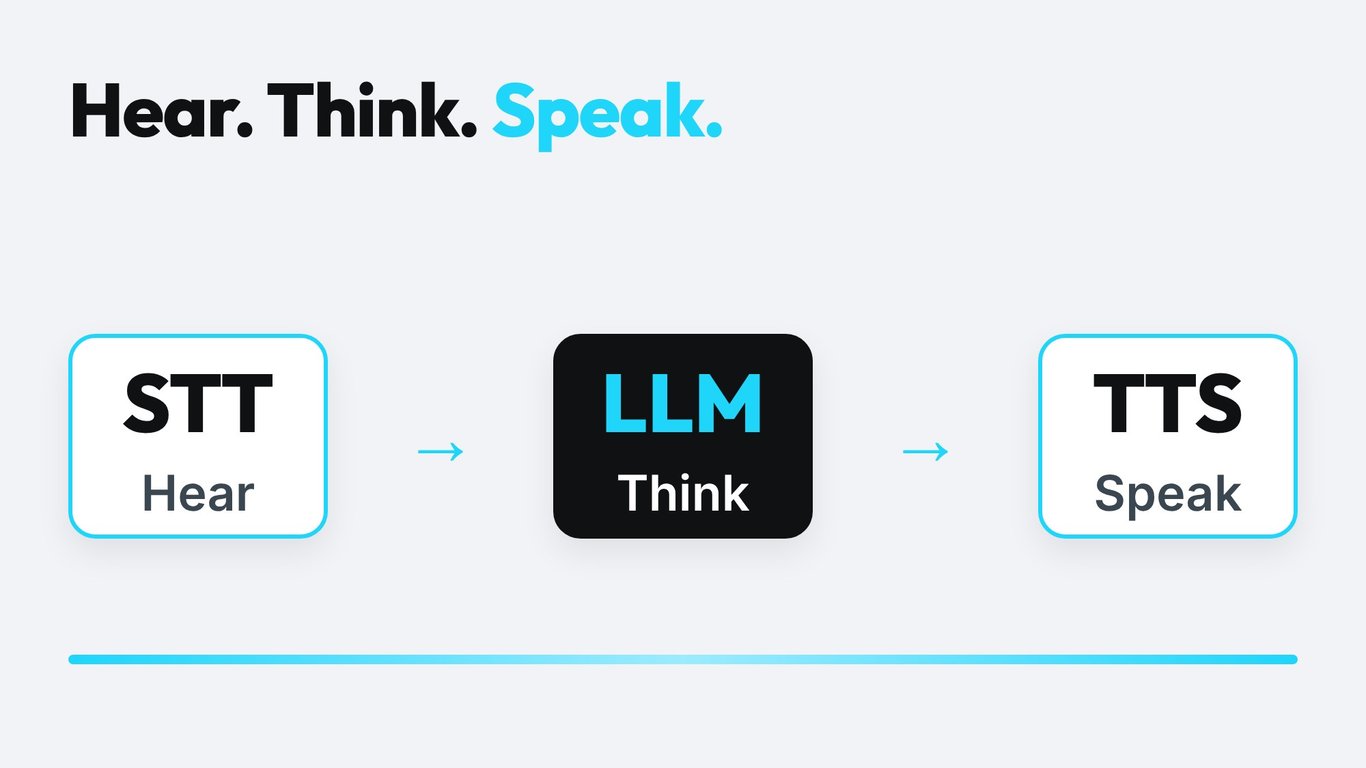
Si vous avez cherché la définition de "TTS" ou "STT" et que vous avez atterri ici, voici la réponse courte : le STT est la conversion de la parole en texte (speech-to-text) (l'agent écoute) et le TTS est la conversion du texte en parole (text-to-speech) (l'agent parle). Chaque agent téléphonique IA que vous appelez repose sur ces deux fonctions, avec un modèle de langage au centre qui décide quoi dire. Ce guide explique le rôle de chaque partie, les points de défaillance courants et comment choisir la configuration adaptée à votre entreprise.
Que signifient TTS et STT ?
Le STT (speech-to-text) est aussi appelé reconnaissance automatique de la parole (ASR) ou transcription. Il traite un flux audio et renvoie des mots. Dans un agent vocal, il fonctionne en continu pendant que l'appelant parle et envoie du texte partiel à l'étape suivante.
Le TTS (text-to-speech) est la synthèse vocale. Il prend le texte rédigé par le modèle de langage et produit un audio avec une voix, une langue et un style choisis. Dans un agent vocal, il commence à parler avant que la phrase entière ne soit terminée, afin que l'appelant n'attende pas.
Ces deux technologies sont souvent confondues avec le clonage vocal, les changeurs de voix ou les "voix IA" en général. Ce sont des fonctionnalités construites au-dessus du TTS. Le STT n'a pas de voix propre : il ne fait qu'écouter.
| Terme | Nom complet | Entrée | Sortie | Rôle dans un agent vocal |
|---|---|---|---|---|
| STT | Speech-to-text (ASR) | Audio de l'appelant | Texte | Comprendre ce qui a été dit |
| LLM | Large language model | Texte et contexte | Texte | Décider de la réponse et appeler des outils |
| TTS | Text-to-speech | Texte | Audio | Énoncer la réponse avec une voix naturelle |
| S2S | Speech-to-speech | Audio de l'appelant | Audio | Réaliser les trois étapes en un seul modèle |
Comment un appel téléphonique circule entre STT, LLM et TTS
Prenons un cabinet dentaire avec quatre fauteuils de soins. Un patient appelle et dit : "Je dois déplacer mon rendez-vous de nettoyage de mardi à jeudi." Voici ce qui se passe en environ une seconde :
- Le réseau téléphonique transmet l'audio à la plateforme de l'agent.
- Le STT transforme l'audio en texte pendant que le patient parle encore.
- Une vérification de fin de phrase (endpointing) détermine que le patient a terminé sa phrase.
- Le modèle de langage lit le texte, vérifie le calendrier via un outil et rédige une réponse.
- Le TTS transforme les premiers mots de la réponse en audio et les diffuse en retour.
- Le patient entend la réponse et peut interrompre à tout moment, ce qui annule le flux TTS et revient à l'étape 2.
Chaque étape ajoute un délai et peut échouer de manière spécifique. Le STT peut mal interpréter un nom. Le modèle peut choisir le mauvais créneau. Le TTS peut mal prononcer une rue. Identifier la partie défaillante est la première étape pour corriger le problème. Les journaux d'appels de Famulor affichent la transcription à côté de la réponse de l'agent, vous permettant de voir si le problème vient de l'écoute, de la réflexion ou de la parole.
Pourquoi l'audio téléphonique est plus complexe qu'un podcast
La plupart des modèles vocaux sont démontrés sur un audio de studio propre. Les appels téléphoniques sont différents. Les lignes téléphoniques traditionnelles utilisent le codec G.711 avec un taux d'échantillonnage de 8 kHz, ce qui coupe les hautes fréquences. Les consonnes comme "s", "f" et "th" deviennent plus difficiles à distinguer, ce qui est précisément là où les noms, les chiffres et les adresses e-mail posent problème. L'audio large bande comme le G.722 utilise 16 kHz et conserve plus de détails, mais seulement si les deux extrémités de l'appel le prennent en charge.
Le tableau montre pourquoi un modèle performant sur l'audio d'un podcast peut peiner sur un appel téléphonique classique : il reçoit une fraction de l'information. Lorsque vous testez le STT, testez-le toujours sur des enregistrements provenant de votre propre ligne téléphonique, avec vos propres accents, bruits de fond et vocabulaire.
Le Speech-to-Text en détail
Ce qui détermine la qualité du STT sur les appels
- Couverture des accents et des langues : les dialectes allemands, le suisse allemand et le passage d'une langue à l'autre restent des points faibles pour de nombreux modèles.
- Vocabulaire : noms de produits, noms de famille et termes médicaux ou juridiques. De nombreux fournisseurs permettent d'ajouter des indices de mots-clés ou un vocabulaire personnalisé.
- Chiffres et formats : numéros de téléphone, IBAN, codes postaux et dates. Un seul chiffre erroné rend une réservation inutile.
- Gestion du bruit : voitures, ateliers, cuisines et haut-parleurs.
- Comportement en streaming : rapidité d'apparition des mots partiels et leur stabilité.
Le taux d'erreur de mots ne dit pas tout
Le taux d'erreur de mots (WER) comptabilise les mots erronés, manquants et ajoutés par rapport à une transcription de référence. C'est utile pour comparer des modèles, mais un WER faible peut masquer les erreurs importantes. Omettre le mot "pas" ou confondre "15" et "50" compte autant que d'omettre "le". Pour un agent vocal, la précision des entités (noms, chiffres, dates) est souvent une meilleure mesure. Nous avons couvert cela en détail dans notre article sur les benchmarks STT.
Streaming versus traitement par lots (batch)
Le STT par lots attend l'enregistrement complet et renvoie une transcription polie. C'est parfait pour les résumés d'appels et la conformité. Le STT en streaming renvoie les mots au fur et à mesure, ce qui est la seule option pour une conversation en direct. De nombreux fournisseurs proposent les deux, le streaming sacrifiant généralement un peu de précision pour la vitesse.
Endpointing et interruptions
L'endpointing décide quand l'appelant a fini de parler. Trop tôt, et l'agent coupe la parole. Trop tard, et chaque réponse semble lente. Les bons agents combinent la détection de silence avec le sens de la phrase : "Mon numéro est le 0151..." n'est clairement pas terminé, même après une pause. Le barge-in (permettre à l'appelant d'interrompre) repose sur la même logique.
Le Text-to-Speech en détail
Ce qui rend une voix TTS naturelle
- Naturalité : rythme, respiration et accentuation qui correspondent à la parole humaine.
- Contrôle de la prosodie : questions qui montent, courtes pauses avant des faits importants, ton calme pour les mauvaises nouvelles.
- Prononciation : noms de marques, noms de rues, abréviations et mots multilingues. Les dictionnaires de prononciation résolvent la plupart de ces problèmes.
- Temps avant le premier audio : rapidité avec laquelle la première syllabe arrive après l'envoi du texte.
- Cohérence : la même voix sur l'appel 1 et l'appel 10 000.
Clonage vocal et consentement
De nombreux fournisseurs de TTS proposent le clonage à partir d'un court échantillon. Clonez uniquement les voix de personnes ayant donné leur consentement écrit et informez les appelants qu'ils parlent à une IA. Dans l'UE, la transparence sur l'interaction avec une IA fait partie de l'AI Act, et l'enregistrement ou le traitement de données vocales relève du RGPD. Notre guide RGPD pour les agents vocaux IA couvre les détails.
Adapter la voix à la tâche
Une entreprise artisanale qui reçoit des appels d'urgence a besoin d'une voix calme et claire. Une réception d'hôtel peut préférer un ton plus chaleureux. Un rappel de dette nécessite une voix neutre et polie. Écoutez des échantillons dans votre langue, avec vos propres phrases, avant de décider. La bibliothèque vocale Famulor vous permet de comparer les voix entre les fournisseurs.
Latence : d'où vient le délai ?
Les appelants remarquent rapidement le silence. Le délai total est la somme du réseau, de la fin du tour de parole de l'appelant, du temps de réflexion du modèle et du premier audio de la réponse. Chaque fournisseur de STT et de TTS contribue à cette somme, c'est pourquoi nous avons rédigé un guide séparé sur la vitesse de réponse nécessaire pour votre bot téléphonique.
Moyens pratiques de réduire le délai sans perdre en qualité :
- Utilisez le STT et le TTS en streaming, jamais en mode batch, pour les appels en direct.
- Choisissez des fournisseurs avec des serveurs proches de votre opérateur téléphonique.
- Gardez les prompts et les sorties d'outils courts pour que le modèle réponde plus vite.
- Utilisez de courtes phrases de remplissage ("Un instant, je vérifie le calendrier") pendant qu'un outil s'exécute.
- Ajustez l'endpointing au lieu d'ajouter des pauses fixes.
Pipeline en cascade ou Speech-to-Speech ?
La configuration classique enchaîne STT, LLM et TTS. Les nouveaux modèles de parole à parole (S2S) prennent l'audio en entrée et donnent l'audio en sortie dans un seul modèle. Les deux ont leur utilité. Notre aperçu des modèles S2S va plus loin.
| Critère | En cascade (STT + LLM + TTS) | Speech-to-speech |
|---|---|---|
| Contrôle sur chaque étape | Élevé : remplacez n'importe quelle partie | Plus faible : un seul modèle fait tout |
| Transcription pour logs et QA | Natif | Nécessite une transcription séparée |
| Choix de la voix | Des centaines de voix TTS | Limité aux voix du modèle |
| Ton et interruptions | Dépend du réglage | Souvent plus naturel |
| Appel d'outils et règles | Mature et prévisible | S'améliore rapidement |
| Débogage d'un mauvais appel | Vérifiez chaque étape | Plus difficile à isoler |
Pour les appels réglementés ou à enjeux élevés tels que les rendez-vous, les paiements ou les réclamations, de nombreuses équipes préfèrent encore la configuration en cascade car chaque étape est visible et remplaçable. Pour des cas d'usage conversationnels informels, le S2S peut sembler plus naturel.
Comment choisir vos fournisseurs STT et TTS
Utilisez une courte grille d'évaluation et pondérez-la selon votre cas d'usage :
- Couverture des langues et accents pour vos appelants réels.
- Précision sur les entités : noms, chiffres, dates.
- Latence de streaming pour le STT et temps avant le premier audio pour le TTS.
- Qualité et contrôle de la voix pour le TTS.
- Gestion des données : région, rétention, entraînement sur vos données, DPA.
- Prix par minute ou par caractère selon votre volume d'appels.
- Fiabilité : disponibilité et options de secours.
Nous avons rédigé des guides étape par étape pour les deux volets : comment choisir un fournisseur STT et comment choisir un fournisseur TTS. Famulor prend en charge des fournisseurs tels que Deepgram, Soniox, ElevenLabs et Cartesia, vous permettant de tester plusieurs solutions sur le même script.
Combien coûtent le STT et le TTS dans un agent vocal ?
Une minute d'agent vocal se compose de téléphonie, STT, LLM et TTS. Les fournisseurs facturent selon différentes unités : le STT généralement par minute ou heure d'audio, le TTS par caractère ou par minute d'audio, les LLM par jeton (token). Les comparer est plus simple si vous convertissez tout en coût par minute d'appel selon votre propre modèle d'appel. Les réponses longues de l'agent coûtent plus cher en TTS que les courtes, et les longs monologues de l'appelant coûtent plus cher en STT.
Avec Famulor, vous bénéficiez d'un tarif unique à la minute, sans factures séparées par fournisseur. La tarification à l'usage débute à 0,15 € par minute, et des forfaits comme Plus incluent 100 minutes, avec des minutes supplémentaires à 0,12 €. Consultez les offres actuelles sur la page de tarification.
Estimez votre ROI en automatisant vos appels
Voyez combien vous pourriez économiser chaque mois grâce aux voice agents IA.
Résultat ROI
ROI 0%
Sans carte bancaire
Trois exemples : quelle configuration pour quel usage ?
Prise de rendez-vous pour un cabinet dentaire
Les noms et les dates sont cruciaux. Choisissez un STT doté d'une excellente précision sur les entités et d'un vocabulaire personnalisé pour les traitements, associé à une voix TTS calme et claire. Ajoutez une confirmation orale : "Jeudi à 10h30, c'est bien cela ?"
Ligne d'urgence pour une entreprise de plomberie
Les appelants sont stressés et souvent dans des environnements bruyants. Privilégiez un STT robuste face au bruit et une voix TTS courte et rassurante. Soyez concis et commencez par recueillir l'adresse et le degré d'urgence.
Relances sortantes pour une salle de sport
Les appels sortants débutent par une salutation rapide, le temps de latence avant la première réponse TTS est donc déterminant. Le STT doit principalement détecter les oui, les non et quelques dates. Une solution de milieu de gamme suffit généralement.
Configurer le STT et le TTS dans Famulor
- Créez un assistant avec le constructeur d'agents vocaux no-code.
- Choisissez la langue et une voix, puis écoutez un échantillon.
- Sélectionnez le modèle de transcription adapté à votre langue et à votre environnement sonore.
- Ajoutez des indications de prononciation et un vocabulaire personnalisé pour votre marque et vos noms de lieux.
- Effectuez des appels de test simulés et réels, puis lisez les transcriptions.
- Modifiez un seul paramètre à la fois et comparez les résultats.
Vérifiez les langues prises en charge avant de choisir une voix.
Erreurs courantes
- Choisir une voix à partir d'une démo studio sans jamais la tester sur une ligne téléphonique.
- Juger le STT sur un seul chiffre de précision globale.
- Négliger la prononciation du nom de l'entreprise.
- Omettre la relecture de confirmation pour les chiffres et les dates.
- Laisser l'agent s'exprimer dans de longs paragraphes. Des phrases courtes sont plus agréables à l'oreille et coûtent moins cher en TTS.
Conclusion
Le STT et le TTS sont les oreilles et la voix de votre agent téléphonique IA. Plus ils sont adaptés à vos appelants, à votre langue et à votre cas d'usage, plus l'agent traitera d'appels sans intervention humaine. Testez les deux sur des enregistrements réels, maintenez une faible latence grâce au streaming et ne modifiez qu'un seul paramètre à la fois. Prêt à entendre la différence sur votre propre script ? Commencez par la démo en direct ci-dessous, puis créez votre premier assistant dans Famulor.
Essayez notre Assistant IA
Découvrez à quel point notre assistant téléphonique IA sonne naturel.
Entrez vos coordonnées et recevez un appel de notre agent IA en quelques secondes.
L'agent est formé pour parler des services Famulor et prendre des rendez-vous.

Agent IA de démo
Représentant Famulor
FAQ
Que signifie TTS ?
TTS signifie text-to-speech (synthèse vocale). Il convertit un texte écrit en audio parlé ; dans un agent vocal, il produit les réponses orales de l'agent.
Que signifie STT ?
STT signifie speech-to-text (reconnaissance vocale). Il convertit l'audio parlé en texte écrit afin que le modèle linguistique puisse comprendre ce que l'appelant a dit. On parle aussi d'ASR ou de transcription.
Quelle est la différence entre le TTS et le STT ?
Le STT écoute et le TTS parle. Le STT reçoit de l'audio et renvoie du texte. Le TTS reçoit du texte et renvoie de l'audio. Un agent vocal a besoin des deux, ou d'un modèle speech-to-speech qui couvre les deux fonctions.
Les agents téléphoniques IA ont-ils toujours besoin d'un STT et d'un TTS séparés ?
Non. Les agents en cascade utilisent des étapes distinctes de STT, LLM et TTS. Les modèles speech-to-speech traitent l'entrée et la sortie audio au sein d'un seul modèle. Les deux approches existent, mais celle en cascade offre un meilleur contrôle et des transcriptions plus précises.
Qu'est-ce qui compte le plus pour la qualité de l'appel, le STT ou le TTS ?
Les deux, mais de manières différentes. Un STT médiocre conduit à des réponses erronées car l'agent a mal compris. Un TTS médiocre rend les appels robotiques ou difficiles à comprendre. Testez les deux sur vos propres appels.
Pourquoi mon agent vocal comprend-il mal les noms et les chiffres ?
L'audio téléphonique est étroit et bruyant, et les noms sont des mots peu fréquents. Utilisez un vocabulaire personnalisé, des confirmations par épellation et un modèle STT testé sur votre langue et vos accents.
Comment puis-je accélérer les réponses de l'agent ?
Utilisez le STT et le TTS en streaming, ajustez l'endpointing, gardez les prompts et les résultats des outils courts et choisissez des fournisseurs proches de votre zone géographique de téléphonie.
Est-il légal d'utiliser une voix clonée ou synthétique lors d'appels ?
Vous devez obtenir le consentement pour toute voix clonée, et les appelants doivent savoir qu'ils s'adressent à une IA. Vérifiez le RGPD et l'IA Act européen pour votre situation et demandez un avis juridique pour les secteurs réglementés.
Puis-je changer de fournisseur de STT ou de TTS plus tard dans Famulor ?
Oui. Vous pouvez modifier les paramètres de voix et de transcription d'un assistant et relancer vos appels de test sans avoir à reconstruire l'agent.

Rédacteur chez Famulor